Zellbasierte Architektur: Blast Radius auf 1/N begrenzen
Zellbasierte Architektur erklärt: Partitionsschlüssel, schlanker Zellen-Router, Control Plane, Deployment-Wellen und die Mathematik des Blast Radius.
Am 18. November 2025 verdoppelte eine geänderte Datenbankberechtigung bei Cloudflare die Größe einer generierten Feature-Datei für Bot Management. Die Datei sprengte ein festes Limit im Proxy und wurde, so Cloudflare selbst, an alle Maschinen des Netzwerks verteilt. Ab 11:20 UTC scheiterte Kern-Traffic; die Hauptstörung dauerte bis 14:30 Uhr, vollständig erholt war alles um 17:06 Uhr. Einen Monat zuvor hatte eine latente Race Condition in der DNS-Automatisierung von DynamoDB AWS us-east-1 rund 15 Stunden lang gestört. Neun Tage danach, am 29. Oktober, löste eine versehentliche Mandantenkonfiguration in Azure Front Door eine weltweite Störung von mehr als acht Stunden aus.
Keiner dieser Vorfälle war ein Angriff. Es waren gewöhnliche Änderungen mit unbegrenztem Blast Radius. Ein Jahr später fragen uns Architekturgremien seltener „Wie bekommen wir mehr Neunen?" und häufiger „Wie stellen wir sicher, dass eine fehlerhafte Änderung nur einen Teil unserer Kunden trifft?". Die zellbasierte Architektur ist die am besten erprobte Antwort, die wir kennen. Dieser Beitrag richtet sich an alle, die entscheiden müssen, ob sie sie bauen: CTOs, Plattformverantwortliche, SRE-Leitungen und Architekten mandantenfähiger Systeme.
TL;DR / Das Wichtigste in Kürze
- Der Blast Radius wird zum Designparameter. Bei N gleich großen, unabhängigen Zellen trifft ein Fehler in einer Zelle 1/N der Mandanten. Zehn Zellen begrenzen ihn auf 10 Prozent, zwanzig auf 5 Prozent. Diese Zahl legen Sie fest, statt sie im Incident zu entdecken.
- Der Router kann immer noch alles mitreißen. Alle Zellen teilen ihn, also muss er die schlankstmögliche Schicht sein: keine Geschäftslogik, zwischengespeicherte Zuordnung, gestufte Änderungen.
- Die Control Plane bleibt außerhalb des Anfragepfads. Provisionierung und Migration dürfen stundenlang ausfallen, während die Zellen weiterarbeiten. Genau diese statische Stabilität ist der Gewinn.
- Zellen machen Deployments zu Experimenten. Wellenweise ausrollen, beginnend mit einer Zelle: Hier liegt in der Praxis der größte Nutzen, weil so viele Ausfälle mit einer Änderung beginnen.
- Es kostet echtes Geld und echtes Tooling. Microsoft schreibt offen, dass Stamps die Betriebskosten erheblich erhöhen. Zellen lohnen sich für Multi-Tenant-Plattformen, bei denen ein Totalausfall inakzeptabel ist, nicht für jede interne Anwendung.

Download: Editierbare draw.io-Datei · In diagrams.net öffnen · Diagrammdaten (CSV)
Warum das jetzt zählt
Seit 2023 haben sich drei Dinge verändert. Erstens ist das Muster dokumentiert. Im September 2023 veröffentlichte AWS im Rahmen des Well-Architected Framework den Leitfaden Reducing the Scope of Impact with Cell-Based Architecture, eine Vertiefung der Best Practice, Bulkhead-Architekturen zur Begrenzung der Auswirkungen einzusetzen. Das Azure Architecture Center beschreibt dieselbe Idee als Muster Deployment Stamps und nennt „Cell" ausdrücklich als Synonym.
Zweitens gibt es öffentliche Beispiele. Im August 2023 beschrieb Slack, wie es jede Availability Zone zu einer Zelle machte. Auslöser war ein Vorfall im Juni 2021, bei dem eine instabile Netzverbindung zwischen Zonen einen „Gray Failure" verursachte: Komponenten hatten unterschiedliche Sicht darauf, was gesund war. Das Ziel: eine betroffene Zone binnen fünf Minuten leeren, in Schritten von 1 Prozent. Im Dezember 2023 beschrieb Roblox den Umstieg auf Zellen mit je rund 1.400 Maschinen, zwei Jahre nach einem 73-stündigen Ausfall. In Spitzenzeiten liefen bereits über 70 Prozent des Backend-Traffics aus Zellen.
Drittens zeigen die Ausfälle seit Ende 2025 immer wieder dasselbe: Am meisten schmerzten die globalen Fehler. Cloudflares Post-Mortem vom Februar 2026 zeigt das Gegenbeispiel. Eine BYOIP-Konfigurationsänderung zog 25 Prozent der BYOIP-Präfixe von Kunden zurück, traf aber nicht alle BYOIP-Kunden, weil die Änderung schrittweise und nicht sofort für alle angewendet wurde. Zu den Folgemaßnahmen gehören kontrollierte Rollouts für jede Konfigurationsänderung, die ins Netz verteilt wird. Das ist Zellendenken als Maßnahmenpunkt. Die Seite der Anbieter beleuchten wir in unserer Analyse zu Control-Plane-Ausfällen bei Hyperscalern.
Die Architektur, Baustein für Baustein
Der AWS-Leitfaden definiert drei Komponenten. Eine Zelle ist ein vollständiger Workload mit allem, was er für den unabhängigen Betrieb braucht. Der Zellen-Router ist die „thinnest possible layer", die Anfragen an die richtige Zelle leitet und sonst nichts. Die Control Plane übernimmt die Verwaltung: Zellen anlegen und abbauen, Kunden zwischen Zellen migrieren. Unser Diagramm ergänzt zwei Dinge, die in der Praxis über Erfolg entscheiden: den Partitionsschlüssel und die Deployment-Wellen. Die Nummern entsprechen den Markierungen.
① Partitionsschlüssel: die richtige Granularität
Alles beginnt mit dem Schlüssel, der festlegt, welcher Zelle eine Anfrage gehört. AWS rät, ihn an der natürlichen Granularität des Dienstes auszurichten, also daran, wie sich der Workload mit möglichst wenig zellübergreifender Interaktion teilen lässt. Bei B2B-SaaS ist das meist die Mandanten-ID, bei IoT vielleicht die Geräteflotte, bei einer Zahlungsplattform der Händler.
Drei Fragen entscheiden, ob ein Schlüssel taugt:
- Steckt er in fast jeder Anfrage? Muss der Router erst eine Datenbank fragen, ist er nicht mehr schlank.
- Hält er den meisten Traffic in einer Zelle? Globale Suche oder mandantenübergreifende Berichte schneiden immer quer. Sie sollten die Ausnahme sein, und AWS empfiehlt, zellübergreifende Aufrufe über den Router zu führen, statt Zellen direkt miteinander sprechen zu lassen.
- Was passiert mit Ihrem größten Kunden? Die Mandanten-ID ist ein schwacher Schlüssel, wenn ein Mandant aus einer Zelle herauswachsen kann. AWS empfiehlt dafür eine zweite Schlüsseldimension, etwa Mandant plus Workspace.
AWS nennt vollständige Zuordnungstabellen, Bereichszuordnung, Modulo und Consistent Hashing, ausdrücklich ohne Empfehlung. Für B2B-Plattformen nehmen wir standardmäßig eine vollständige Zuordnungstabelle: Sie kostet einen Lookup, erlaubt aber, einen Mandanten zu verschieben, ohne andere zu bewegen.
② Zellen-Router: so schlank wie möglich
Der Router ist die einzige Komponente, die alle Zellen teilen, und damit die einzige, die einen Zellausfall noch zum Totalausfall machen kann. AWS verlangt einen Router, der einfach und schnell ist, kaum Geschäftslogik enthält, die Weiterleitung je Zelle isoliert und die übrigen Zellen weiter bedient, wenn eine nicht erreichbar ist. In der Praxis heißt das:
- Eine zwischengespeicherte, versionierte Kopie der Zuordnung von Mandant zu Zelle; ist die Quelle nicht erreichbar, gilt die letzte bekannte Version.
- Keine Geschäftsregeln: keine Feature-Flags, keine mandantenspezifischen Policies.
- Eigene Änderungen gehen in Wellen raus, denn ein fehlerhaftes Router-Release hat einen Blast Radius von 100 Prozent.
- Verbindungspools und Timeouts pro Zelle, damit eine langsame Zelle nicht die Kapazität für die gesunden aufbraucht.
Auf AWS diskutiert der Leitfaden Route 53, API Gateway oder eine Compute-Schicht, die die Zuordnung aus S3 liest. Microsofts Azure-Beispiel nutzt Front Door als globalen Einstieg und API Management, das den Stamp über eine Zuordnungstabelle in Cosmos DB auflöst. Beides funktioniert. Ein Router, der zum API-Gateway mit vierzig Policies gewachsen ist, funktioniert nicht, denn dann ist jede Policy-Änderung eine globale Änderung.
③ Die Zelle: ein vollständiger, unabhängiger Stack
Eine Zelle enthält alles, was eine Anfrage braucht: Compute, Queues, Worker und vor allem einen eigenen Datenspeicher. Teilen sich Zellen eine Datenbank, haben Sie keine Zellen, sondern zustandslose Replikate vor einer gemeinsamen Fehlerdomäne. Das ist der häufigste Fehler, den wir in Designs sehen, die sich zellbasiert nennen.
AWS beschreibt die Abwägungen bei der Zellgröße klar. Kleinere Zellen verringern die Auswirkungen, lassen sich leichter in voller Größe testen und stoßen seltener an Cloud-Quotas. Größere Zellen sind einfacher zu betreiben, müssen große Kunden seltener aufteilen und nutzen Kapazität besser. Deckeln Sie die maximale Zellgröße, halten Sie Größen einheitlich und kennen Sie die Grenzen jeder Zelle in Transaktionen pro Sekunde, Mandanten und Speicher.
Zellen bedeuten nicht automatisch mehr Infrastruktur: Im AWS-Beispiel bleiben 30 Hosts 30 Hosts, nur hinter einem Router gruppiert. Die Mehrkosten entstehen durch fixen Overhead je Zelle (Datenbanken, Load Balancer, Monitoring) und das Tooling, um viele Kopien zu betreiben. Microsoft formuliert es deutlicher: Das Muster erhöht die Betriebskosten erheblich. Planen Sie das ehrlich ein.
Zonale Zellen bilden eine Zelle auf eine Availability Zone ab, wie bei Slack, und lassen sich leicht nachrüsten. Regionale Zellen spannen sich für Redundanz innerhalb der Zelle über mehrere Zonen und legen mehrere Zellen in eine Region; das ergibt kleinere Blast Radii.
④ Control Plane: außerhalb des Anfragepfads
Die Control Plane legt Zellen an und baut sie ab, platziert neue Mandanten, migriert Mandanten, veröffentlicht die Zellzuordnung und steuert die Deployment-Wellen. Sie darf nicht im Anfragepfad liegen: Fällt sie aus, arbeiten die Zellen weiter und der Router nutzt seine letzte Zuordnung. AWS nennt das statische Stabilität und merkt an, dass Control Planes statistisch häufiger ausfallen als Data Planes. Wir prüfen das in jedem Review zuerst: Control Plane abschalten und kontrollieren, dass der Traffic unberührt bleibt.
Bei der Mandantenmigration unterschätzen die meisten Teams den Aufwand. Microsoft warnt, dass das Verschieben von Mandanten zwischen Stamps schwierig sein kann und eventuell eine Backplane erfordert. Ein typischer Ablauf:
Das schreibgeschützte Zeitfenster ist der ehrliche Preis einer einfachen Migration. Migration ohne Ausfallzeit braucht Change Data Capture und Dual Writes, ein eigenes Projekt. Entscheiden Sie früh, welche Variante Sie bauen.
⑤ Deployment-Wellen: Zelle für Zelle
Hier sehen wir den größten Nutzen. AWS betont, dass es vor allem darauf ankommt, in Wellen auszurollen, Zelle für Zelle oder in Gruppen von Zellen, und bei jedem Anzeichen eines Fehlers zurückzurollen. Ein typischer Plan: Welle 0 ist eine Zelle mit Bake-Zeit, Welle 1 einige Zellen, Welle 2 ein Viertel der Flotte, Welle 3 der Rest. Jede Welle hängt an Gesundheitsmetriken, nicht nur an der Uhr.
Die wichtigste Regel: Konfiguration ist ein Deployment. Keiner der drei Vorfälle vom Anfang war ein Code-Release, sondern eine generierte Datei, eine Mandantenkonfiguration und ein automatisierter DNS-Plan. Umgehen Feature-Flags, WAF-Regeln, Routing-Tabellen und generierte Konfiguration die Wellen-Pipeline, schützen Ihre Zellen genau vor solchen Auslösern nicht. Microsoft zieht dieselbe Verbindung: Stamps eignen sich zur Umsetzung von Deployment-Ringen.
⑥ Eindämmung: wenn eine Zelle ausfällt
Geht etwas schief, bleibt der Fehler in der Zelle, weil nichts anderes ihren Zustand teilt. Das Monitoring meldet pro Zelle, damit eine tote Zelle nicht in einem leicht gestiegenen globalen Fehleranteil verschwindet. Und der Betrieb hat eine kurze Liste von Aktionen: Welle stoppen, Zelle zurückrollen, Zelle leeren oder Mandanten migrieren.
Leeren braucht Reserve. Nehmen die übrigen Zellen den Traffic einer geleerten Zelle auf, wie bei Slacks zonalen Zellen, braucht jede verbleibende Zelle eine Zusatzkapazität von 1/(N−1): 50 Prozent je Zone bei drei zonalen Zellen. Sind Mandanten mit eigenen Daten fest an Zellen gebunden, können Sie meist nicht leeren und müssen zurückrollen und reparieren. Wissen Sie vor dem Incident, welche Art von Zelle Sie haben.
Was die Zahlen sagen
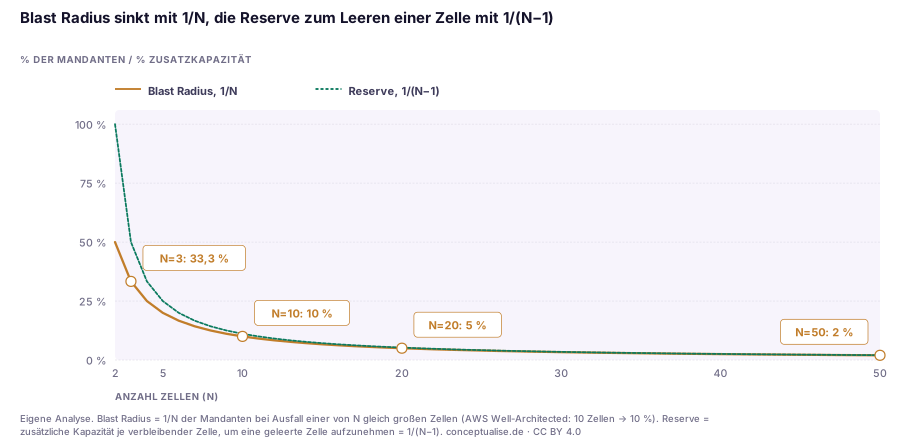
Die Formeln. Bei N gleich großen Zellen und gleichmäßig verteilten Mandanten beträgt der Anteil der betroffenen Mandanten beim Ausfall einer Zelle:
Blast Radius = 1 / N
Muss die Last einer geleerten Zelle von den anderen getragen werden, braucht jede verbleibende Zelle eine Zusatzkapazität von:
Reserve = 1 / (N − 1)
Drei Beobachtungen. Die Kurve fällt am Anfang steil: Von einer auf drei Zellen sinkt der Blast Radius von 100 auf 33 Prozent, von 20 auf 50 Zellen nur noch von 5 auf 2 Prozent. Die Reserve folgt derselben Kurve: Drei zonale Zellen brauchen 50 Prozent Zusatzkapazität, zehn Zellen rund 11 Prozent. Und das Diagramm setzt gleichmäßige Verteilung und unabhängige Ausfälle voraus. Ein riesiger Mandant oder eine gemeinsame Abhängigkeit unter allen Zellen bricht beide Annahmen. Genau danach sollte ein Design-Review suchen.
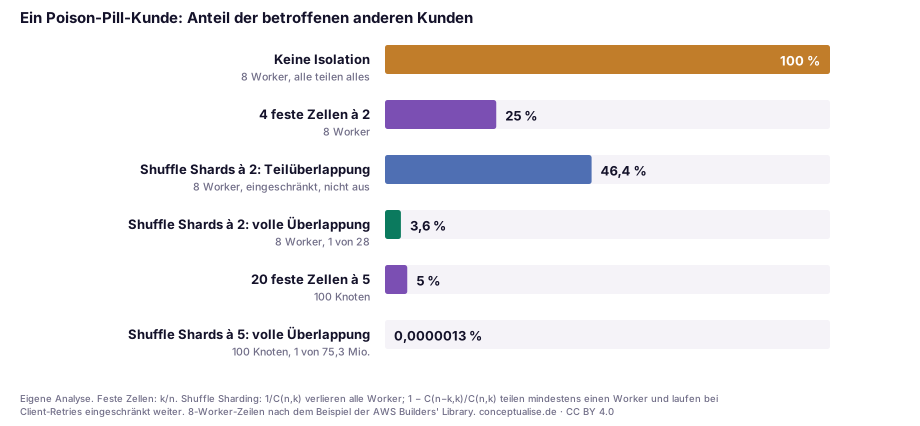
Shuffle Sharding geht noch weiter: Jeder Kunde erhält seine eigene zufällige Kombination aus k von n Workern. Colm MacCárthaighs Beispiel in der Amazon Builders' Library rechnet mit acht Workern. Bei vier festen Shards à zwei trifft ein Poison-Pill-Kunde, der seine Worker zum Absturz bringt, 25 Prozent der Kunden. Bei Shuffle Shards à zwei gibt es 28 Kombinationen, also teilen nur 1 von 28 Kunden, rund 3,6 Prozent, exakt dasselbe Paar:
voll betroffen = 1 / C(n, k) · mindestens ein gemeinsamer Worker = 1 − C(n−k, k) / C(n, k)
Die zweite Formel ist die ehrliche Fußnote: 46 Prozent der Kunden teilen mindestens einen Worker mit dem Poison-Pill-Kunden und bleiben nur verfügbar, wenn Clients auf dem anderen Worker wiederholen. Im großen Maßstab ist der Effekt drastisch: Nach unserer Rechnung ergeben 100 Knoten mit Shards à fünf 75,3 Millionen Kombinationen, Route 53 mit Shards à vier aus 2.048 virtuellen Nameservern die „staggering 730 billion" aus dem AWS-Artikel, also rund 730 Milliarden. Shuffle Sharding passt zu zustandslosen Flotten und ins Innere einer Zelle. Für zustandsbehaftete Daten ersetzt es Zellen nicht.
Alle Werte in beiden Diagrammen sind eigene Berechnungen aus den Formeln oben, keine Messungen. Die CSV-Datei enthält jeden Punkt mit seiner Formel.
Aus einem aktuellen Projekt
Ein europäischer B2B-Softwareanbieter bat uns nach einer Reihe schwerer Vorfälle um ein Review seiner Plattform. Jeder begann bei einem einzelnen Mandanten, einmal mit einem entgleisten Importjob, einmal mit einer fehlerhaften Integrations-Payload, und jeder endete damit, dass alle Kunden offline waren, weil sich alle Mandanten eine Anwendungsschicht und einen Datenbank-Cluster teilten. Die erste Idee des Teams war ein Umbau auf Microservices. Wir rieten davon ab: Services schneiden nach Funktion, die Poison-Pill-Payload hätte also weiterhin jeden Mandanten erreicht, nur über mehr Stationen.
Stattdessen entwarfen wir Zellen entlang der Mandanten-ID mit vollständiger Zuordnungstabelle, beginnend mit zwei Zellen: einer Canary-Zelle mit internen und befreundeten Mandanten und einer Zelle für alle anderen. Der Router war ein kleiner Reverse Proxy, der eine versionierte Zuordnung aus einem Blob Storage las. Die ersten Monate waren unspektakulär: versteckte mandantenübergreifende Abfragen entfernen, einen gemeinsamen Job-Scheduler aufteilen und die Pipeline auf Zellen statt auf „Produktion" ausrichten. Die Canary-Zelle hatte sich bezahlt gemacht, bevor die Hauptzelle überhaupt geteilt wurde: Fehlerhafte Releases, die früher alle erreicht hätten, endeten in Welle 0.
Was wir heute anders machen würden: Konfiguration von Anfang an in die Wellen-Pipeline nehmen. Das Team hielt Feature-Flags global, „weil das keine Deployments sind". Doch, das sind sie. Zellen funktionieren mit einem modularen Monolithen ebenso wie mit Services; wer noch abwägt, findet Argumente in unserem Beitrag zum modularen Monolithen vor Microservices.
Entscheidungstabelle: Brauchen Sie Zellen?
| Signal | Zellen lohnen sich wahrscheinlich | Zellen lohnen sich noch nicht |
|---|---|---|
| Mandantenmodell | Multi-Tenant-Plattform, viele Kunden auf gemeinsamer Infrastruktur | Single-Tenant oder wenige interne Nutzer |
| Kosten eines Totalausfalls | Vertragliche SLAs, regulatorische Meldepflichten, Umsatzverlust pro Minute | Ärgerlich, aber es gibt einen manuellen Workaround |
| Incident-Historie | Auslöser bei einem Mandanten wurden zu globalen Ausfällen (Poison Pills, Noisy Neighbours, fehlerhafte Konfiguration) | Ausfälle kommen vor allem aus Infrastruktur, die Sie nicht in Zellen aufteilen können (eine Region, ein Anbieter) |
| Natürlicher Partitionsschlüssel | Mandant, Händler, Konto oder Geräteflotte in fast jeder Anfrage | Entitätsübergreifende Abfragen sind der Kern des Produkts |
| Plattformreife | Vollständig automatisierte IaC und Pipelines; Konfiguration je Umgebung parametrisiert | Manuelle Deployments; Schneeflocken-Umgebungen |
| Teamkapazität | Ein Plattformteam, das Router, Control Plane und Observability pro Zelle verantwortet | Niemand, der das gemeinsame Tooling übernimmt |
Und die Design-Checkliste aus unseren Reviews:
| # | Prüfpunkt | Warum er zählt |
|---|---|---|
| 1 | Jede Zelle hat einen eigenen Datenspeicher | Eine gemeinsame Datenbank ist eine gemeinsame Fehlerdomäne |
| 2 | Router ohne Geschäftslogik, arbeitet mit zwischengespeicherter, versionierter Zuordnung | Der Router ist die einzige Komponente, die alle Zellen teilen |
| 3 | Control Plane aus → Traffic unberührt (getestet) | Statische Stabilität ist der Kern |
| 4 | Jede Änderung, auch Konfiguration und Flags, läuft in Zellwellen | Änderungen sind der übliche Auslöser globaler Ausfälle |
| 5 | Maximale Zellgröße definiert und unter Last getestet | Unbekannte Grenzen werden zu Skalierungsklippen |
| 6 | Dashboards und Alarme pro Zelle, nicht nur global | Ein kleiner globaler Fehleranteil kann eine tote Zelle verbergen |
| 7 | Migrationsablauf für Mandanten dokumentiert und geübt | Wachsende Mandanten und Rebalancing kommen bestimmt |
| 8 | Gemeinsame Abhängigkeiten (Identität, DNS, Secrets, CDN) mit eigenem Blast Radius erfasst | Zellen schützen nicht vor dem, was unter allen liegt |
Governance für europäische Unternehmen
Zellen sind ein Architekturmuster, kein Compliance-Framework, passen aber gut zu zwei Regelwerken, die viele unserer Kunden ohnehin betreffen.
DORA. Die Verordnung (EU) 2022/2554 gilt seit dem 17. Januar 2025 für Finanzunternehmen. Artikel 9 Absatz 4 Buchstabe b verlangt eine solide Netzwerk- und Infrastrukturverwaltung; der anschließende Unterabsatz fordert, dass sich Netzwerkverbindungen sofort trennen oder segmentieren lassen, um eine Ausbreitung zu minimieren und zu verhindern. Buchstabe e verlangt, dass IKT-Änderungen kontrolliert erfasst, getestet, bewertet, genehmigt, umgesetzt und überprüft werden. Ein zellbasiertes Design mit Releases in Wellen beantwortet beides nachweisbar: Sie zeigen die Segmentierung und jede Änderung, die mit Gates durch die Zellen läuft. Unser DORA-Umsetzungsleitfaden behandelt den gesamten IKT-Risikomanagementrahmen.
NIS2. Artikel 21 Absatz 2 Buchstabe c der Richtlinie (EU) 2022/2555 nennt die Aufrechterhaltung des Betriebs, etwa Backup-Management, Wiederherstellung nach einem Notfall und Krisenmanagement, als Mindestmaßnahme. In Deutschland gilt seit dem 6. Dezember 2025 das NIS2UmsuCG, die Pflichten stehen in § 30 BSIG. Ein geübtes Leeren einer Zelle oder Migrieren von Mandanten belegt, dass Betriebskontinuität mehr ist als ein Dokument.
Datenresidenz. Microsoft nennt Datensouveränität als Grund, Kunden an bestimmte Regionen zu binden; im DACH-Raum heißt das oft: Zellen nur in EU-Regionen. Multiregionale Notfallwiederherstellung ersetzen Zellen aber nicht, denn Stamps sind über Regionen hinweg nicht automatisch redundant. Diese Ebene behandeln wir in den Multi-Region-DR-Mustern für Azure.
Ein pragmatischer Einführungspfad
- Messen Sie Ihren heutigen Blast Radius. Notieren Sie für die letzten zehn Incidents den Anteil betroffener Kunden und den Auslöser. Trafen die meisten alle Kunden und begannen mit einer Änderung, haben Sie Ihren Business Case.
- Wählen Sie den Partitionsschlüssel und beseitigen Sie zellübergreifende Pfade. Finden Sie jede Abfrage, jeden Job und jeden Cache, der Mandanten übergreift. Das ist der längste Schritt und lohnt sich auch, wenn Sie danach aufhören.
- Bauen Sie zwei Zellen und einen langweiligen Router. Eine Canary-Zelle und eine Hauptzelle, ein schlanker Router, eine versionierte Zuordnung. Mit nur einer Zelle überleben versteckte „Es gibt nur eine"-Annahmen.
- Bringen Sie jede Änderung in Wellen. Code, Infrastruktur, Konfiguration, Feature-Flags, gekoppelt an Gesundheitsmetriken pro Zelle mit automatischem Rollback.
- Bauen Sie erst die Control Plane aus, dann die Zahl der Zellen. Ergänzen Sie Tooling für Platzierung und Migration und teilen Sie die Hauptzelle, wenn Skalierung und Risiko es verlangen. Für Isolationsmodelle innerhalb und zwischen Zellen siehe unseren Leitfaden zu Isolationsmodellen für Multi-Tenant-SaaS auf Azure.
Das Fazit
Zellbasierte Architektur ist weder neu noch glamourös. Sie ist ein Schott für einen ganzen Workload, mit einem Router davor und einer Control Plane daneben. Sie macht die wichtigste Resilienzfrage, „Wie viele Kunden trifft ein Fehler?", zu einer Zahl, die Sie festlegen: 1/N.
Unsere Einschätzung: Wenn Sie eine Multi-Tenant-Plattform betreiben, bei der ein Totalausfall inakzeptabel ist, sollten Sie auf Zellen hinarbeiten. Beginnen Sie mit zwei, schicken Sie jede Änderung durch Wellen und halten Sie den Router langweilig. Für ein internes Single-Tenant-System nutzen Sie zuerst die günstigeren Muster: Timeouts, Bulkheads innerhalb der Anwendung und saubere Deployment-Hygiene. Und was immer Sie bauen: Listen Sie auf, was unter all Ihren Zellen liegt. Die Ausfälle 2025 und 2026 haben gezeigt, dass die vergessene globale Abhängigkeit Ihren tatsächlichen Blast Radius bestimmt.
Wenn Sie eine zweite Meinung zu einem zellbasierten Design oder einem Migrationsplan möchten, führt unser Software-Architektur-Team kompakte Architektur-Reviews entlang der Checkliste oben durch.
FAQ
Was ist eine zellbasierte Architektur?
Sie betreibt mehrere vollständige, voneinander unabhängige Kopien eines Workloads, die Zellen, und leitet jede Anfrage anhand eines Partitionsschlüssels wie der Mandanten-ID an genau eine davon. Zellen teilen keinen Zustand. Ein schlanker Router übernimmt das Routing, eine separate Control Plane legt Zellen an und platziert Mandanten. Fällt eine Zelle aus, sind nur ihre Mandanten betroffen. AWS beschreibt das Muster im Well-Architected Framework, Microsoft nennt es Deployment Stamps.
Worin unterscheidet sich eine Zelle von einem Microservice oder einer Availability Zone?
Ein Microservice schneidet ein System nach Funktion, eine Anfrage berührt also viele Services. Eine Zelle schneidet nach Kunden: Sie enthält alle Services des Workloads, und eine Anfrage bleibt in einer Zelle. Eine Availability Zone ist eine Fehlergrenze der Infrastruktur, die Ihnen der Anbieter liefert; eine Zelle ist eine Fehlergrenze des Workloads, die Sie selbst bauen. Slack hat jede Zone zu einer Zelle gemacht, andere Designs legen mehrere Zellen in eine Region.
Wie viele Zellen brauchen wir, und wie groß sollte eine Zelle sein?
Beginnen Sie mit dem Blast Radius, den Sie tolerieren können. Bei N gleich großen Zellen trifft der Ausfall einer Zelle 1/N der Mandanten: 10 Zellen bedeuten 10 Prozent, 20 Zellen 5 Prozent. Begrenzen Sie dann die Zellgröße: groß genug für Ihren größten Mandanten, klein genug für Lasttests in voller Größe und unterhalb der Cloud-Quotas. Starten Sie, wie Microsoft rät, mit mindestens zwei, damit kein Code von genau einer Instanz ausgeht.
Was ist Shuffle Sharding, und wie hängt es mit Zellen zusammen?
Jeder Kunde erhält statt einer festen Zelle eine eigene zufällige Kombination aus k von n Workern. Ein Poison-Pill-Kunde legt dann nur Kunden mit exakt derselben Kombination vollständig lahm: bei 8 Workern und Shards à 2 einen von 28, gegenüber einem von 4 bei vier festen Zellen. Route 53 nutzt Shards à vier aus 2.048 virtuellen Nameservern, rund 730 Milliarden Kombinationen. Das passt zu zustandslosen Flotten und ins Innere einer Zelle, mit Clients, die auf einem anderen Worker wiederholen.
Ist der Zellen-Router ein Single Point of Failure?
Er ist die einzige Komponente, die alle Zellen teilen, und muss deshalb der langweiligste Teil des Systems sein: keine Geschäftslogik, eine zwischengespeicherte und versionierte Zuordnung von Mandant zu Zelle, horizontale Skalierung und normales Routing zu gesunden Zellen, wenn eine nicht erreichbar ist. Rollen Sie ihn wie eine Zelle in Wellen aus, und sorgen Sie dafür, dass er bei ausgefallener Control Plane mit der letzten bekannten Zuordnung weiterarbeitet.
Hilft eine zellbasierte Architektur bei DORA oder NIS2?
Sie hilft beim Nachweis, macht Sie aber nicht allein compliant. DORA verlangt in Artikel 9 Absatz 4 von Finanzunternehmen eine Netzwerkinfrastruktur, die sich sofort trennen oder segmentieren lässt, um eine Ausbreitung zu verhindern, sowie ein kontrolliertes IKT-Änderungsmanagement. Zellen und Releases in Wellen belegen beides. NIS2 verlangt in Artikel 21 Absatz 2 Buchstabe c Maßnahmen zur Aufrechterhaltung des Betriebs, in Deutschland umgesetzt in § 30 BSIG; ein geübtes Leeren einer Zelle ist dafür ein guter Nachweis.
Quellen
Alle Quellen geprüft am 15. November 2026. Die Diagrammwerte sind eigene Berechnungen aus den im Beitrag genannten Formeln.
Tier A: Primärquellen und Regulierung
- AWS, Reducing the Scope of Impact with Cell-Based Architecture (AWS Well-Architected, veröffentlicht am 20. September 2023): https://docs.aws.amazon.com/wellarchitected/latest/reducing-scope-of-impact-with-cell-based-architecture/reducing-scope-of-impact-with-cell-based-architecture.html
- AWS, derselbe Leitfaden, Abschnitte „What is a cell-based architecture?", „Cell sizing", „Cell partition", „Cell routing", „Cell deployment" und „Control plane and data plane": https://docs.aws.amazon.com/wellarchitected/latest/reducing-scope-of-impact-with-cell-based-architecture/what-is-a-cell-based-architecture.html
- Microsoft, Azure Architecture Center, Muster Deployment Stamps: https://learn.microsoft.com/de-de/azure/architecture/patterns/deployment-stamp
- AWS, Zusammenfassung der DynamoDB-Störung in us-east-1 (Oktober 2025): https://aws.amazon.com/message/101925/
- Cloudflare, Ausfall vom 18. November 2025: https://blog.cloudflare.com/18-november-2025-outage/
- Cloudflare, Ausfall vom 20. Februar 2026: https://blog.cloudflare.com/cloudflare-outage-february-20-2026/
- Verordnung (EU) 2022/2554 (DORA), Artikel 9: https://eur-lex.europa.eu/legal-content/DE/TXT/?uri=CELEX:32022R2554
- Richtlinie (EU) 2022/2555 (NIS2), Artikel 21: https://eur-lex.europa.eu/legal-content/DE/TXT/?uri=CELEX:32022L2555
Tier B: Engineering-Forschung und Praxisberichte
- Colm MacCárthaigh, „Workload isolation using shuffle-sharding", Amazon Builders' Library (5. Dezember 2019): https://builder.aws.com/content/3F06NpJ8YeoIGP8VHTw4n81pFn8/workload-isolation-using-shuffle-sharding
- Cooper Bethea, „Slack's Migration to a Cellular Architecture", Slack Engineering (22. August 2023): https://slack.engineering/slacks-migration-to-a-cellular-architecture/
- Roblox, „How We're Making Roblox's Infrastructure More Efficient and Resilient" (7. Dezember 2023): https://about.roblox.com/newsroom/2023/12/making-robloxs-infrastructure-efficient-resilient
Tier C: Presse und Analyse, richtungsweisend
- InfoQ, Control-Plane-Ausfall von Azure Front Door und Post Incident Review (5. November 2025): https://www.infoq.com/news/2025/11/azure-afd-control-plane-failure
- InfoQ, Slacks zellbasierte Architektur (Januar 2024): https://www.infoq.com/news/2024/01/slack-cell-based-architecture
- InfoQ, Roblox Cellular Infrastructure (Januar 2024): https://www.infoq.com/news/2024/01/roblox-cellular-infrastructure
Themen