Hyperscaler-Ausfälle: Architektur für Control-Plane-Fehler
Was die Post-Incident-Reports von AWS, Azure, Google Cloud und Cloudflare über Control-Plane-Ausfälle zeigen und wie statische Stabilität dagegen schützt.
Am 19. Oktober 2025 um 23:48 Uhr Pazifikzeit war der DNS-Eintrag für den regionalen DynamoDB-Endpunkt in us-east-1 plötzlich leer. Keine Hardware war defekt, niemand hatte angegriffen. Zwei Instanzen eines Automatisierungswerkzeugs lieferten sich ein Rennen, und die langsamere gewann. AWS reparierte den DNS-Eintrag in weniger als drei Stunden. Beendet war das Ereignis aber erst um 14:20 Uhr am nächsten Tag, weil sich die Systeme, die Instanzen starten, Last verteilen und Zugangsdaten ausstellen, erst aus dem Loch herausarbeiten mussten, das die ersten drei Stunden gerissen hatten. Zehn Tage später stürzte Azure Front Door fast achteinhalb Stunden lang am Edge ab, ausgelöst durch Konfigurationsmetadaten, die jeder Health Check durchgewunken hatte.
Keiner der beiden Ausfälle war ein Rechenzentrumsbrand. Beide begannen in einer Control Plane, also in der Mechanik, die Dinge verändert, nicht in der, die Nutzer bedient. Dasselbe gilt für den Ausfall von Google Cloud im Juni 2025, den von Cloudflare im November 2025 und, mit etwas Großzügigkeit, für das CrowdStrike-Content-Update vom Juli 2024. Diese Analyse richtet sich an alle, die festlegen, was „resilient" in ihrer Architektur bedeutet: CTOs, Plattformverantwortliche, Cloud-Architekten und die Risikoverantwortlichen, die DORA- und NIS2-Notfallpläne abzeichnen. Wir zeigen die sechs Stellen, an denen eine Control Plane in den laufenden Betrieb durchschlägt, und das Design für statische Stabilität, das jede davon kappt.
TL;DR / Das Wichtigste in Kürze
- Die großen Ausfälle sind Control-Plane-Ausfälle. Jeder große Hyperscaler-Vorfall, den wir von 2021 bis 2026 untersucht haben, begann in Konfiguration, DNS-Automatisierung, Kapazitätsmanagement oder einem globalen Policy-Push, nicht in den Servern, auf denen Ihr Code läuft.
- Der Auslöser ist kurz, der Nachlauf lang. Beim AWS-Ereignis im Oktober 2025 war der DNS-Fehler nach weniger als drei Stunden behoben. Lambda, EC2-Starts und Container-Dienste brauchten über 14 Stunden, weil die Wiederherstellung selbst von überlasteten Control Planes abhing.
- Statische Stabilität ist die Designantwort. Wenn Ihre Wiederherstellung während des Vorfalls Instanzen starten, eine Management-API aufrufen oder neue Zugangsdaten holen muss, konkurriert sie mit allen anderen Kunden, die dasselbe tun. Stellen Sie stattdessen vorab bereit, cachen Sie und verdrahten Sie im Voraus.
- Der eigene Wiederherstellungspfad ist die häufigste Schwachstelle. Runbooks, die Konsole, Management-API oder globale Anmeldung brauchen, scheitern genau dann, wenn Sie sie ausführen. Das Azure-Portal überstand den Front-Door-Ausfall, weil es einen geübten Weg weg von Front Door hatte.
- Aufsichtsbehörden erwarten Tests. DORA verlangt getestete Ausstiegsstrategien und Notfallpläne, und AWS, Google Cloud und Microsoft stehen auf der Liste der kritischen IKT-Drittdienstleister. „Die Cloud ist ja resilient" ist keine akzeptable Kontrolle mehr.

Download: Editierbare draw.io-Datei · In diagrams.net öffnen · Diagrammdaten (CSV)
Warum das jetzt zählt
Zwei Dinge haben sich geändert. Erstens die Beweislage. Die Anbieter veröffentlichen heute detaillierte Post-Incident-Reviews mit Zeitstempeln: Die AWS-Zusammenfassung zum Oktober 2025 benennt die beteiligten internen Subsysteme und liefert für jeden betroffenen Dienst eine Zeitleiste, und Googles Bericht vom Juni 2025 räumt offen ein, der fehlerhafte Code habe weder eine angemessene Fehlerbehandlung gehabt noch sei er durch ein Feature Flag geschützt gewesen. Architekten können damit gegen dokumentierte Fehlerbilder entwerfen statt gegen ein pauschales Szenario „Region weg".
Zweitens die Regulierung. DORA gilt für Finanzunternehmen in der EU seit dem 17. Januar 2025. Im November 2025 haben die Europäischen Aufsichtsbehörden ihre erste Liste benannter kritischer IKT-Drittdienstleister veröffentlicht: 19 Unternehmen, darunter Amazon Web Services EMEA, Google Cloud EMEA und Microsoft Ireland Operations. Diese Anbieter stehen nun unter direkter EU-Aufsicht, die Finanzunternehmen, die sie nutzen, müssen aber weiterhin nachweisen, dass ihre eigenen Ausstiegspläne ausreichend getestet sind. NIS2 formuliert eine ähnliche Erwartung für wichtige und besonders wichtige Einrichtungen in anderen Sektoren. Ein Notfallplan, der voraussetzt, dass die Control Plane des Anbieters zur Ausführung bereitsteht, besteht diesen Test nicht.
Das verbreitete Fehlurteil lautet „us-east-1 ist verflucht" oder „die Cloud ist fragil". Tatsächlich haben die Data Planes gut gehalten. Für Dezember 2021 hält AWS fest, dass „running EC2 instances were unaffected", während die EC2-APIs sieben Stunden lang gestört waren. Im Oktober 2025 betont AWS erneut, dass laufende Instanzen nicht betroffen waren, während DWFM, das System zur Verwaltung der physischen Hosts, ausfiel. Workloads, die nur weiterlaufen mussten, liefen weiter. Workloads, die zum Überleben etwas ändern mussten, hatten ein Problem.
Die sechs Stellen, an denen die Control Plane in den Betrieb durchschlägt
Die klarste Definition liefert die Builders' Library von AWS. Die Control Plane ist „the machinery involved in making changes to a system", die Data Plane „the daily business of those resources". Derselbe Artikel ergänzt zwei Beobachtungen, die alles Folgende rahmen: Control Planes sind „necessarily more complex" als Data Planes, und für Kunden ist die Verfügbarkeit der Data Plane typischerweise noch wichtiger. Daraus folgt statische Stabilität: „In a statically stable design, the overall system keeps working even when a dependency becomes impaired."
Das Hero-Diagramm stellt jeder Data-Plane-Funktion die Control Plane gegenüber, von der sie unbemerkt abhängen kann. Die Ziffern entsprechen den warmen Markierungen, die Buchstaben den grünen Entscheidungen für statische Stabilität.
① Globaler Konfigurations-Push
Was ausfiel. Am 29. Oktober 2025 beschreibt das Post Incident Review von Microsoft Kundenkonfigurationsänderungen über zwei Build-Versionen der Control Plane, die „resulted in incompatible customer configuration metadata being generated". Die Data Plane am Edge stürzte bei der asynchronen Verarbeitung ab. Weil der Absturz asynchron war, bestanden die Health Checks den Rollout, die Metadaten verteilten sich weltweit und überschrieben den „Last Known Good"-Snapshot, auf den das Rollback angewiesen war. Microsoft stoppte um 17:30 Uhr UTC jede Konfigurationsverteilung und brachte bis 17:50 Uhr einen korrigierten Last-Known-Good-Stand auf alle Edge-Standorte. Das Neuladen der Konfiguration nach einem Absturz des Master-Prozesses dauerte laut Microsoft dann „approximately 4.5 hours". Die Beeinträchtigung reichte von 15:41 bis 00:05 Uhr UTC.
Googles Ausfall im Juni 2025 hat dieselbe Form: Eine Policy-Änderung mit leeren Feldern wurde „replicated globally within seconds" und brachte Service Control überall gleichzeitig zum Absturz, über einen Codepfad, der zwei Wochen zuvor ausgeliefert und im Rollout nie durchlaufen worden war. Bei Cloudflare verdoppelte im November 2025 eine geänderte Datenbankberechtigung eine intern erzeugte Bot-Management-Datei über die harte Grenze von 200 Features hinaus, und der Proxy brach weltweit ab. Das CrowdStrike Channel File 291 war am 19. Juli 2024 nur 78 Minuten live; Microsoft schätzte die Zahl der betroffenen Windows-Geräte auf 8,5 Millionen. Und am 30. September 2026 lief ein Azure-Gateway-Update in vielen Regionen gleichzeitig wieder an und überlastete die regionale Gateway-Control-Plane; einige ExpressRoute-Gateways verloren die Verbindung, bis sie auf ihre letzte bekannte gute Konfiguration zurückfielen.
Die Lehre. Konfiguration ist Code ohne Code-Review, verbreitet sich schneller als Binaries und erreicht jede Zelle gleichzeitig.
Entscheidung für statische Stabilität (A). Behandeln Sie jeden Konfigurations-Push, auch Ihre eigenen Feature Flags, WAF-Regeln und Policy-Bundles, wie ein Deployment. Rollen Sie zell- oder regionsweise mit Wartezeit aus, prüfen Sie synchron, bevor die Data Plane lädt, und halten Sie eine Last-Known-Good-Kopie, die ein fehlerhafter Push nicht überschreiben kann. Cloudflare hat zugesagt, selbst erzeugte Konfigurationsdateien künftig so streng zu prüfen wie Benutzereingaben; Microsoft hat im Dezember 2025 einen „Food Taster"-Prozess angekündigt, der Konfiguration prüft, bevor die ausliefernden Prozesse sie laden. Schlägt die Prüfung fehl, arbeiten Sie mit der alten Konfiguration weiter: statisch bleiben statt dichtmachen.
② DNS und Service Discovery
Was ausfiel. Beim AWS-Ereignis im Oktober 2025 verwalten zwei Komponenten das DNS von DynamoDB: ein DNS Planner, der Pläne erzeugt, und mehrere DNS Enactors, die sie anwenden. Ein Enactor war verzögert. Er spielte einen älteren Plan über einen neueren, und ein Bereinigungsprozess löschte den überschriebenen Plan. Die AWS-Zusammenfassung ist deutlich: „all IP addresses for the regional endpoint were immediately removed." Jeder Client, der dynamodb.us-east-1.amazonaws.com auflöste, bekam nichts zurück, auch die eigenen AWS-Dienste. Um 2:25 Uhr waren alle Einträge wiederhergestellt, um 2:40 Uhr war die Erholung abgeschlossen, als die gecachten Einträge abliefen.
Die Lehre. DNS ist eine robuste Data Plane, bis die Automatisierung, die Einträge schreibt, Teil des Anfragepfads wird. Eine veraltete Antwort zeigt meist auf etwas, das noch funktioniert; eine leere zeigt auf nichts.
Entscheidung für statische Stabilität (B). Bevorzugen Sie regionale gegenüber globalen Endpunkten, damit die DNS-Automatisierung einer Region keine andere beschädigt. Wählen Sie TTLs bewusst: Sehr kurze TTLs machen Sie davon abhängig, dass das autoritative System alle paar Sekunden erreichbar ist. Bauen Sie in Ihre eigene DNS-Automatisierung die Sperre ein, die AWS nachrüsten musste: Kein leerer oder drastisch verkleinerter Record-Satz ohne menschliche Freigabe. AWS hat die DNS-Planner- und Enactor-Automatisierung nach dem Ereignis weltweit abgeschaltet und will vor der Reaktivierung Schutzmechanismen ergänzen, „to prevent the application of incorrect DNS plans".
③ Kapazität und Start
Was ausfiel. Hier entstand der lange Nachlauf vom Oktober 2025. Der DropletWorkflow Manager (DWFM) von EC2 hält auf jedem physischen Host („Droplet") einen Lease. Seine Statusprüfungen hängen von DynamoDB ab, also liefen die Leases ab, während DynamoDB nicht erreichbar war. Als DynamoDB um 2:25 Uhr zurückkam, musste DWFM die Leases mit der gesamten Flotte gleichzeitig neu aufbauen und geriet laut AWS in „a state of congestive collapse". Neue Starts scheiterten mit „insufficient capacity". Um 4:14 Uhr drosselten die Ingenieure eingehende Arbeit und starteten DWFM-Hosts neu, um 5:28 Uhr standen die Leases wieder. Danach hatte der Network Manager einen Rückstau an Netzwerkstatus für neue Instanzen, der sich erst um 10:36 Uhr auflöste. EC2-APIs und Starts liefen um 13:50 Uhr wieder normal.
Die Lehre. „Autoscaling fährt in der gesunden Zone Kapazität hoch" setzt eine Kapazitäts-Control-Plane voraus, die gesund ist und nicht von allen anderen Kunden mit demselben Plan überrannt wird. Im Oktober 2025 traf beides nicht zu.
Entscheidung für statische Stabilität (C). Vorab bereitstellen. Halten Sie in jeder Zone genug Kapazität, um den Verlust einer Zone ohne einen einzigen Neustart zu verkraften. Die Reliability-Dokumentation von Microsoft liefert die Rechnung: Spitzenbedarf mal N/(N−1), wobei N die Zahl der genutzten Zonen ist. Bei drei Zonen heißt das 1,5-mal Spitzenlast. Eine Standby-Region sollte warm genug sein, um in den ersten Stunden mit dem bereits Laufenden echten Traffic zu tragen. Hochskalieren während eines Vorfalls ist ein Bonus, kein Plan.
④ Health Checks und automatisches Failover
Was ausfiel. Ab 5:30 Uhr am 20. Oktober war das Health-Check-Subsystem des NLB laut AWS dabei, „bringing new EC2 instances into service while the network state for those instances had not yet fully propagated". Die Health Checks wechselten zwischen fehlgeschlagen und gesund, Knoten wurden aus dem DNS genommen und wieder aufgenommen, und die Fehler lösten ein automatisches zonales DNS-Failover aus, das Kapazität aus Multi-AZ-Load-Balancern abzog. STS erlebte dadurch von 8:31 bis 9:59 Uhr eine zweite Fehlerwelle. Um 9:36 Uhr schalteten die Ingenieure das automatische Health-Check-Failover für den NLB ab und stoppten damit das Hin und Her. Die zentrale Änderung von AWS ist „a velocity control mechanism to limit the capacity a single NLB can remove".
Der Vorfall in Azure Sweden Central am 29. September 2026 zeigt dasselbe Muster im Kleinen. Ein Deployment leerte zur Spitzenzeit die Caches eines internen Dienstes, die Last auf dessen Backend stieg etwa um das Zwanzigfache, und ein Health Check, der von der Datenbankverbindung abhing, schickte Knoten in eine Neustartschleife, bis der Check geändert wurde.
Die Lehre. Automatisches Failover ist eine Control Plane. Wenn plötzlich alles krank aussieht, ist die wahrscheinlichste Ursache der Health Check, nicht die Flotte.
Entscheidung für statische Stabilität (D). Lassen Sie Health Checks prüfen, was ausliefert, nicht dessen Abhängigkeiten. Begrenzen Sie, wie viel Kapazität eine Automatik in einem Zeitfenster entfernen darf. Konfigurieren Sie eine Fail-open-Schwelle: Wirkt mehr als etwa die Hälfte der Targets krank, hören Sie auf zu entfernen und verteilen auf alle. Eine teilweise gestörte Flotte bedient mehr Nutzer als eine leere.
⑤ Identität und Token-Ausstellung
Was ausfiel. Identität ist die Abhängigkeit, die niemand einzeichnet. Im Oktober 2025 lieferte STS von 23:51 bis 9:59 Uhr Fehler, mit einer zwischenzeitlichen Erholung, und Nutzer mit IAM Identity Center in us-east-1 konnten sich nicht anmelden. Das Front-Door-Review von Microsoft führt Teile von Entra ID unter den betroffenen Diensten. Das AWS-Whitepaper zu Fault Isolation Boundaries hält fest, dass die Control Plane von IAM in us-east-1 liegt, ihre Data Plane dagegen in jeder Region läuft.
Die Lehre. Ein Workload mit gültigen Tokens arbeitet weiter. Einer, der mitten im Vorfall ein frisches Token von einem globalen Endpunkt braucht, nicht.
Entscheidung für statische Stabilität (E). Nutzen Sie regionale Token-Endpunkte; laut AWS gelten Zugangsdaten eines regionalen STS-Endpunkts in jeder Region. Erneuern Sie Tokens lange vor Ablauf, damit aus zwei Stunden Ausfall beim Aussteller nicht zwei Stunden Anwendungsausfall werden. Halten Sie IAM-Änderungen wie das Anlegen von Rollen aus dem Failover-Pfad heraus. In Entra-basierten Umgebungen sollten Notfallkonten nicht denselben Conditional-Access-Pfad nutzen wie alle anderen.
⑥ Die Management Plane in Ihrem Wiederherstellungspfad
Was ausfiel. Diese Stelle gehört Ihnen, nicht dem Anbieter. Im Dezember 2021 konnte das Service Health Dashboard von AWS selbst nicht in seine Standby-Region umschalten, weil genau die Überlast, über die es berichten sollte, das Failover blockierte. Die Route-53-APIs waren sieben Stunden gestört; bestehende DNS-Antworten funktionierten, aber niemand konnte sie ändern. Ganz anders Microsoft beim Front-Door-Ausfall: Das Azure-Portal „leveraged its standard recovery process to successfully transition away from AFD", um 17:26 Uhr UTC. Einige Portal-Erweiterungen wie der Marketplace hatten laut Review keine etablierte Fallback-Strategie („did not have an established fallback strategy") und blieben gestört. Dieselbe Organisation, derselbe Abend, und der Unterschied war ein geübter Pfad.
Die Lehre. Ein Runbook, das mit „In der Konsole anmelden", „Terraform apply ausführen" oder „DNS-Eintrag ändern" beginnt, braucht die Management Plane genau dann, wenn sie am wahrscheinlichsten fehlt.
Entscheidung für statische Stabilität (F). Schalten Sie über Schalter um, die in der Data Plane liegen und im Voraus gebaut wurden. Das AWS-Whitepaper empfiehlt, „global service control plane dependencies in your recovery path" zu entfernen. Konkret auf AWS: Routing Controls des Application Recovery Controller oder vorab angelegte, health-check-gesteuerte DNS-Failover-Einträge statt Änderungen während des Vorfalls. Seit Dezember 2025 bietet Route 53 zudem Accelerated Recovery für öffentliche Hosted Zones: Route 53 kann seine Control Plane damit binnen etwa 60 Minuten nach us-west-2 umschalten, wenn us-east-1 gestört ist, aber nur, wenn Sie die Funktion vorher aktiviert haben. Auf Azure laufen alle Control-Plane-Anfragen über den Azure Resource Manager (management.azure.com), während laut Microsoft-Dokumentation „you can still access the data plane of your Azure resources", wenn dieser nicht verfügbar ist. Stellen Sie die Sekundärumgebung vorab bereit und konfigurieren Sie Routing-Prioritäten im Voraus, damit Failover eine Routing-Entscheidung ist und kein Deployment.
Was die Zahlen sagen
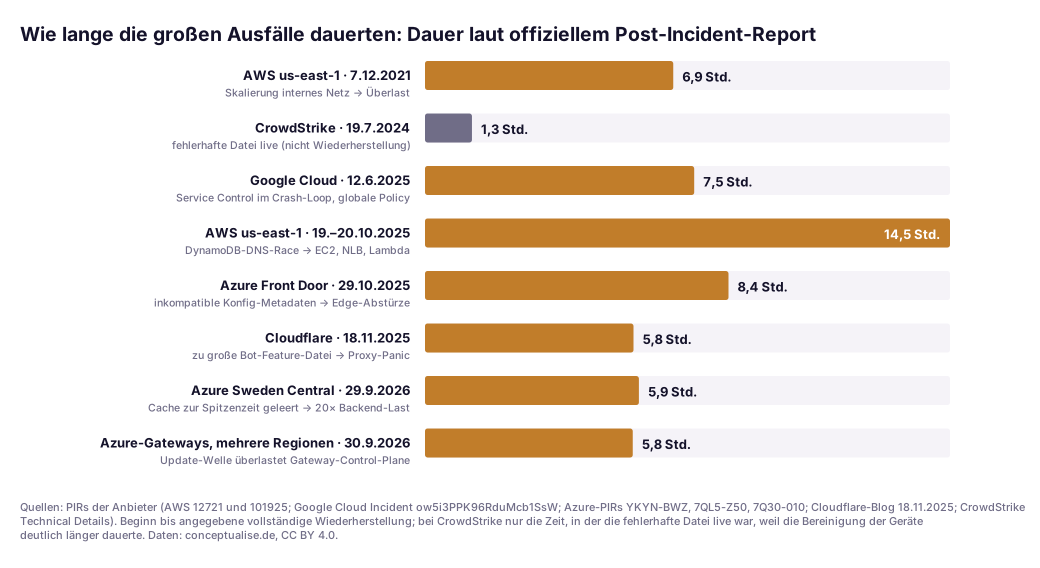
Wir haben die Start- und Endzeiten genommen, die jeder Anbieter in seinem eigenen Report nennt, und subtrahiert. „Vollständig wiederhergestellt" bedeutet in jedem Report etwas anderes, deshalb hält die CSV fest, welche Endzeit wir verwendet haben. Zwei Dinge fallen auf. Erstens dauerten die großen Ausfälle, abgesehen vom 14,5-stündigen AWS-Ereignis im Oktober 2025, zwischen etwa 5,8 und 8,4 Stunden, lang genug, um jedes RTO von „unter vier Stunden" zu reißen, das darauf baut, dass der Anbieter das Problem für Sie löst. Zweitens ist der CrowdStrike-Balken mit Absicht kurz: Die fehlerhafte Datei war 78 Minuten live, die Bereinigung der betroffenen Rechner dauerte deutlich länger. Wie lange ein fehlerhafter Push live ist, sagt wenig darüber, wie lange der Ausfall dauert.
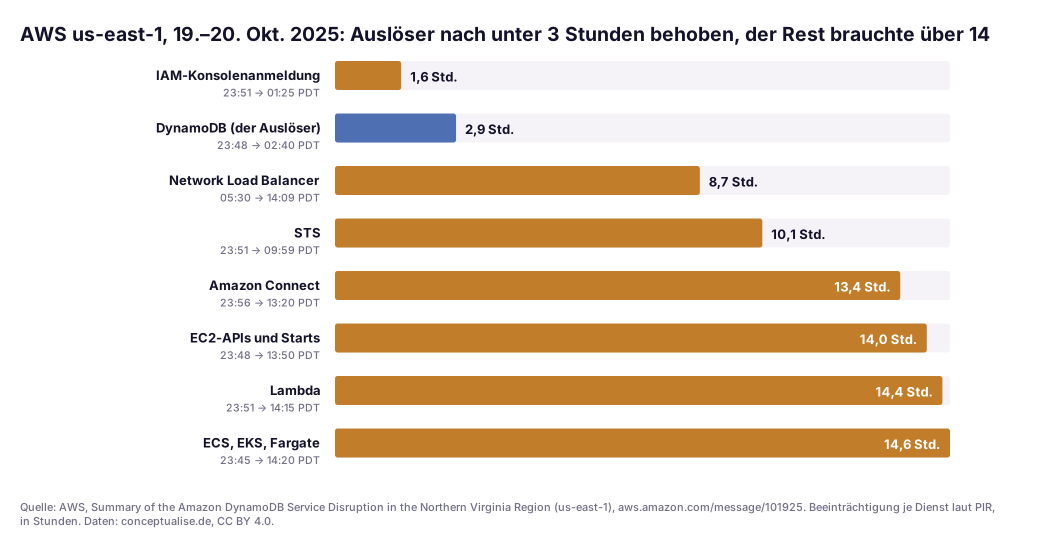
Dieses Diagramm gehört vor Ihr Architekturgremium. Der DNS-Fehler bei DynamoDB, blau dargestellt, war nach 2,9 Stunden behoben. Alles, was eine Control Plane brauchte, um Zustand neu aufzubauen, dauerte drei- bis fünfmal so lange: EC2-Starts 14,0 Stunden, Lambda 14,4, die Container-Dienste 14,6. Wiederherstellung ist ein Ansturm, bei dem jeder Kunde und jeder interne Dienst dieselben Control Planes gleichzeitig um dasselbe bittet. „Wir deployen einfach in der gesunden Zone neu" stellt Sie in diese Warteschlange.
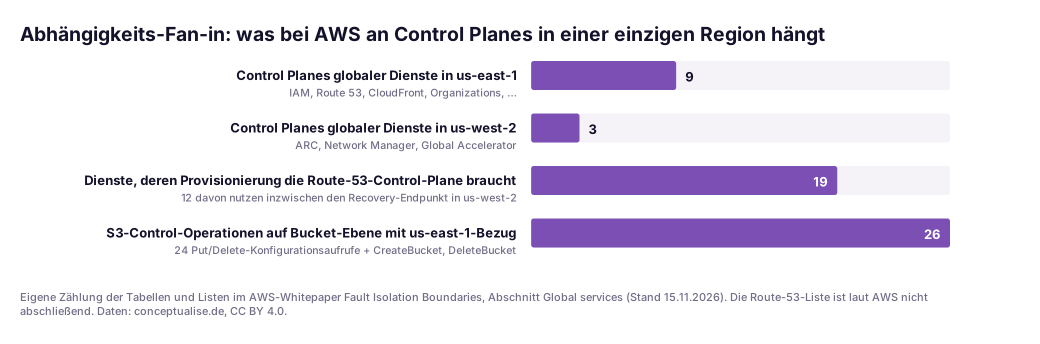
Das dritte Diagramm misst den Fan-in: wie viel an einer einzigen Stelle hängt. Wir haben die Zeilen im AWS-Whitepaper Fault Isolation Boundaries gezählt, in der im November 2026 aktuellen Fassung. Neun Control Planes globaler Dienste liegen in us-east-1, darunter IAM, Route 53, CloudFront und Organizations. Neunzehn namentlich genannte Dienste brauchen die Route-53-Control-Plane, um Ressourcen anzulegen, und AWS bezeichnet die Liste als nicht abschließend. Sechsundzwanzig S3-Control-Operationen auf Bucket-Ebene hängen an us-east-1, egal in welcher Region der Bucket liegt. Fairerweise: AWS veröffentlicht das und baut Notausgänge, 12 der 19 Dienste nutzen inzwischen einen Recovery-Endpunkt in us-west-2. Jeder Anbieter hat globale Control Planes; AWS dokumentiert seine nur besser als die meisten. Ihr Wiederherstellungspfad sollte keine davon berühren.
Aus einem aktuellen Projekt
Kürzlich haben wir die Resilienz der Azure-Umgebung eines europäischen Finanzdienstleisters geprüft, die über zwei Regionen lief und eigens für DORA aufgebaut worden war. Auf dem Papier war sie hervorragend: georeplizierte Datenbanken, Infrastructure as Code für alles und ein vierteljährlicher Failover-Test, der immer bestanden wurde.
Dann sind wir die sechs Fehlerpunkte mit dem Plattformteam durchgegangen, und das Bild kippte. Der Failover-Test bestand, weil er an einem ruhigen Dienstag lief, an dem jede Management Plane gesund war. Schritt eins des Runbooks war eine Pipeline, die die Anwendungsschicht in die Sekundärregion deployte, also eine Control-Plane-Aktion, die im Ernstfall mit allen anderen um Kapazität konkurriert. Schritt vier änderte einen DNS-Eintrag. Die Front-Door-Konfiguration für die Sekundärregion war nie ausgerollt worden, weil „die Pipeline sie anlegt". Und der privilegierte Zugriff der Betriebsmannschaft lief über einen Just-in-time-Workflow, der selbst von Anmeldediensten im betroffenen Pfad abhing.
Keine der Korrekturen war exotisch. Die Anwendungsschicht in der Sekundärregion läuft jetzt dauerhaft in reduzierter Größe und kann für einige Stunden den vollen Traffic tragen. Das Front-Door-Routing für beide Regionen ist vorkonfiguriert, Failover ist damit eine Prioritätsänderung und kein Deployment. Notfallkonten haben einen eigenen, getesteten Pfad. Und der Quartalstest läuft jetzt mit absichtlich nicht verfügbarer Pipeline und Portal. Der erste Test unter diesen Bedingungen scheiterte, und das war das nützlichste Ergebnis des Projekts. Die Kostendiskussion war kurz, als der Vorstand die Alternative schwarz auf weiß sah: „Unsere Wiederherstellung hängt an der Control Plane, die ausgefallen ist."
Die Checkliste für Control-Plane-Abhängigkeiten
Das ist der Teil für den Screenshot. Wenden Sie ihn auf jeden kritischen Workload an. Ein „Ja" in der dritten Spalte ist ein Befund.
| # | Fehlerpunkt | Prüffrage | Statisch stabile Antwort | Nachweis |
|---|---|---|---|---|
| 1 | Globaler Konfigurations-Push | Kann eine Konfigurationsänderung binnen Minuten jede Region oder Zelle erreichen? | Stufenweiser Rollout mit Wartezeit, synchrone Prüfung, geschützter Last-Known-Good-Stand, statisch bleiben | Rollout-Richtlinie, letzter Rollback-Test |
| 2 | DNS und Discovery | Hängt der Betrieb davon ab, dass Einträge während eines Vorfalls neu geschrieben werden? | Regionale Endpunkte, bewusste TTLs, Automatisierung verweigert leere Record-Sätze | DNS-Architektur, TTL-Register |
| 3 | Kapazität und Start | Erfordert die Wiederherstellung neue Instanzen oder Hochskalieren? | N/(N−1)-Kapazität je Zone; warme Sekundärregion für die ersten Stunden dimensioniert | Kapazitätsmodell, Lasttestergebnisse |
| 4 | Health Checks und Failover | Kann eine Automatik den Großteil Ihrer Kapazität auf einmal entfernen? | Health Checks prüfen die Auslieferung, Entfernungsrate begrenzt, Fail-open-Schwelle | Health-Check-Konfiguration, Chaos-Test |
| 5 | Identitätsausstellung | Braucht ein laufender Workload frische Tokens von einem globalen Endpunkt? | Regionale STS-/Token-Endpunkte, frühe Erneuerung, keine IAM-Änderungen im Failover | Übersicht Token-Laufzeiten, Notfallkonto-Test |
| 6 | Management Plane | Braucht Ihr Runbook Konsole, Management-API oder Pipeline? | Data-Plane-Schalter (Routing Controls, vorbereitetes DNS-Failover, Front-Door-Prioritäten) | Runbook, Testlauf mit „nicht verfügbarer" Management Plane |
| 7 | Anbieterstatus | Verlässt sich Ihre Erkennung auf die Statusseite des Anbieters? | Eigene synthetische Prüfungen von außerhalb des Anbieters | Abdeckung der Prüfungen, Alarmhistorie |
| 8 | SaaS von Dritten | Laufen kritische SaaS-Werkzeuge auf demselben Edge oder in derselben Region wie Sie? | Abhängigkeit kennen; manuellen Fallback für die kritischen haben | Register der Lieferantenabhängigkeiten |
Ein Hinweis: Statische Stabilität kostet Geld, denn vorab bereitgestellte Kapazität wird auch bezahlt, wenn nichts passiert. Kalkulieren Sie pro Workload-Stufe. Ein internes Reporting-Werkzeug kann auf den Anbieter warten, Ihr Zahlungsverkehr nicht.
Governance für europäische Unternehmen
DORA. Für Banken, Versicherer, Wertpapierfirmen und andere Finanzunternehmen gilt die Verordnung (EU) 2022/2554 seit dem 17. Januar 2025. Artikel 11 verlangt eine Leitlinie zur IKT-Geschäftsfortführung sowie Reaktions- und Wiederherstellungspläne für kritische oder wichtige Funktionen. Artikel 28 Absatz 8 wird deutlicher: Für IKT-Dienstleistungen, die solche Funktionen unterstützen, müssen Finanzunternehmen Ausstiegsstrategien festlegen, und die Ausstiegspläne müssen ausreichend getestet und regelmäßig überprüft werden. Die Benennung von AWS, Google Cloud und Microsoft als kritische IKT-Drittdienstleister stellt diese Anbieter unter direkte Aufsicht, Ihre eigenen Pflichten bleiben aber bei Ihnen: Ein Wiederherstellungsschritt, der an der Control Plane des Anbieters hängt, ist eine Abhängigkeit, die Sie benennen, testen und dokumentieren müssen. Die Ausstiegsseite behandeln wir in unserem Cloud-Exit-Runbook für DORA, die Umsetzung in unserem Leitfaden zu DORA auf Azure.
NIS2. Für wichtige und besonders wichtige Einrichtungen außerhalb des Finanzsektors nennt Artikel 21 Absatz 2 Buchstabe c der Richtlinie (EU) 2022/2555 die Aufrechterhaltung des Betriebs, etwa Backup-Management und Wiederherstellung nach einem Notfall, sowie Krisenmanagement als Mindestmaßnahme. Das deutsche NIS2-Umsetzungsgesetz gilt seit dem 6. Dezember 2025 ohne Übergangsfrist. Die Checkliste oben ist ein angemessener, verhältnismäßiger Weg, nachzuweisen, dass die Notfallplanung berücksichtigt, wie Cloud-Anbieter tatsächlich ausfallen.
Souveränität ist eine andere Frage. Souveräne Cloud-Angebote ändern, wer eine Control Plane betreibt und unter welchem Recht, nicht, wie oft sie ausfällt. Stellen Sie jedem Anbieter dieselben sechs Fragen.
Ein pragmatischer Einführungspfad
- Woche 1–2: Abhängigkeiten kartieren. Gehen Sie für jeden kritischen Workload die sechs Fehlerpunkte durch und listen Sie jeden Control-Plane-Aufruf im Betrieb und in der Wiederherstellung auf. Identität, DNS und CI/CD-Pipeline gehören dazu.
- Woche 3–4: Management Plane aus dem Runbook entfernen. Stellen Sie die Sekundärumgebung vorab bereit. Konfigurieren Sie das Routing so, dass Failover ein Schalter ist: Prioritäten in Front Door oder Traffic Manager auf Azure, Routing Controls des Application Recovery Controller oder vorbereitetes DNS-Failover mit Health Checks auf AWS. Aktivieren Sie Route 53 Accelerated Recovery für relevante öffentliche Zonen.
- Monat 2: Kapazität und Identität korrigieren. Dimensionieren Sie zonale Kapazität mit N/(N−1). Legen Sie fest, wie warm die Sekundärregion für die ersten Stunden sein muss. Stellen Sie auf regionale Token-Endpunkte um und prüfen Sie Token-Laufzeiten und Notfallzugänge.
- Monat 3: eigene Control Planes härten. Übertragen Sie die Lehren der Anbieter auf Ihre eigenen Konfigurations-Pushes, Feature Flags und DNS-Automatisierung: stufenweiser Rollout, synchrone Prüfung, geschützter Last-Known-Good-Stand, statisch bleiben. Unser Leitfaden zu zellbasierter Architektur zeigt, wie Konfiguration einen kleineren Schadensradius als „alles" bekommt.
- Jedes Quartal: realistisch testen. Üben Sie Failover mit absichtlich nicht verfügbarer Konsole, Pipeline und interaktiver Anmeldung, und ergänzen Sie externe synthetische Prüfungen. Die Datenreplikation behandelt unser Leitfaden zu Multi-Region-Disaster-Recovery auf Azure.
Das Fazit
Die Data Planes der Hyperscaler sind sehr gut. Die Ausfälle 2025 und 2026 passierten, weil die Systeme versagten, die Server, Konfiguration und DNS verändern, und die Wiederherstellung sich hinter ihnen anstellte. Die Anbieter beheben ihre Seite öffentlich: stufenweise Konfiguration, Ratenbegrenzung, Standby-Control-Planes, Zellisolation. Nichts davon hilft einem Workload, dessen Wiederherstellungsplan „im Ernstfall neu deployen" lautet.
Unsere Position ist einfach. Entwerfen Sie jeden kritischen Workload so, dass das Überstehen eines Anbieter-Vorfalls keine neue Aktion einer Control Plane des Anbieters braucht. Vorab bereitstellen statt skalieren. Cachen statt abrufen. Einen vorbereiteten Schalter umlegen statt eine Pipeline starten. Und testen Sie das mit abgeschalteter Management Plane, denn nur dieser Test ähnelt dem Ernstfall. Weitere Muster finden Sie in unserem Spickzettel für Resilienzmuster.
Wenn Sie einen zweiten Blick auf Ihr Notfalldesign wünschen: Unser Cloud-Architektur-Team führt diese Sechs-Punkte-Prüfung als kurzes Projekt mit festem Umfang durch. Am Ende haben Sie die Checkliste für Ihre eigenen kritischen Workloads ausgefüllt.
FAQ
Was ist der Unterschied zwischen Control Plane und Data Plane in der Cloud?
Die Control Plane ist die Mechanik, die etwas verändert: Ressourcen anlegen, konfigurieren, skalieren und löschen, Zugangsdaten ausstellen, DNS-Records veröffentlichen und Konfiguration verteilen. Die Data Plane erledigt das Tagesgeschäft: Anfragen beantworten, DNS-Abfragen auflösen, Pakete transportieren, Daten lesen und schreiben. Die Azure-Dokumentation formuliert es so: Ein Speicherkonto legen Sie über die Control Plane an, Daten lesen und schreiben Sie über die Data Plane. Control Planes sind komplexer und ändern sich häufiger, deshalb muss ein resilientes Design über die Data Plane weiterarbeiten, während eine Control Plane ausfällt.
Was bedeutet statische Stabilität?
Statische Stabilität ist ein Designprinzip, das AWS in der Builders' Library beschreibt: In einem statisch stabilen Design arbeitet das Gesamtsystem weiter, auch wenn eine Abhängigkeit beeinträchtigt ist. Praktisch heißt das, dass die Wiederherstellung nach einem Fehler keine neue Aktion einer Control Plane erfordert. Kapazität ist in jeder Zone bereits bereitgestellt, Zugangsdaten sind bereits ausgestellt, DNS-Antworten liegen im Cache, und Traffic lässt sich über Schalter umleiten, die in der Data Plane liegen.
Was hat den AWS-Ausfall in us-east-1 am 19. und 20. Oktober 2025 verursacht?
Laut Post-Incident-Summary von AWS eine Race Condition in der automatisierten DNS-Verwaltung von DynamoDB. Ein verzögerter DNS Enactor spielte einen älteren Plan über einen neueren ein, ein Bereinigungsprozess löschte diesen Plan anschließend. Ab 23:48 Uhr PDT am 19. Oktober hatte der regionale DynamoDB-Endpunkt damit einen leeren DNS-Eintrag. DNS war um 2:25 Uhr wiederhergestellt, aber das Instanzmanagement von EC2, die Health Checks des Network Load Balancer und Dienste wie Lambda und STS brauchten deutlich länger. AWS nennt 14:20 Uhr PDT am 20. Oktober als Ende, rund 14,5 Stunden nach Beginn.
Was hat den Azure-Front-Door-Ausfall am 29. Oktober 2025 verursacht?
Laut Post Incident Review von Microsoft (Tracking-ID YKYN-BWZ) erzeugten gültige Kundenkonfigurationsänderungen über zwei verschiedene Build-Versionen der Control Plane hinweg inkompatible Konfigurationsmetadaten. Diese lösten bei der asynchronen Verarbeitung in der Data Plane einen Absturz aus. Weil der Absturz asynchron auftrat, bestanden die Health Checks während des Rollouts, und die fehlerhafte Konfiguration verbreitete sich weltweit. Kunden waren von 15:41 Uhr UTC am 29. Oktober bis 00:05 Uhr UTC am 30. Oktober 2025 betroffen.
Ist Multi-Cloud die Antwort auf Hyperscaler-Ausfälle?
Für eine komplette Anwendung meist nicht. Dieselbe Anwendung aktiv in zwei Clouds zu betreiben, verdoppelt die Betriebsfläche und schafft oft einen neuen Single Point of Failure in der Schicht, die über die Cloud entscheidet. Für die meisten Unternehmen bringt es mehr, jeden Workload innerhalb eines Anbieters statisch stabil zu machen: vorab bereitgestellte Kapazität über Zonen, eine warme zweite Region, regionale Endpunkte und Failover-Schalter in der Data Plane. Mehrere Anbieter lohnen sich an gezielten Engstellen wie DNS, CDN oder Edge und beim Notfallzugang zur Identität.
Welche EU-Vorschriften verlangen, dass wir Ausfälle von Cloud-Anbietern einplanen?
Für Finanzunternehmen gilt DORA seit dem 17. Januar 2025. Die Verordnung verlangt eine Leitlinie zur IKT-Geschäftsfortführung (Artikel 11) sowie dokumentierte, getestete Ausstiegsstrategien für IKT-Dienstleistungen, die kritische oder wichtige Funktionen unterstützen (Artikel 28 Absatz 8). Im November 2025 haben die Europäischen Aufsichtsbehörden eine Liste von 19 benannten kritischen IKT-Drittdienstleistern veröffentlicht, darunter die EU-Gesellschaften von AWS, Google Cloud und Microsoft. Für wichtige und besonders wichtige Einrichtungen verlangt NIS2 in Artikel 21 Absatz 2 Buchstabe c Aufrechterhaltung des Betriebs, Backup-Management, Wiederherstellung nach einem Notfall und Krisenmanagement. Das deutsche NIS2-Umsetzungsgesetz gilt seit dem 6. Dezember 2025.
Quellen
Alle Quellen geprüft am 15. November 2026. Die Dauern in den Diagrammen sind aus den Start- und Endzeiten berechnet, die jeder Anbieter in seinem eigenen Report nennt; die CSV hält fest, welche Endzeit wir verwendet haben.
Tier A: Primärquellen, Post-Incident-Reports, Anbieterdokumentation und Rechtstexte
- AWS, Summary of the Amazon DynamoDB Service Disruption in the Northern Virginia Region (us-east-1), Oktober 2025: https://aws.amazon.com/message/101925/
- AWS, Summary of the AWS Service Event in the Northern Virginia (US-EAST-1) Region, Dezember 2021: https://aws.amazon.com/message/12721/
- Microsoft Azure, Post Incident Review YKYN-BWZ (Azure Front Door, 29. Oktober 2025) sowie PIRs 7QL5-Z50 und 7Q30-010 (September 2026): https://azure.status.microsoft/en-us/status/history/
- Google Cloud, Incident Report vom 12. Juni 2025: https://status.cloud.google.com/incidents/ow5i3PPK96RduMcb1SsW
- Cloudflare, Cloudflare outage on November 18, 2025: https://blog.cloudflare.com/18-november-2025-outage/
- CrowdStrike, Technical details: Falcon content update for Windows hosts: https://www.crowdstrike.com/en-us/blog/falcon-update-for-windows-hosts-technical-details/
- AWS, Whitepaper Fault Isolation Boundaries, Global services: https://docs.aws.amazon.com/whitepapers/latest/aws-fault-isolation-boundaries/global-services.html
- AWS, Route 53 Accelerated Recovery für öffentliche DNS-Einträge: https://docs.aws.amazon.com/Route53/latest/DeveloperGuide/accelerated-recovery.html
- Microsoft Learn, Control plane and data plane operations (Azure Resource Manager): https://learn.microsoft.com/de-de/azure/azure-resource-manager/management/control-plane-and-data-plane
- Microsoft Learn, Redundanz, Replikation und Sicherung (N/(N−1)-Überdimensionierung): https://learn.microsoft.com/de-de/azure/reliability/concept-redundancy-replication-backup
- Verordnung (EU) 2022/2554 (DORA), Artikel 11, 28 und 31: https://eur-lex.europa.eu/eli/reg/2022/2554/oj/deu
- Europäische Aufsichtsbehörden, Liste der benannten kritischen IKT-Drittdienstleister: https://www.esma.europa.eu/sites/default/files/2025-11/List_of_designated_CTPPs.pdf
- Richtlinie (EU) 2022/2555 (NIS2), Artikel 21: https://eur-lex.europa.eu/eli/dir/2022/2555/oj/deu
Tier B: technische Analysen
- Mike Furr, Static stability using Availability Zones, Amazon Builders' Library (2019): https://builder.aws.com/content/3K9SiqiJ369TGkkGzqPM95BuYWI/static-stability-using-availability-zones
- Microsoft Azure Networking Blog, Azure Front Door: Implementing lessons learned following October outages (Dezember 2025): https://techcommunity.microsoft.com/blog/azurenetworkingblog/-/4479416
Tier C: Anbieteraussagen, richtungsweisend
- Microsoft, Helping our customers through the CrowdStrike outage (20. Juli 2024): https://blogs.microsoft.com/blog/2024/07/20/helping-our-customers-through-the-crowdstrike-outage/
Themen