Resilience Patterns Spickzettel: 12 Muster + A2-Poster
Zwölf Resilienzmuster auf einem A2-Poster: Retries mit Jitter, Circuit Breaker, Bulkheads, Load Shedding. Mit Einsatzregeln und Retry-Sturm-Simulation.
Am 12. Juni 2025 gegen 10:45 Uhr pazifischer Zeit erreichte eine Policy-Änderung mit leeren Feldern den Service Control von Google Cloud, das System, das API-Anfragen prüft. Sie traf einen Null-Pointer und schickte die Binaries weltweit in eine Crash-Schleife. Das war der Bug. Die meisten Regionen waren nach zwei Stunden wieder da. us-central1 brauchte bis zu etwa 2 Stunden 40 Minuten, und der Grund war die Wiederherstellung. Als die Tasks gemeinsam neu starteten, entstand laut Google-Vorfallbericht ein Herdeneffekt („herd effect“) auf der darunterliegenden Infrastruktur, weil Service Control kein randomisiertes exponentielles Backoff implementiert hatte. Vier Monate später beschrieb AWS im Bericht zum Ausfall von us-east-1 am 19. und 20. Oktober 2025 ein weiteres Subsystem, das in einen „state of congestive collapse“ geraten war und keinen Fortschritt mehr machte. Die Ingenieure mussten eingehende Arbeit drosseln, um es wieder in Gang zu bringen.
Keines der Muster, die geholfen hätten, ist neu. Was in den meisten Landschaften fehlt, ist die Übersicht auf einer Seite: Welches Muster löst welches Problem, und wann macht dasselbe Muster es schlimmer? Dieser Spickzettel richtet sich an die Menschen, die diese Entscheidungen treffen: Architektinnen und Architekten, SRE- und Plattform-Leads und die CTOs, die Verfügbarkeitszusagen unterschreiben. Dazu gibt es ein druckfertiges A2-Poster und eine kleine Retry-Sturm-Simulation, die Sie selbst ausführen und hinterfragen können.
TL;DR / Das Wichtigste in Kürze
- Retries sind Last, keine Gratisversicherung. Drei Retries auf drei Schichten bedeuten bis zu 64 Versuche an der Datenbank für eine Nutzeraktion. In unserem Modell sieht eine unterste Abhängigkeit, die zu 99 Prozent scheitert, schon das 47-Fache an Last.
- Jitter ist Pflicht. Als in unserer Simulation 2.000 Clients gleichzeitig scheiterten, brauchte exponentielles Backoff ohne Jitter 52 Sekunden, bis alle bedient waren. Decorrelated Jitter schaffte es in etwa 6, Full Jitter in etwa 15. Ohne Jitter lief der Server zwischen synchronen Retry-Wellen leer.
- Deadlines schlagen raffiniertes Backoff. Mit unbegrenzter Warteschlange und ohne Deadline-Prüfung erholten sich sofortige und feste Retries nie: Über 99 Prozent der Serverarbeit gingen an Anfragen, deren Clients längst aufgegeben hatten. Abgelaufene Anfragen zu verwerfen brachte jede Strategie in unter 8 Sekunden zurück.
- Budgets und Load Shedding beenden Ausfälle. Eine Studie von 2022 zu 22 öffentlichen Vorfällen fand die Retry-Policy in mehr als der Hälfte als aufrechterhaltenden Effekt; Load Shedding war der häufigste Ausweg.
- Die Aufsicht fragt nach dem Ergebnis. Art. 7 DORA verlangt Kapazität für Spitzen und Resilienz unter Stress. Ab 11. Dezember 2027 verlangt die Cyberresilienzverordnung, dass Produkte die Verfügbarkeit anderer Dienste nicht beeinträchtigen. Beides belegen Sie mit den Mustern unten.

Download: Editierbare draw.io-Datei · In diagrams.net öffnen · A2-Poster (PDF) · Diagrammdaten (CSV) · Simulationscode (Python)
Warum das jetzt zählt
Ausfälle entstehen heute in der Wiederherstellung, nicht beim ersten Fehler. Die Forschung nennt das metastabilen Ausfall. Bronson und Kollegen beschrieben ihn auf der HotOS 2021 als schlechten Zustand, der bestehen bleibt, „even when the trigger is removed“. Huang et al. untersuchten auf der OSDI 2022 dann 22 öffentliche Vorfälle aus 11 Organisationen. Ihr Befund: Der mit Abstand häufigste aufrechterhaltende Effekt ist die Retry-Policy, betroffen sind mehr als 50 Prozent der Vorfälle. Load Shedding war die häufigste Gegenmaßnahme, eingesetzt in über der Hälfte. Der Auslöser ist meist banal: ein Deployment, eine Konfigurationsänderung, ein kurzer Netzwerk-Aussetzer. Die Rückkopplung hält Sie dann stundenlang unten.
Defaults übernehmen viel, sind aber nicht auf Sie abgestimmt. AddStandardResilienceHandler von Microsoft für .NET verkettet fünf Strategien mit vernünftigen Defaults: 30 Sekunden Gesamt-Timeout, drei Retries mit exponentiellem Backoff und Jitter, ein Circuit Breaker bei 10 Prozent Fehlerquote und 10 Sekunden Timeout je Versuch. Envoy erlaubt standardmäßig 1.024 wartende Anfragen und drei gleichzeitige Retries je Cluster. Die Python-SDKs von OpenAI und Anthropic wiederholen standardmäßig je zweimal. Die Folge: Ein typischer Aufrufpfad hat drei oder vier Retry-Schichten, die niemand gemeinsam entworfen hat.
Traffic kommt stoßweiser. Batch-Jobs, Event-Fan-outs und KI-Agenten, die in Schleifen Tools aufrufen, erzeugen synchrone Last, genau den Fall, in dem Jitter am meisten zählt.
Die 12 Muster, Familie für Familie
Das Poster ordnet die Muster nach ihrer Aufgabe. A begrenzt, wie lange jemand wartet. B hält einen Fehler in der Komponente, die ihn hat. C schützt die Kapazität, wenn die Nachfrage sie übersteigt. D lässt das System weich scheitern und sicher wiederholen.
① Timeouts und Deadlines
Jeder Netzwerkaufruf braucht einen Timeout, und der Bibliotheks-Default ist selten der richtige. Die AWS Builders' Library empfiehlt, ihn aus der gemessenen Latenz des Aufgerufenen abzuleiten; ihr Beispiel nimmt das p99,9 der Abhängigkeit und akzeptiert 0,1 Prozent unnötige Timeouts. Ein innerer Timeout muss kürzer sein als der äußere, sonst gibt der Aufrufer auf, während der Aufgerufene noch arbeitet. Und reichen Sie eine Deadline weiter, nicht nur einen Timeout. Das Google-SRE-Buch empfiehlt Deadline Propagation: Das Frontend setzt die Deadline, jeder Hop gibt die verbleibende Zeit weiter, und kein Backend beginnt Arbeit, die sein Aufrufer schon aufgegeben hat. gRPC kann das nativ, über HTTP brauchen Sie einen Header und etwas Middleware.
Was niemand vorführt, ist die Serverseite. Ein Server ohne Deadline-Prüfung bedient weiter Anfragen, deren Clients längst im Timeout sind. In unserer Simulation entschied genau diese Lücke, ob sich das System überhaupt erholte.
② Retries mit Backoff und Jitter
Wiederholen Sie nur, was beim nächsten Mal wahrscheinlich gelingt: Verbindungsabbrüche, 503, 429 mit Retry-After und Timeouts bei idempotenten Aufrufen. Keine Validierungsfehler, keine nicht idempotenten Schreibzugriffe ohne Schlüssel (Muster ⑪). Nutzen Sie exponentielles Backoff mit Obergrenze und immer mit Jitter. Marc Brooker verglich die Varianten 2015 im AWS Architecture Blog: Backoff ohne Jitter schnitt am schlechtesten ab, Full und Decorrelated Jitter senkten die Arbeit deutlich. Die Builders' Library nennt Retries „selfish“: Ein wiederholender Client verbraucht mehr Serverzeit, um die eigene Erfolgschance zu erhöhen.
Unsere Simulation unten zeigt dasselbe Muster mit einem anderen Servermodell. Ohne Jitter kommen Retries in Wellen, die der Server nur teilweise aufnehmen kann, und dazwischen steht er still.
③ Retry-Budgets
Ein Limit je Anfrage wie „höchstens drei Versuche“ reicht nicht: Im echten Ausfall schöpft jede Anfrage ihr Limit voll aus. Das Google-SRE-Buch ergänzt deshalb ein Retry-Budget je Client: Wiederholt wird nur, solange das Verhältnis von Retries zu Anfragen unter 10 Prozent liegt, was das Wachstum im Normalfall auf das 1,1-Fache begrenzt. Außerdem soll nur die Schicht direkt über der abweisenden Schicht wiederholen, weil sich gestapelte Retries multiplizieren. Das Beispiel im Buch: 64 Versuche an der Datenbank (4 × 4 × 4) für eine Nutzeraktion.
Die AWS-SDKs begrenzen Retries seit 2016 mit einem lokalen Token Bucket. retryThrottling in gRPC zieht bei jedem Fehler ein Token ab und pausiert Retries, wenn der Bestand unter die Hälfte fällt. retry_budget in Envoy steht, sobald aktiviert, standardmäßig bei 20 Prozent der aktiven Anfragen. Wenn Sie nach diesem Artikel nur eine Sache einstellen, dann ein Budget.
④ Circuit Breaker
Ein Circuit Breaker beobachtet die Aufrufe einer Abhängigkeit. Überschreiten die Fehler eine Schwelle, öffnet er und scheitert eine Zeit lang sofort, statt jeden Aufrufer in den Timeout laufen zu lassen. Nach einer Pause wird er halboffen und lässt einen Testaufruf durch; gelingt er, schließt der Breaker wieder. Martin Fowler schreibt die Popularisierung 2014 Michael Nygards Buch Release It! zu. Polly 8, Resilience4j 2 und die Outlier Detection von Envoy setzen das Muster um.
In der Praxis geht dreierlei schief: Stichproben so klein, dass eine langsame Anfrage den Breaker auslöst, ein Breaker für viele Hosts und niemand, der festlegt, was bei offenem Breaker passiert. Der Standard-Handler von Microsoft setzt den Breaker innerhalb des Retrys, mit einem Mindestdurchsatz von 100 Aufrufen in 30 Sekunden. So hält der Breaker die Retries von einer bereits ausgefallenen Abhängigkeit fern.
⑤ Bulkhead (Schott)
Ein Bulkhead gibt jeder Abhängigkeit, jedem Mandanten oder jeder Lastklasse einen eigenen, begrenzten Anteil an Threads, Verbindungen oder Speicher. Wird eine Abhängigkeit langsam, läuft nur ihr Abteil voll. Ohne Schotten leert ein langsamer Aufrufpfad den gemeinsamen Pool und reißt unbeteiligte Funktionen mit.
Resilience4j hat ein eigenes Bulkhead-Modul. Polly 8 hat kein separates Bulkhead mehr und nutzt stattdessen einen Concurrency Limiter (AddConcurrencyLimiter) aus dem Rate-Limiting-Paket. Im Flottenmaßstab wird daraus zellbasierte Architektur, die wir in zellbasierte Architektur und Blast Radius beschreiben. Der typische Fehler sind zu viele winzige Pools, in denen normale Spitzen warten. Messen Sie Abweisungen je Pool vom ersten Tag an.
⑥ Health Checks
Health Checks entscheiden, wohin Traffic fließt und welche Prozesse neu starten. Wer beide Aufgaben vermischt, macht den Check selbst zum Ausfall. Die Kubernetes-Dokumentation warnt ausdrücklich, dass falsch konfigurierte Liveness-Probes zu Neustarts unter hoher Last und zu kaskadierenden Ausfällen führen können. Nutzen Sie Readiness, um eine Instanz aus der Rotation zu nehmen, und Liveness nur, um einen hängenden Prozess zu erkennen. Keiner von beiden sollte Ihre Datenbank aufrufen, sonst meldet ein einziger gemeinsamer Ausfall die ganze Flotte gleichzeitig als ungesund.
Der AWS-Ausfall im Oktober 2025 zeigte dasselbe Risiko auf Load-Balancer-Ebene: Health Checks wechselten zwischen fehlerhaft und gesund und nahmen Kapazität aus dem Dienst. AWS will das mit einer Geschwindigkeitsbegrenzung lösen, die limitiert, wie viel Kapazität ein einzelner Load Balancer entfernen darf. Bauen Sie dieselbe Bremse in Ihre eigene Failover-Automatisierung ein.
⑦ Rate Limiting
Rate Limiting schützt einen geteilten Dienst vor einzelnen Clients. Es wirkt je Aufrufer: ein Kontingent je API-Key, Mandant oder IP, durchgesetzt am Rand (API Management, API-Gateway oder Envoy), mit 429 Too Many Requests und einem Retry-After-Header, damit sich gut erzogene Clients zurückhalten. Der Standard-Handler von Microsoft setzt zusätzlich ganz außen einen clientseitigen Concurrency Limiter mit standardmäßig 1.000 Permits.
Rate Limiting ist kein Überlastschutz. Kontingente sind statisch, echte Kapazität ändert sich mit jedem Deployment, jedem Cache-Zustand und jedem lauten Nachbarn. Ein Server kann überlastet sein, während jeder Client innerhalb seines Kontingents liegt.
⑧ Load Shedding
Load Shedding heißt, dass der Server rechtzeitig „jetzt nicht“ sagt: Jenseits einer Grenze für Parallelität oder Warteschlangenalter weist er neue Arbeit früh und billig ab, damit angenommene Arbeit fertig wird. David Yanacek beschreibt das Ziel in der Builders' Library als Schutz des Goodput, also des Durchsatzes, der ohne Fehler und so schnell bearbeitet wird, dass der Client die Antwort noch nutzen kann. Seine Praxisregeln: Abweisen muss früh und billig sein. Niedrige Prioritäten zuerst abweisen. Health Checks des Load Balancers schützen, die er die wichtigste Anfrage eines Servers nennt, sonst schrumpft die Flotte mitten im Brownout. Das Google-SRE-Buch macht dasselbe mit Kritikalitätsstufen von CRITICAL_PLUS bis SHEDDABLE.
Load Shedding ist auch der Weg aus metastabilen Ausfällen, und es wirkt am besten, wenn es eingebaut und getestet ist, statt um 3 Uhr nachts von Hand eingeschaltet zu werden.
⑨ Queue-basierter Lastausgleich
Eine Warteschlange zwischen Produzenten und Workern glättet Spitzen asynchroner Arbeit zu einem gleichmäßigen Strom. Drei Regeln halten sie ehrlich: die Queue begrenzen, Einträge mit abgelaufener Deadline verwerfen oder in die Dead-Letter-Queue legen, und Worker nach dem Alter der Queue skalieren, nicht nur nach ihrer Länge.
Das Antimuster ist ein synchroner Aufrufer hinter einer unbegrenzten Queue. Die Latenz bleibt unsichtbar, bis die Queue Minuten lang ist; dann laufen alle gleichzeitig in den Timeout, und die Retries beginnen. Das SRE-Buch rät zu kleinen Queues im Verhältnis zum Thread-Pool und unter Überlast zu LIFO oder CoDel. Unsere Simulation zeigt, warum eine unbegrenzte Queue ohne Deadline-Prüfung das schlechteste getestete Setup ist.
⑩ Fallback und Degradation
Ein Fallback liefert etwas Brauchbares, wenn die eigentliche Antwort fehlt: Empfehlungen ohne Personalisierung, ein Preis mit dem Vermerk „Stand 10:02 Uhr“, ein Checkout, der die Bestätigungsmail in die Warteschlange stellt. Polly 8 hat eine Fallback-Strategie. Gute Fallbacks sind aber vor allem Produktentscheidungen, keine Bibliothekseinstellungen.
Fallbacks scheitern auf zwei Arten: Sie rufen einen weiteren fragilen Dienst auf, oder sie laufen nie, bis sie gebraucht werden, und funktionieren dann nicht. Testen Sie sie, indem Sie den primären Pfad gezielt ausfallen lassen. Statische Stabilität, bei der ein System bei ausgefallener Control Plane mit dem letzten bekannten guten Zustand weiterläuft, ist die Infrastruktur-Variante dieses Musters. Unsere Anatomie eines Hyperscaler-Ausfalls behandelt sie ausführlich.
⑪ Idempotenzschlüssel
Retries sind nur sicher, wenn eine wiederholte Anfrage ihre Wirkung nicht wiederholt. Schreibzugriffe brauchen dafür einen Idempotenzschlüssel. Der Client erzeugt je logischer Operation einen eindeutigen Schlüssel, der Server speichert das Ergebnis und liefert es bei jedem Retry mit demselben Schlüssel erneut. Die API von Stripe ist das Referenzdesign: Schlüssel bis 255 Zeichen, zufällig (empfohlen sind V4-UUIDs), Bereinigung frühestens nach 24 Stunden, und der Server weist einen wiederverwendeten Schlüssel mit abweichenden Parametern ab. Die IETF standardisiert einen HTTP-Header Idempotency-Key; mit Version 08 vom 22. Oktober 2026 ist er weiterhin ein Internet-Draft, kein RFC.
Zwei Vorsichtsregeln. Bauen Sie Schlüssel nicht aus personenbezogenen Daten; Stripe rät ausdrücklich davon ab. Und sorgen Sie dafür, dass Schlüssel das gesamte Retry-Fenster des Clients überdauern, auch für Retries aus Warteschlangen oder nach Offline-Phasen. Das gilt besonders für APIs, die KI-Agenten aufrufen, siehe API-Design für KI-Agenten.
⑫ Hedged Requests
Hedging zielt auf die Tail-Latenz, nicht auf Fehler. Ist eine Anfrage nach kurzer Zeit noch offen, geht eine zweite Kopie an ein anderes Replikat; die erste Antwort gewinnt, die andere Anfrage wird abgebrochen. Dean und Barroso berichten in „The Tail at Scale“ (CACM, 2013) von einem Google-Benchmark, der 1.000 Schlüssel aus BigTable über 100 Server liest. Ein Hedge nach 10 ms senkte die Latenz im 99,9. Perzentil von 1.800 ms auf 74 ms, bei nur 2 Prozent mehr Anfragen. Die Autoren empfehlen, etwa bis zum 95. Perzentil zu warten, was die Zusatzlast auf rund 5 Prozent begrenzt.
Hedging gehört zu idempotenten Lesezugriffen. Schädlich ist es, wenn die Langsamkeit von Überlast kommt, denn dann erhöhen Hedges die Last genau im falschen Moment. gRPC begrenzt Hedging auf fünf Versuche und wendet dieselbe Retry-Drosselung an. AddStandardHedgingHandler von Microsoft hält einen Circuit Breaker je Endpunkt, damit nicht gegen einen bereits kranken Endpunkt gehedgt wird.
Was die Zahlen sagen: ein simulierter Retry-Sturm
Wir wollten wissen, was Retry-Policy und Serverdesign nach einem synchronen Ausfall mit der Erholung machen. Dafür haben wir eine kleine zeitdiskrete Simulation in reinem Python geschrieben und mit diesem Artikel veröffentlicht. Die Methode:
- Auslöser. 2.000 Clients verlieren im selben Augenblick ihre laufende Anfrage, etwa nach dem Neustart einer Abhängigkeit oder wenn ein Load Balancer Verbindungen kappt. Jeder braucht eine erfolgreiche Antwort.
- Server. Ein FIFO-Server mit 500 Anfragen pro Sekunde, simuliert in 10-ms-Schritten. Der Ansturm entspricht also 4 Sekunden Kapazität.
- Client. 1 Sekunde Timeout je Versuch, dann eine Pause nach Retry-Policy (Basis 0,5 s, Obergrenze 20 s), dann der nächste Versuch, bis zum Erfolg oder bis 120 Sekunden.
- Servervarianten. Begrenzt: Die Queue fasst höchstens 250 Anfragen (0,5 s Arbeit) und weist den Rest sofort und kostenlos ab. Unbegrenzt: Alles wird eingereiht, Deadlines werden ignoriert. Unbegrenzt mit Verwerfen: Alles wird eingereiht, aber Anfragen, deren Client schon aufgegeben hat, werden beim Entnehmen verworfen.
- Policies. Kein Backoff, fest 0,5 s, exponentiell ohne Jitter sowie die drei Jitter-Varianten aus Brookers Beitrag: Equal, Full und Decorrelated.
- Läufe. 25 Seeds je Konfiguration, berichtet wird der Median; Diagramm 1 zeigt Seed 0. Diagramm 4 ist eine geschlossene Rechnung, per Monte-Carlo geprüft.
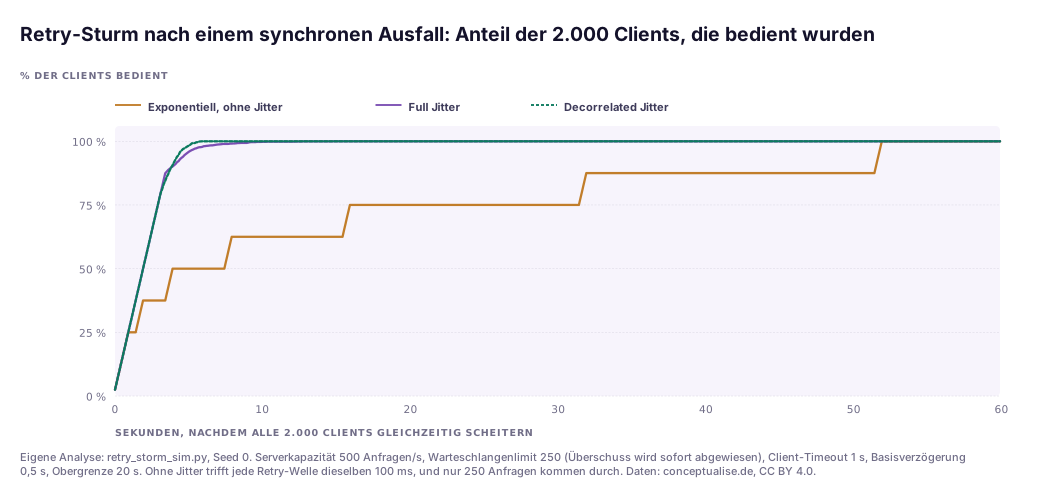
Die Treppe erzählt die Geschichte. Mit exponentiellem Backoff ohne Jitter wiederholen alle gemeinsam abgewiesenen Clients auch gemeinsam: nach 0,5, 1, 2, 4, 8 und 16 Sekunden, dann an der Obergrenze von 20 Sekunden. Die begrenzte Queue nimmt je Welle 250 Anfragen an und weist den Rest ab, dann wartet der Server auf die nächste Welle. Der letzte Client kommt nach 52 Sekunden durch, obwohl der Server kaum 4 davon beschäftigt war. Decorrelated Jitter bediente alle in etwa 6 Sekunden, Full Jitter in etwa 15. Die Jitter-Kurven sind glatt, weil die Ankünfte nicht mehr übereinanderliegen.
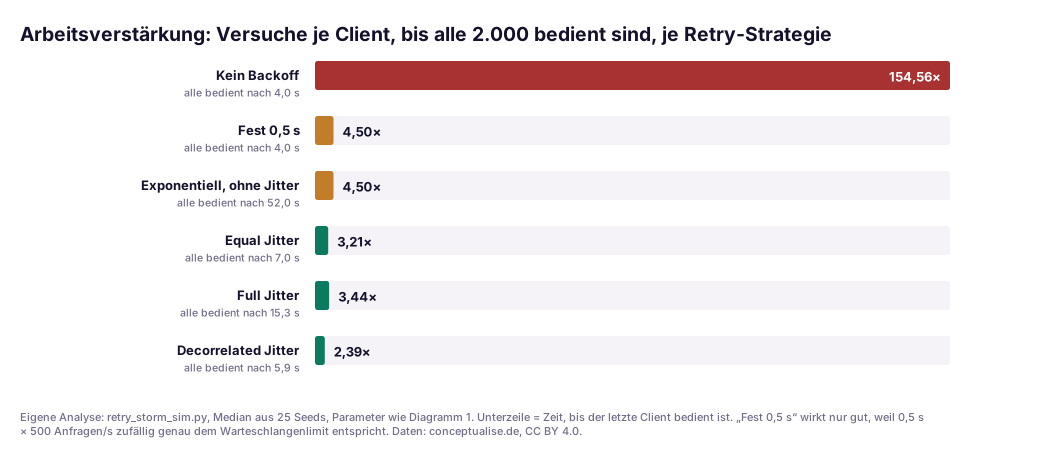
Die Arbeit erzählt die andere Hälfte. Ohne jedes Backoff war das idealisierte Modell am schnellsten fertig, brauchte dafür aber 155 Versuche je Client, mit Spitzen beim 351-Fachen der Kapazität je 100 ms. Das geht nur, weil Abweisen hier kostenlos ist; in echten Systemen ist es das nicht. Exponentiell ohne Jitter brauchte 4,5 Versuche je Client, Equal, Full und Decorrelated Jitter 3,2, 3,4 und 2,4. Ehrlicherweise: Das feste Intervall von 0,5 Sekunden wirkt nur so gut, weil 0,5 s × 500 Anfragen pro Sekunde zufällig genau dem Queue-Limit entspricht. Ändern Sie eine der Zahlen, und der Vorteil ist weg.
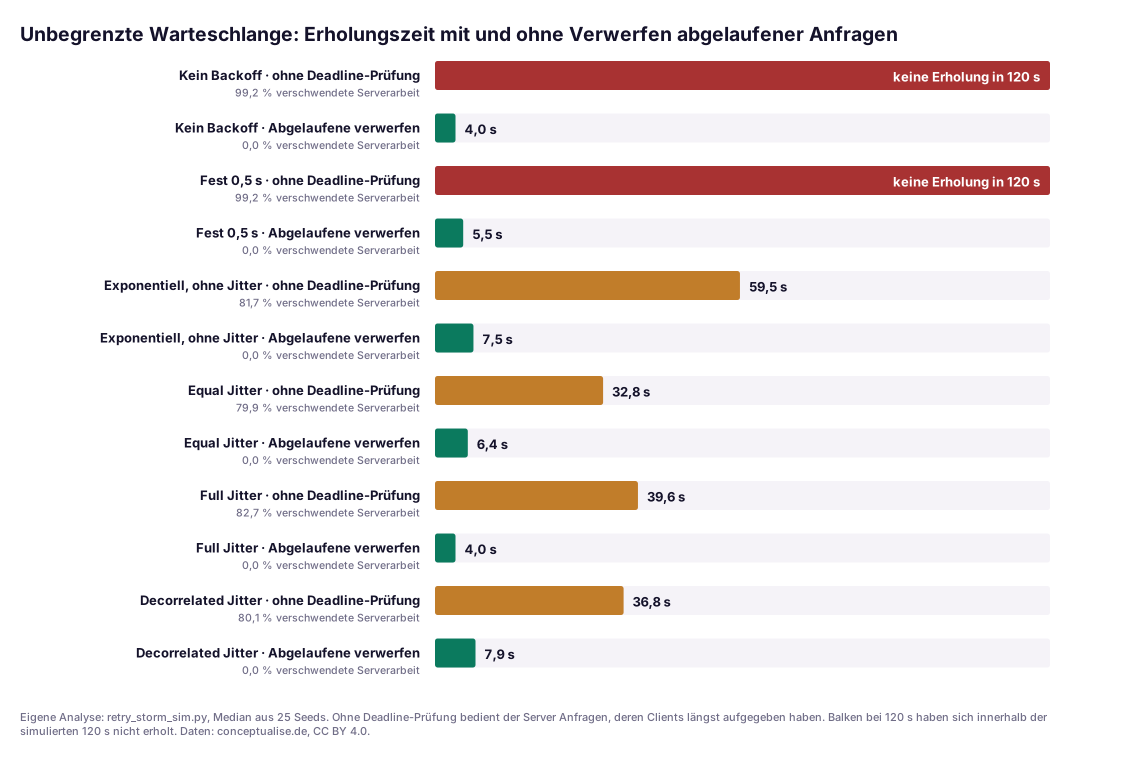
Dieses Diagramm würden wir einem Architekturboard zeigen. Mit unbegrenzter Queue ohne Deadline-Prüfung verbraucht der Server seine Kapazität für Anfragen, deren Clients längst im Timeout sind. Sofortige und feste Retries erholten sich innerhalb von 120 Sekunden gar nicht, 99 Prozent der Serverarbeit waren verschwendet. Das ist ein metastabiler Ausfall im Kleinen: Der Auslöser ist längst vorbei, die Retry-Schleife hält das System unten. Strategien mit exponentiellem Backoff, mit oder ohne Jitter, erholten sich, aber erst nach 33 bis 60 Sekunden und bei rund 80 Prozent verschwendeter Arbeit. Eine einzige Zeile Servercode, die abgelaufene Anfragen beim Entnehmen verwirft, brachte jede Strategie in unter 8 Sekunden zurück. In diesem Modell zählten Deadline Propagation (①) und begrenzte Queues (⑨) mehr als die Wahl des Jitters.
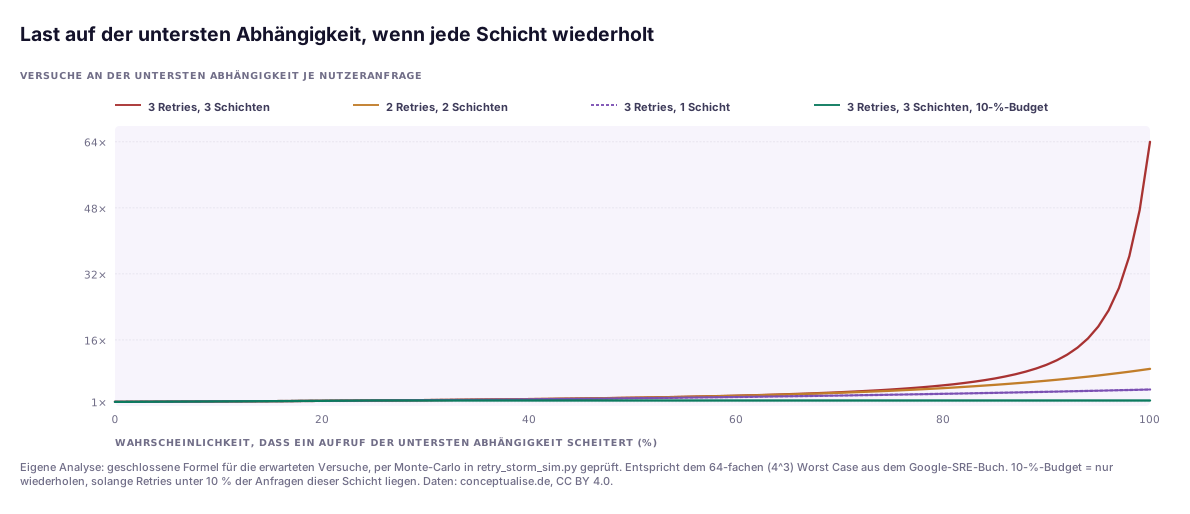
Das letzte Diagramm verallgemeinert das 64-fache Beispiel aus dem SRE-Buch. Mit drei Retries auf jeder von drei Schichten sieht die unterste Abhängigkeit das 2-Fache der Last, wenn die Hälfte ihrer Aufrufe scheitert, etwa das 10-Fache bei 90 Prozent, das 47-Fache bei 99 Prozent und das 64-Fache bei 100 Prozent. Die Kurve ist im gesunden Zustand flach und im Ausfall senkrecht, deshalb übersehen Lasttests sie. Ein Retry-Budget von 10 Prozent je Schicht begrenzt denselben Stack auf das 1,33-Fache.
Grenzen. Das Modell ist bewusst einfach: ein Server, eine Queue, kostenloses Abweisen, kein Hintergrund-Traffic und ein perfekt synchroner Auslöser. Echte Server werden unter Überlast schlechter, unsere Zahlen ohne Backoff sind also optimistisch. Nutzen Sie die Ergebnisse für Richtung und Rangfolge, nicht als Kapazitätswerte, und passen Sie die Parameter in retry_storm_sim.py an Ihr System an.
Aus einem aktuellen Projekt
Ein europäisches Plattformteam wollte wissen, warum ein kurzes, geplantes Datenbank-Failover regelmäßig zu einem Teilausfall wurde, der ein Vielfaches länger dauerte. Am Stack war nichts ungewöhnlich. API-Gateway, Service Mesh, HTTP-Client und ORM wiederholten alle, jeweils für sich vernünftig konfiguriert von einem anderen Team.
Den Aufrufpfad auf eine Seite zu zeichnen, war schon der größte Teil der Diagnose. Vier Retry-Schichten vervielfachten die Last auf dem Datenbank-Proxy genau in dem Moment, in dem das Failover fertig war, und die unbegrenzte Verbindungs-Queue des Proxys sorgte dafür, dass die Datenbank ihre ersten Minuten mit Anfragen verbrachte, die oben längst im Timeout waren. Die Korrekturen waren unspektakulär. Wir entfernten Retries aus Gateway und ORM, behielten eine Retry-Schicht mit Budget im Service Mesh, ergänzten Deadline-Header und eine Prüfung beim Entnehmen in den zwei meistgenutzten Diensten und begrenzten die Proxy-Queue. Das nächste geplante Failover war ein kurzer Aussetzer, kein Vorfall. Am schwierigsten war es, vier Teams darauf zu einigen, welche Schicht für Retries zuständig ist.
Entscheidungstabelle: vom Symptom zum Muster
Das ist der Teil für den Screenshot. Beginnen Sie bei dem Symptom, das Sie tatsächlich sehen.
| Symptom | Erstes Muster | Wo umsetzen | Was messen |
|---|---|---|---|
| Anfragen hängen im Vorfall minutenlang | ① Timeouts und Deadlines | Jeder Client, plus Deadline-Header | Timeouts je Aufruf, p99,9 je Abhängigkeit |
| Kurze Aussetzer werden für Nutzer sichtbar | ② Retries mit Jitter, ⑪ Idempotenzschlüssel | Genau eine Schicht je Aufrufpfad | Retry-Rate, Erfolg nach Retry |
| Last verdreifacht sich im Ausfall, Erholung stockt | ③ Retry-Budget, ⑧ Load Shedding | Client-Bibliotheken, Mesh, Server | Retries / Anfragen, Goodput vs. Durchsatz |
| Eine langsame Abhängigkeit reißt fremde Funktionen mit | ⑤ Bulkhead, ④ Circuit Breaker | Je Abhängigkeit oder Mandant | Pool-Auslastung, Zustandswechsel des Breakers |
| Ein lauter Client verschlechtert alle anderen | ⑦ Rate Limiting | Edge-Gateway | 429 je Client, Top-N-Aufrufer |
| Neustarts kaskadieren unter Last durch die Flotte | ⑥ Health Checks | Readiness vs. Liveness | Neustarts pro Stunde, Probe-Latenz |
| Stoßweise Produzenten überrennen Worker | ⑨ Queue-basierter Lastausgleich | Asynchrone Grenzen | Queue-Alter, verworfene abgelaufene Einträge |
| System bleibt unten, obwohl der Auslöser behoben ist | ⑧ Load Shedding, ① Verwerfen, ③ Budget | Zuerst die Server | Verschwendete Arbeit (abgelaufene Anfragen bedient) |
| Ausfall einer Abhängigkeit leert die ganze Seite | ⑩ Fallback / Degradation | Produkt- und Dienstebene | Fallback-Aktivierungen, Datenalter |
| Doppelte Bestellungen oder Zahlungen nach Retries | ⑪ Idempotenzschlüssel | Schreibende APIs | Wiederholte Schlüssel |
| p99,9 bei Lesezugriffen weit über p50 | ⑫ Hedged Requests | Lesende Clients | Hedge-Rate (≤ ~5 %), Tail-Latenz |
Über der Tabelle stehen zwei Regeln: eine Retry-Schicht je Aufrufpfad und jede Queue hat eine Grenze und eine Deadline-Prüfung.
Governance für europäische Unternehmen
In der EU stehen diese technischen Entscheidungen zunehmend unter regulatorischen Pflichten. Drei Regelwerke greifen hier.
DORA (Verordnung (EU) 2022/2554) gilt seit dem 17. Januar 2025 für Finanzunternehmen und ist am direktesten. Art. 7 verlangt IKT-Systeme, die „mit ausreichenden Kapazitäten ausgestattet“ sind, um Auftragsspitzen bewältigen zu können, und die „technologisch resilient“ sind, um dem Bedarf „unter angespannten Marktbedingungen oder anderen widrigen Umständen“ zu begegnen. Art. 9 Abs. 2 verlangt Werkzeuge, die die Resilienz, Kontinuität und Verfügbarkeit von IKT-Systemen gewährleisten. Art. 11 verlangt Vorkehrungen zur Reaktion und Wiederherstellung, die Vorfälle eindämmen und Schäden begrenzen. Ein Retry-Sturm, der aus einem kurzen Failover einen langen Ausfall macht, ist genau die Lücke, nach der die Aufsicht fragt; dokumentierte Timeouts, Budgets und Load-Shedding-Tests sind guter Nachweis. Unser DORA-Leitfaden für Azure ordnet den Rest ein.
Die Cyberresilienzverordnung (Verordnung (EU) 2024/2847) wendet ihre grundlegenden Anforderungen ab dem 11. Dezember 2027 an. Nach Anhang I Teil I Nummer 2 Buchstabe h müssen Produkte die „Verfügbarkeit wesentlicher und grundlegender Funktionen, auch nach einem Sicherheitsvorfall“ sicherstellen. Nach Buchstabe i müssen sie „die negativen Auswirkungen von den Produkten selbst oder von vernetzten Geräten auf die Verfügbarkeit der von anderen Geräten oder Netzen bereitgestellten Dienste minimieren“. Ein Client-SDK oder eine Geräteflotte, die ohne Backoff oder Budget wiederholt, beeinträchtigt die Verfügbarkeit anderer wie im Lehrbuch. Backoff, Jitter und Budgets gehören deshalb in Ihre Designdokumentation.
NIS2 (Richtlinie (EU) 2022/2555) verlangt in Art. 21 Abs. 2 Buchst. c von wesentlichen und wichtigen Einrichtungen Maßnahmen zur Aufrechterhaltung des Betriebs und zum Krisenmanagement. Die Muster hier sind die technischen Maßnahmen, die solche Pläne glaubwürdig machen.
Ein pragmatischer Einführungspfad
- Woche 1: den Aufrufpfad zeichnen. Listen Sie für Ihre drei wichtigsten User Journeys jede Schicht auf, die Timeouts setzt oder wiederholt: Gateway, Mesh, SDK, HTTP-Client, ORM, Treiber. Die meisten Teams finden drei oder mehr Retry-Schichten.
- Wochen 2–3: Timeouts und eine Retry-Schicht. Timeouts aus dem gemessenen p99,9 ableiten, innere kürzer als äußere. Eine Retry-Schicht je Aufrufpfad, mit Jitter.
- Monat 2: Budgets und Deadlines. Retry-Budget einführen (gRPC-Throttling, Envoy-Retry-Budget oder SDK-Token-Bucket). Deadlines weiterreichen und abgelaufene Arbeit in den meistgenutzten Diensten beim Entnehmen verwerfen. In unserer Simulation war das der größte Hebel.
- Monat 3: abweisen und eindämmen. Priorisiertes Load Shedding vor kritischen Diensten, jede Queue begrenzen, Bulkheads und Breaker um die Abhängigkeiten, die am häufigsten wehtun. Idempotenzschlüssel für jede schreibende API, die Clients wiederholen.
- Quartal 2: beweisen. Führen Sie einen Game Day mit einem synchronen Ausfall durch, etwa dem Neustart einer Abhängigkeit, und messen Sie Goodput, verschwendete Arbeit und Erholungszeit. Bewahren Sie die Ergebnisse als DORA- oder CRA-Nachweis auf. Für lang laufende Workflows ergänzen Sie Durable Execution, damit Retries Prozessneustarts überleben.
Das Fazit
Ausfälle, die Stunden dauern, entstehen selten durch einen größeren Fehler. Sie entstehen durch eine Wiederherstellung, die niemand entworfen hat. Die zwölf Muster sind bekannt und einzeln einfach. Schwierig ist, dass sie zusammenwirken. Ein Retry ohne Budget ist ein Verstärker. Eine Queue ohne Deadline-Prüfung ist ein Ort, an dem Arbeit stirbt. Eine Liveness-Probe, die Abhängigkeiten prüft, ist ein Neustartknopf für die ganze Flotte.
Unsere Haltung ist klar. Wenn Sie in diesem Quartal nur drei Dinge ändern, dann diese: eine Retry-Schicht mit Jitter und Budget, Deadlines, die Server wirklich prüfen, und Load Shedding, das billiger ist als die Arbeit, die es schützt. Breaker, Bulkheads, Fallbacks und Hedging retten kein System, dessen Retries und Queues gegen es arbeiten.
Wenn Sie einen zweiten Blick auf einen kritischen Aufrufpfad möchten: Unser Team für Softwarearchitektur führt genau dieses Review durch. Wir zeichnen den Aufrufpfad, simulieren Ihre Retry-Einstellungen gegen Ihre echte Kapazität und hinterlassen Ihnen die Entscheidungstabelle, ausgefüllt für Ihr System.
FAQ
Welche Resilienzmuster sind für Microservices am wichtigsten?
Beginnen Sie mit Timeouts für jeden Netzwerkaufruf, Retries mit exponentiellem Backoff, Obergrenze und Jitter sowie einem Retry-Budget von etwa 10 Prozent der Anfragen. Diese drei verhindern die meisten selbst verursachten Ausfälle. Danach folgen Circuit Breaker und Bulkheads gegen fehlerhafte Abhängigkeiten, Load Shedding und begrenzte Warteschlangen zum Schutz der Kapazität sowie Idempotenzschlüssel, bevor Sie Schreibzugriffe wiederholen. Fallbacks und Hedging kommen zuletzt.
Warum brauchen Retries Jitter?
Ohne Jitter wiederholen Clients, die gemeinsam gescheitert sind, auch gemeinsam; jede Retry-Welle trifft den Server als eine Spitze. In unserer Simulation scheiterten 2.000 Clients gleichzeitig an einem Server mit kurzer, begrenzter Warteschlange. Exponentielles Backoff ohne Jitter brauchte 52 Sekunden, bis alle bedient waren, weil je Welle nur 250 Anfragen durchkamen. Decorrelated Jitter schaffte es in etwa 6 Sekunden, Full Jitter in etwa 15.
Was ist ein Retry-Budget?
Ein Retry-Budget begrenzt Retries als Anteil am Traffic statt je Anfrage. Das Google-SRE-Buch wiederholt eine Anfrage nur, solange Retries unter 10 Prozent der Anfragen liegen, zusätzlich zu höchstens drei Versuchen je Anfrage. Das Retry-Budget von Envoy steht, sobald aktiviert, standardmäßig bei 20 Prozent der aktiven Anfragen; gRPC drosselt Retries über einen Token Bucket. So vervielfachen Retries die Last im echten Ausfall nicht.
Was ist der Unterschied zwischen Circuit Breaker und Retry?
Ein Retry wiederholt einen fehlgeschlagenen Aufruf in der Hoffnung, dass der Fehler vorübergehend war. Ein Circuit Breaker beobachtet viele Aufrufe und hört ab einer Fehlerschwelle eine Zeit lang auf, die Abhängigkeit aufzurufen; stattdessen scheitert er sofort. Der Retry fängt den kurzen Aussetzer ab, der Breaker den Ausfall, und er hält Retries von einer bereits ausgefallenen Abhängigkeit fern. Im Standard-Handler von .NET liegt der Breaker deshalb innerhalb des Retrys.
Was ist ein metastabiler Ausfall?
Ein metastabiler Ausfall bleibt bestehen, nachdem sein Auslöser verschwunden ist, weil eine Rückkopplung das System überlastet hält. Meist sind es Retries: Anfragen laufen in Timeouts, Clients wiederholen, die Zusatzlast erzeugt weitere Timeouts. Eine OSDI-Studie von 2022 zu 22 öffentlichen Vorfällen aus 11 Organisationen fand die Retry-Policy in mehr als der Hälfte als aufrechterhaltenden Effekt. Der häufigste Ausweg war Load Shedding.
Verlangen EU-Regelwerke Resilienzmuster?
Nicht namentlich, aber im Ergebnis. Art. 7 DORA verlangt IKT-Systeme mit ausreichenden Kapazitäten für Spitzenvolumina, die auch unter angespannten Bedingungen technologisch resilient sind; Art. 11 verlangt Vorkehrungen zur Reaktion und Wiederherstellung. Ab 11. Dezember 2027 verlangt die Cyberresilienzverordnung, dass Produkte die Verfügbarkeit wesentlicher Funktionen sicherstellen und negative Auswirkungen auf die Verfügbarkeit anderer Dienste minimieren. Timeouts, Retry-Budgets und Load Shedding sind der Nachweis.
Quellen
Alle Quellen geprüft am 15. November 2026. Die Simulationsergebnisse sind eigene Analyse und als solche gekennzeichnet; der Code ist mit dem Artikel veröffentlicht.
Tier A: Primärquellen, Standards und Regulierung
- Google Cloud, Service Health, Vorfallbericht vom 12. Juni 2025: https://status.cloud.google.com/incidents/ow5i3PPK96RduMcb1SsW
- AWS, „Summary of the Amazon DynamoDB Service Disruption in the Northern Virginia (US-EAST-1) Region“ (19.–20. Okt. 2025): https://aws.amazon.com/message/101925/
- Verordnung (EU) 2022/2554 (DORA), Art. 7, 9 und 11: https://eur-lex.europa.eu/legal-content/DE/TXT/?uri=CELEX:32022R2554
- Verordnung (EU) 2024/2847 (Cyberresilienzverordnung), Anhang I Teil I: https://eur-lex.europa.eu/legal-content/DE/TXT/?uri=OJ:L_202402847
- Richtlinie (EU) 2022/2555 (NIS2), Art. 21: https://eur-lex.europa.eu/eli/dir/2022/2555/oj/deu
- IETF, draft-ietf-httpapi-idempotency-key-header-08: https://datatracker.ietf.org/doc/draft-ietf-httpapi-idempotency-key-header/
- Kubernetes-Dokumentation, Liveness-, Readiness- und Startup-Probes: https://kubernetes.io/docs/concepts/configuration/liveness-readiness-startup-probes/
- gRPC-Dokumentation, Retry (inkl. Retry Throttling): https://grpc.io/docs/guides/retry/
- gRPC-Dokumentation, Request Hedging: https://grpc.io/docs/guides/request-hedging/
- Envoy API-Referenz, Circuit Breaker und Retry-Budgets: https://www.envoyproxy.io/docs/envoy/latest/api-v3/config/cluster/v3/circuit_breaker.proto
Tier B: Forschung und Fachliteratur
- Google-SRE-Buch, „Handling Overload“: https://sre.google/sre-book/handling-overload/
- Google-SRE-Buch, „Addressing Cascading Failures“: https://sre.google/sre-book/addressing-cascading-failures/
- Huang et al., „Metastable Failures in the Wild“, OSDI 2022: https://www.usenix.org/conference/osdi22/presentation/huang-lexiang
- Bronson, Aghayev, Charapko, Zhu, „Metastable Failures in Distributed Systems“, HotOS 2021: https://sigops.org/s/conferences/hotos/2021/papers/hotos21-s11-bronson.pdf
- Dean und Barroso, „The Tail at Scale“, Communications of the ACM, 2013: https://research.google/pubs/the-tail-at-scale/
- Marc Brooker, „Exponential Backoff and Jitter“, AWS Architecture Blog (2015, aktualisiert 2023): https://aws.amazon.com/blogs/architecture/exponential-backoff-and-jitter/
- Marc Brooker, „Timeouts, retries, and backoff with jitter“, Amazon Builders' Library: https://builder.aws.com/content/3EumjoZascWd1oZiEgL8ORlv3qE/timeouts-retries-and-backoff-with-jitter
- David Yanacek, „Using load shedding to avoid overload“, Amazon Builders' Library: https://builder.aws.com/content/3Eun1EEyX6p2e3VYNyRLSJzLuMV/using-load-shedding-to-avoid-overload
- Martin Fowler, „CircuitBreaker“ (2014): https://martinfowler.com/bliki/CircuitBreaker.html
- CC Conceptualise, Retry-Sturm-Simulation (
retry_storm_sim.py) und Diagrammdaten: https://www.conceptualise.de/blog/resilience-patterns-cheat-sheet/retry_storm_sim.py
Tier C: Herstellerdokumentation, richtungsweisend
- Microsoft Learn, „Build resilient HTTP apps“ (Defaults des Standard-Resilience- und Hedging-Handlers): https://learn.microsoft.com/en-us/dotnet/core/resilience/http-resilience
- Polly-Dokumentation, Resilienzstrategien (Polly 8.9.1, veröffentlicht am 7. Nov. 2026): https://www.pollydocs.org/strategies/
- Resilience4j-Dokumentation (2.4.0; erfordert Java 17): https://resilience4j.readme.io/docs/getting-started
- Netflix Hystrix, README (Wartungsmodus): https://github.com/Netflix/Hystrix
- Azure Architecture Center, Cloud-Entwurfsmuster (Retry, Circuit Breaker, Bulkhead, Queue-Based Load Leveling, Throttling, Health Endpoint Monitoring): https://learn.microsoft.com/de-de/azure/architecture/patterns/
- Stripe API-Referenz, Idempotent Requests: https://docs.stripe.com/api/idempotent_requests
- Anthropic- und OpenAI-Python-SDKs, Retry-Defaults (
_constants.py): https://github.com/anthropics/anthropic-sdk-python und https://github.com/openai/openai-python
Themen