Semantisches Caching für LLMs: Schwellenwerte und Risiken
Wie ein semantischer Cache für LLMs im AI-Gateway funktioniert, was der Ähnlichkeitsschwellenwert kostet und welche Fallstricke wir an 5.000 Paaren maßen.
Die Microsoft-Referenz zur Semantic-Cache-Richtlinie in Azure API Management enthält eine Warnung, die die meisten Teams überlesen. Weil der Cache nach Ähnlichkeit statt nach exaktem Text trifft, kann er sinngemäß Antworten liefern, die für die aktuelle Anfrage „falsch, veraltet oder unsicher“ sind. Ehrlicher lässt sich semantisches Caching kaum beschreiben, und genau hier sollte die Architekturarbeit beginnen.
Semantisches Caching ist auf den richtigen Routen ein echter Kostenhebel und auf den falschen ein Haftungsrisiko. Dieser Beitrag richtet sich an alle, die darüber entscheiden: Plattformverantwortliche, KI-Architekten und CTOs. Wir gehen den Anfragepfad Schritt für Schritt durch und zeigen dann mit einem Experiment, das Sie auf dem Laptop nachrechnen können, was ein Ähnlichkeitsschwellenwert tatsächlich kostet.
TL;DR / Das Wichtigste in Kürze
- Ein semantischer Cache spielt die Antwort eines anderen ab. Er überspringt das Modell, wenn ein neuer Prompt einem gespeicherten nahe genug ist. Das spart Tokens und Latenz und kann mit voller Überzeugung falsch sein.
- Der Schwellenwert ist ein Tauschgeschäft, keine Einstellung. Auf 5.000 gelabelten Fragepaaren bediente ein Kosinus-Schwellenwert von 0,95 nur 28 % der echten Duplikate. Bei 0,85 waren es 80 %, aber 32 % der Antworten gingen an Paare, die als unterschiedliche Fragen gelabelt sind.
- Beinahe-Treffer sind die eigentliche Gefahr. Paare, die eine Entität tauschen oder Rollen umkehren, erreichten 0,95 bis 0,997. „Goldmedaillengewinner“ gegen „Silbermedaillengewinner“ kam auf 0,973.
- Schwellenwerte sind nicht übertragbar. Bei 0,90 bediente ein zweites Embedding-Modell 16 Prozentpunkte weniger Duplikate (41 % statt 57 %), und jedes Produkt misst den Schwellenwert in eigenen Einheiten.
- Erst partitionieren, dann cachen. Schlüssel nach Mandant, Modell und Prompt-Version, Bypass für Agenten und Personendaten, und den Cache als DSGVO-relevanten Datenspeicher betreiben.

Download: Editierbare draw.io-Datei · In diagrams.net öffnen · Diagrammdaten (CSV)
Warum das Thema jetzt zählt
Die Gateways haben aufgeholt. Azure API Management bietet llm-semantic-cache-lookup und llm-semantic-cache-store in allen Tarifen an, für OpenAI Chat Completions und Responses, die Anthropic Messages API (in den v2-Tarifen) und Google Vertex AI. LiteLLM unterstützt Qdrant, Valkey und Redis als semantische Backends, Kong hat ein Plug-in ai-semantic-cache. Semantisches Caching ist damit eine Richtlinie, die man einschaltet. Genau deshalb landet es schnell an der falschen Stelle.
Auch die Studienlage ist besser geworden, und zwar auf beiden Seiten. Die Autoren von MeanCache (IPDPS 2025) berichten, dass wiederholte Anfragen rund 31 % aller Nutzeranfragen ausmachen. Das ist der mögliche Gewinn. Das vCache-Paper (ICLR 2026) zeigt, dass ein statischer Schwellenwert für alle Prompts keine Korrektheitsgarantie bietet. Ein Paper auf der ICML 2026 meldet eine Trefferquote von 86 % für gezielt konstruierte Prompts, die gecachte Antworten kapern. Das ist das Risiko.
Daneben gibt es einen günstigeren, sichereren Hebel. Prompt-Caching der Anbieter verwendet die Verarbeitung eines identischen Prompt-Präfixes wieder. Anthropic berechnet Cache-Lesezugriffe standardmäßig mit dem 0,1-Fachen des Input-Preises (bei einigen neueren Modellen weniger), OpenAI nennt bis zu 95 % Rabatt auf gecachte Input-Tokens. Das Modell schreibt trotzdem eine frische Antwort, Prompt-Caching kann also nicht falsch liegen. Schöpfen Sie es zuerst aus; unser Leitfaden zum Token-Kosten-Engineering zeigt, wie.
Der Anfragepfad, Schritt für Schritt
Die Nummern entsprechen dem Diagramm. Als Beispiel dient Azure API Management; die Logik gilt genauso für LiteLLM, Kong oder Ihren eigenen Code. Zum Gateway selbst lesen Sie unser AI-Gateway-Pattern auf Azure.
① Partitionsschlüssel
Legen Sie vor jeder Ähnlichkeitssuche fest, wer Antworten mit wem teilen darf. In API Management ist das das Element vary-by; Microsoft empfiehlt Nutzer- oder Gruppenkennungen, um den Zugriff über Nutzergrenzen hinweg zu steuern. Wir verwenden Mandant, Modell-Deployment, Version der Prompt-Vorlage und, wo Antworten von Berechtigungen abhängen, die Nutzergruppe. Ein zu grober Schlüssel ist der klassische Fehler: Die Antwort für einen Kunden landet bei einem anderen. Gemeinsame Caches lecken zudem über die Antwortzeit: Ein Paper in IEEE TIFS zeigt, dass Timing-Unterschiede semantischer Caches Prompts anderer Nutzer verraten können.
② Eignungsprüfung
Der Großteil des Verkehrs sollte den Cache nie erreichen. Umgehen Sie ihn bei längeren Dialogen (max-message-count in API Management), bei Tool-Aufrufen und Agentenschleifen, bei Prompts mit personenbezogenen Daten und bei allem, was von Live-Daten wie Preisen oder Status abhängt. Die LiteLLM-Dokumentation ist deutlich: Aufeinanderfolgende Agenten-Turns sind im Embedding zu etwa 0,99 ähnlich, der semantische Cache spielt dann veraltete Antworten ab, und ein höherer Schwellenwert behebt das nicht zuverlässig.
③ Prompt einbetten
Jeder Lookup kostet einen Embedding-Aufruf, ob Treffer oder nicht. Betten Sie nur den Nutzertext ein. In API Management steht ignore-system-messages standardmäßig auf false; Microsoft empfiehlt true, damit ein langer, gemeinsamer System-Prompt den Score nicht dominiert. Nutzen Sie ein Embedding-Modell pro Index und behandeln Sie einen Modellwechsel wie eine Schemaänderung.
④ Vektorsuche und Schwellenwert
Das Gateway nimmt den nächsten gespeicherten Prompt innerhalb der Partition und vergleicht dessen Score mit dem Schwellenwert. Die Einheiten sind eine Falle. score-threshold in API Management reicht von 0 bis 1, niedriger ist strenger; Microsoft schlägt einen Start bei etwa 0,05 vor und warnt, dass Werte über 0,2 zu Fehltreffern führen können. distance_threshold in RedisVL ist eine Kosinus-Distanz von 0 bis 2, ebenfalls niedriger ist strenger. similarity_threshold in LiteLLM ist eine Kosinus-Ähnlichkeit, hier ist höher strenger. Übernehmen Sie nie einen Wert von einem Produkt ins andere.
⑤ Speichern bei Cache-Miss
Bei einem Miss antwortet das Modell, und die Outbound-Richtlinie speichert die Antwort mit einer TTL in Sekunden. API Management cacht standardmäßig nur Antworten mit 200 OK. Speichern Sie nur, was Sie allen in der Partition ausliefern würden: nichts, was eine Inhaltsprüfung nicht bestanden hat, nichts aus dem privaten Kontext eines Nutzers. Ein schlechter Eintrag wird vielfach ausgeliefert. Genau darauf zielt der Key-Collision-Angriff.
⑥ Antworten und messen
Jede Antwort sollte ausweisen, ob sie aus dem Cache kommt und wie nah der Treffer war. Kong setzt X-Cache-Status, LiteLLM x-litellm-semantic-similarity. Protokollieren Sie Score, Partition und Versionen, und geben Sie Nutzern die Möglichkeit, eine falsche Antwort zu melden. Sonst können Sie den Schwellenwert nicht kalibrieren. Unser Leitfaden zu Observability für KI-Agenten beschreibt das Tracing.
⑦ Invalidierung
Ein Cache braucht vier Wege zu vergessen: eine TTL je Route, einen neuen Namespace bei jedem Wechsel von Modell, Prompt-Vorlage oder Sicherheitsrichtlinie, ein gezieltes Löschen bei Änderung der Quelldokumente und ein Löschen einzelner Einträge bei Löschanträgen und gemeldeten Fehlantworten. Die meisten Teams bauen nur den ersten.
Was die Zahlen zeigen
Wir wollten echte Zahlen statt Herstellerangaben. Dazu haben wir den Validierungssplit von GLUE QQP genommen, crowd-gelabelte Fragepaare von Quora, und mit festem Seed 5.000 Paare gezogen, davon 1.859 als Duplikat gelabelt. Für jedes Paar stellten wir eine Frage: Wäre Frage A gecacht und käme Frage B, würde der Cache die Antwort auf A ausliefern? Beide Fragen haben wir mit zwei kleinen offenen Modellen auf der CPU eingebettet und den Kosinus-Schwellenwert von 0,70 bis 0,99 variiert. Skript und Ergebnisse stehen zum Download. Verstehen Sie das als Näherung für einen FAQ-Workload, nicht als Produktionsbenchmark; die QQP-Labels sind verrauscht. Die Fragen sind englisch, für deutsche Prompts müssen Sie mit einem mehrsprachigen Modell eigens messen.
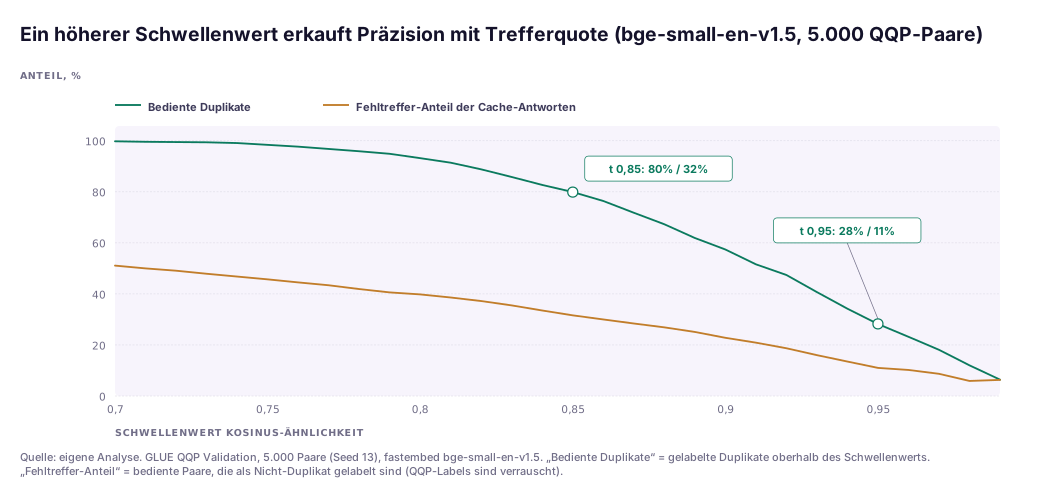
Bei 0,85 bedient der Cache 80 % der echten Duplikate, aber 32 % seiner Antworten gehören zu Paaren, die als unterschiedliche Fragen gelabelt sind. Bei 0,95 sinkt der Fehltreffer-Anteil auf 11 %, dafür werden nur noch 28 % der Duplikate bedient. Auf diesen Daten gibt es keinen Schwellenwert, der den Großteil der Ersparnis mit fast keinen Fehlern verbindet.
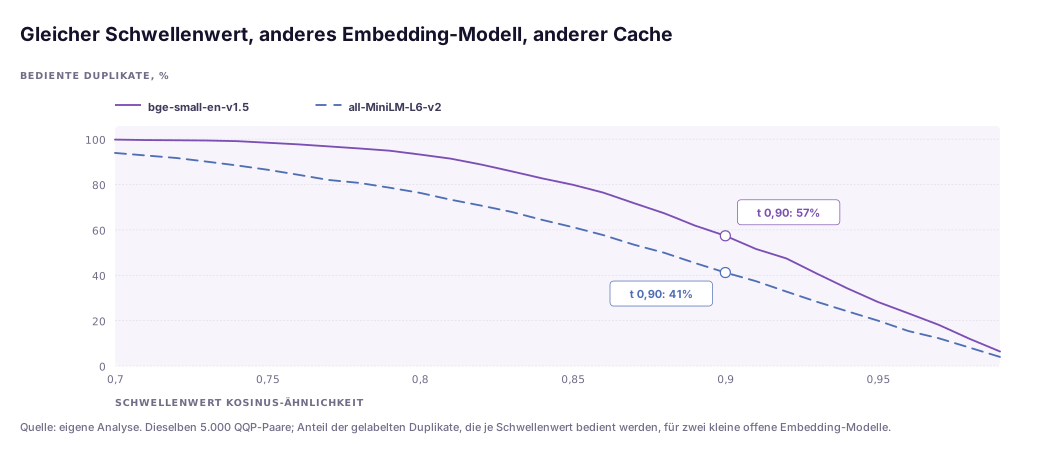
Wechseln Sie das Embedding-Modell, verschiebt sich die Kurve. Bei 0,90 bediente bge-small-en-v1.5 57 % der Duplikate, all-MiniLM-L6-v2 nur 41 %. Ein für das eine Modell kalibrierter Wert ist für das nächste falsch.
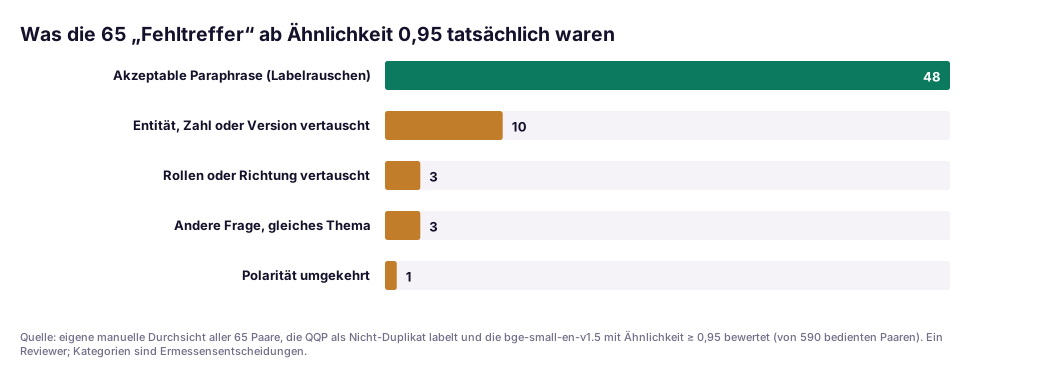
Dann haben wir alle 65 Paare gelesen, die als „kein Duplikat“ gelabelt sind und trotzdem 0,95 oder mehr erreichten, von 590 ausgelieferten. 48 waren akzeptable Umformulierungen mit fragwürdigem Label. 17 waren tatsächlich andere Fragen; rund 3 % der bei 0,95 ausgelieferten Antworten wären für den Fragenden also falsch gewesen. „Extrovertierte unter introvertierten Bedingungen“ gegen die Umkehrung: 0,997. „Rasierschaum als Spülung“ gegen „Spülung als Rasierschaum“: 0,987. „Orange, Kalifornien“ gegen „Orange Cove, Kalifornien“: 0,952. Embeddings erfassen das Thema gut und das eine Wort, das die Antwort ändert, schlecht. Im Unternehmen ist dieses Wort meist ein Produkt, eine Version, ein Betrag oder ein Standort.
Aus einem aktuellen Projekt…
Eine europäische Finanzgruppe bat uns, einen internen Assistenten für Richtlinienfragen zu prüfen. Semantisches Caching war im Gateway aktiv, mit einer einzigen globalen Partition und einem Schwellenwert aus einem Blogbeitrag. Im Test kam auf eine Frage zu den Spesenregeln eines Landes die gecachte Antwort für das Nachbarland zurück. Beide Regelwerke waren echt, beide Antworten klangen plausibel.
Die Lösung war kein raffinierterer Schwellenwert. Wir haben nach Geschäftsbereich und Prompt-Version partitioniert und Land und Produkt in den Schlüssel aufgenommen, wo die Route davon abhing. Prompts mit Personalnummer gingen am Cache vorbei. Den Schwellenwert haben wir aus einigen Hundert gelabelten Prompt-Paaren aus den Pilot-Logs abgeleitet. Die Trefferquote sank, aber jeden verbleibenden Treffer konnte das Team vertreten.
Entscheidungs-Checkliste: Gehört diese Route in den semantischen Cache?
| Frage | Cachen | Nicht cachen |
|---|---|---|
| Gleiche Antwort für alle in der Partition? | Öffentliche FAQ, Dokumentationsfragen | Antworten aus eigenen Daten oder Berechtigungen des Nutzers |
| Wie schnell ändert sich die Wahrheit? | Richtlinien, Produktdoku (TTL Stunden bis Tage) | Preise, Bestand, Status, alles Live |
| Einzelner Prompt? | Eine Frage, eine Antwort | Lange Dialoge, Agentenschleifen, Tool-Aufrufe |
| Kosten einer falschen Antwort? | Gering, Nutzer kann neu fragen | Finanzielle, rechtliche, medizinische, Sicherheits- oder Personalfolgen |
| Zählen Ein-Wort-Unterschiede? | Allgemeine How-to-Fragen | Produktnamen, Versionen, Beträge, Orte, Verneinungen |
| Beobachtbar? | Cache-Status und Score protokolliert, Feedbackweg | Keine Telemetrie pro Antwort |
| Mit eigenen Daten kalibriert? | Schwellenwert aus gelabelten eigenen Prompts | Standard- oder kopierter Wert |
Fällt eine Route bei zwei Zeilen durch, nutzen Sie Exact-Match-Caching oder nur das Prompt-Caching des Anbieters.
Governance für europäische Unternehmen
DSGVO. Der Cache speichert Prompts und Antworten und damit personenbezogene Daten, sobald Nutzer sie eingeben. Der Grundsatz der Speicherbegrenzung (Art. 5 Abs. 1 lit. e) spricht für kurze TTLs. Das Recht auf Löschung (Art. 17) setzt voraus, dass Sie die Einträge einer Person finden, was schwer wird, wenn der Schlüssel sie nicht identifiziert. Art. 32 verlangt ein dem Risiko angemessenes Schutzniveau. Halten Sie den Cache in derselben Region wie das Modell-Deployment und nehmen Sie ihn ins Verzeichnis der Verarbeitungstätigkeiten und ins Löschkonzept auf.
Zugriffskontrolle im Gateway. Microsoft weist darauf hin, dass beim Verweis auf ein Backend über embeddings-backend-id kein verknüpfter Zugriff geprüft wird. Wer Richtlinien bearbeiten darf, kann mit der Managed Identity des Gateways jedes Backend aufrufen. Behandeln Sie das Verfassen von Richtlinien als privilegierte Rolle.
KI-Verordnung. Selten der Treiber. Ist ein Assistent ein Hochrisiko-System nach Anhang III, gelten dessen Pflichten nach der Verordnung (EU) 2026/1744 erst ab dem 2. Dezember 2027; Ihre Protokolle sollten dann zeigen, welche Antworten aus dem Cache kamen. Schritt ⑥ liefert das.
Ein pragmatischer Einführungspfad
- Erst Prompt-Caching ausschöpfen. Stabile Inhalte an den Anfang des Prompts, Anteil gecachter Tokens messen. Weitere Hebel nennt unser Leitfaden zur Azure-OpenAI-Kostenoptimierung.
- Eine Route wählen, Daten labeln. Eine Route mit Einzel-Prompts und geringem Risiko. Einige Hundert echte Prompt-Paare als „soll treffen“ oder „darf nicht treffen“ labeln, bewusst mit Beinahe-Treffern.
- Im Schattenbetrieb laufen lassen. Lookup und Store aktivieren, Score und Kandidatenantwort protokollieren, aber immer die Modellantwort ausliefern. Einige Wochen offline vergleichen.
- Streng live gehen. Schwellenwert aus den gelabelten Daten, Partition nach Mandant, Modell und Prompt-Version, konservative TTLs, Cache-Status im Header.
- Als Datenspeicher betreiben. Bei jedem Embedding-Wechsel neu kalibrieren, bei Quell- und Modelländerungen löschen, Löschanträge anbinden, gemeldete Fehlantworten monatlich prüfen.
Das Fazit
Semantisches Caching lohnt sich auf deutlich weniger Routen, als die Kostenfolie verspricht. Die Schwellenwerte, die am meisten sparen, sind genau die, die Antworten auf Fragen abspielen, die sich in einem entscheidenden Wort unterscheiden. Wir aktivieren es für stabile Routen mit Einzel-Prompts und geringem Risiko, kalibriert auf die eigenen Daten des Kunden und eng partitioniert. Überall sonst liefern Prompt-Caching und gutes Prompt-Design den Großteil der Ersparnis ohne selbstsichere Fehlantworten. Schlägt jemand einen globalen semantischen Cache mit Standard-Schwellenwert vor, lautet die Antwort: nein.
Sie möchten wissen, welche Ihrer LLM-Routen einen semantischen Cache vertragen? Unser KI-Architektur-Team bietet ein kurzes Gateway- und Kosten-Review an, inklusive eines gelabelten Schwellenwert-Tests auf Ihrem eigenen Verkehr.
FAQ
Was ist ein semantischer Cache für LLMs?
Ein semantischer Cache speichert frühere LLM-Antworten zusammen mit einem Embedding des Prompts, der sie erzeugt hat. Ein neuer Prompt wird eingebettet und mit dem Cache verglichen; ist der nächste gespeicherte Prompt ähnlich genug, kommt die gespeicherte Antwort zurück, und das Modell wird gar nicht aufgerufen. Er erkennt auch anders formulierte Prompts. Genau daher kommen Einsparung und Risiko.
Was unterscheidet semantisches Caching vom Prompt-Caching der Anbieter?
Prompt-Caching bei OpenAI oder Anthropic verwendet die Verarbeitung eines identischen Prompt-Präfixes wieder. Das Modell läuft trotzdem und schreibt eine frische Antwort; Sie zahlen nur weniger für wiederholte Input-Tokens. Ein semantischer Cache überspringt das Modell und spielt eine alte Antwort für einen ähnlichen Prompt ab. Prompt-Caching kann keine falsche Antwort liefern, ein semantischer Cache schon.
Welchen Ähnlichkeitsschwellenwert sollten wir verwenden?
Es gibt keinen übertragbaren Wert. Auf 5.000 Quora-Fragepaaren bediente ein Kosinus-Schwellenwert von 0,95 mit bge-small-en-v1.5 nur 28 % der echten Duplikate; bei 0,85 waren es 80 %, aber 32 % der Antworten gingen an Paare, die als unterschiedliche Fragen gelabelt sind. Bei 0,90 bediente ein zweites Modell 16 Prozentpunkte weniger. Leiten Sie den Wert aus gelabelten eigenen Prompts ab.
Wie aktiviere ich semantisches Caching in Azure API Management?
Stellen Sie ein Embedding-Deployment als Backend mit Managed Identity bereit und binden Sie eine Azure-Managed-Redis-Instanz, die mit RediSearch angelegt wurde, als externen Cache an. Dann fügen Sie llm-semantic-cache-lookup (score-threshold, Embedding-Backend, vary-by) im Inbound-Abschnitt und llm-semantic-cache-store (duration in Sekunden) im Outbound-Abschnitt hinzu. Microsoft empfiehlt direkt nach dem Lookup eine Rate-Limit-Richtlinie.
Ist semantisches Caching für Multi-Turn-Chats und KI-Agenten geeignet?
Meist nicht. Die LiteLLM-Dokumentation warnt, dass aufeinanderfolgende Agenten-Turns fast identisch eingebettet werden, der semantische Cache daher veraltete Antworten abspielt und ein höherer Schwellenwert das nicht zuverlässig behebt. In API Management überspringt max-message-count das Caching bei längeren Dialogen. Wir umgehen den semantischen Cache standardmäßig für Agentenschleifen und Tool-Aufrufe.
Was bedeutet die DSGVO für einen LLM-Antwort-Cache?
Geben Nutzer personenbezogene Daten in Prompts ein, speichert der Cache personenbezogene Daten. Speicherbegrenzung (Art. 5 Abs. 1 lit. e DSGVO) spricht für kurze TTLs, Art. 17 verlangt, dass Sie die Einträge einer Person finden und löschen können, und Art. 32 fordert angemessene Sicherheit. Halten Sie Routen mit Personendaten aus dem gemeinsamen Cache heraus und nehmen Sie den Cache in Ihr Löschkonzept auf.
Quellen
Alle Quellen geprüft am 15. November 2026. Die Diagramme beruhen auf eigener Analyse; Methode, Seed und Skript liegen neben der CSV-Datei.
Tier A: Primärdokumentation und Regulierung
- Microsoft Learn, Richtlinienreferenz
llm-semantic-cache-lookup(aktualisiert August 2026): https://learn.microsoft.com/en-us/azure/api-management/llm-semantic-cache-lookup-policy - Microsoft Learn, Richtlinienreferenz
llm-semantic-cache-store: https://learn.microsoft.com/en-us/azure/api-management/llm-semantic-cache-store-policy - Microsoft Learn, Enable semantic caching for LLM APIs in Azure API Management: https://learn.microsoft.com/en-us/azure/api-management/azure-openai-enable-semantic-caching
- Microsoft Learn, Tutorial: Use Azure Managed Redis as a semantic cache: https://learn.microsoft.com/en-us/azure/redis/tutorial-semantic-cache
- LiteLLM-Dokumentation, Semantic Caching im Proxy: https://docs.litellm.ai/docs/proxy/caching_semantic
- Kong, AI Semantic Cache Plug-in: https://developer.konghq.com/plugins/ai-semantic-cache/
- RedisVL, SemanticCache API: https://redis.io/docs/latest/develop/ai/redisvl/0.27.1/api/cache/
- Anthropic, Prompt Caching: https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- OpenAI, Prompt-Caching-Leitfaden: https://developers.openai.com/api/docs/guides/prompt-caching
- Verordnung (EU) 2016/679 (DSGVO), Art. 5, 17 und 32: https://eur-lex.europa.eu/eli/reg/2016/679/oj/deu
Tier B: Forschung und Datensätze
- Schroeder et al., „vCache: Verified Semantic Prompt Caching“, ICLR 2026, arXiv:2502.03771: https://arxiv.org/abs/2502.03771
- Gill et al., „MeanCache: User-Centric Semantic Caching for LLM Web Services“, IPDPS 2025, arXiv:2403.02694: https://arxiv.org/abs/2403.02694
- Zhang et al., „From Similarity to Vulnerability: Key Collision Attack on LLM Semantic Caching“, ICML 2026, arXiv:2601.23088: https://arxiv.org/abs/2601.23088
- Song et al., „The Early Bird Catches the Leak: Unveiling Timing Side Channels in LLM Serving Systems“, IEEE TIFS, arXiv:2409.20002: https://arxiv.org/abs/2409.20002
- Wang et al., GLUE-Benchmark (Aufgabe QQP), arXiv:1804.07461: https://arxiv.org/abs/1804.07461
- GLUE-QQP-Validierungssplit auf Hugging Face: https://huggingface.co/datasets/nyu-mll/glue
- BAAI, bge-small-en-v1.5: https://huggingface.co/BAAI/bge-small-en-v1.5
- sentence-transformers, all-MiniLM-L6-v2: https://huggingface.co/sentence-transformers/all-MiniLM-L6-v2
Tier C: Hersteller, richtungsweisend
- Redis, LangCache-Dokumentation (Public Preview): https://redis.io/docs/latest/develop/ai/langcache
- Qdrant, FastEmbed (Embedding-Laufzeit unseres Experiments): https://github.com/qdrant/fastembed
Themen