KI-Kontextplattformen: die Schicht nach RAG erklärt
Gartner zählt KI-Kontextplattformen zu den Top-Trends 2027. Wir erklären Architekten die Schicht nach RAG: Semantik, Kontextgraph, Richtlinien, Einstieg.
Am 20. Oktober 2026 eröffnete Gartner sein IT Symposium/Xpo in Orlando mit den Top 10 der strategischen Technologietrends für 2027. Auf Platz vier: KI-Kontextplattformen (AI context platforms). Gartner formulierte ungewöhnlich deutlich: Zersplittertes operatives Wissen verursacht Halluzinationen und untragbare Rechenkosten. Gene Alvarez, Distinguished VP Analyst, warnte, ohne eigene Kontextschicht drohten „overprivileged agents", also überprivilegierte Agenten, Compliance-Verstöße, geringes Vertrauen und übermäßiger Token-Verbrauch.
Der erste RAG-Assistent glänzte in der Demo. Der dritte lieferte drei verschiedene Antworten auf „Wie viele aktive Kunden haben wir?". Der Agenten-Pilot blieb im Security-Review hängen, weil niemand sagen konnte, welche Dokumente er im Namen welches Nutzers lesen würde. Das sind Kontextprobleme, keine Modellprobleme, und die Schicht, die sie löst, hat jetzt einen Namen. Dieser Beitrag richtet sich an alle, die entscheiden müssen, ob sie ein Produkt zum Kaufen, ein Muster zum Bauen oder ein Rebranding zum Ignorieren ist: CTOs, CDOs, Architekten und Plattformteams.
TL;DR / Das Wichtigste in Kürze
- Eine Kontextplattform ist eine gesteuerte Schicht, kein größerer Vektorindex. Sie verbindet eine semantische Schicht, einen Kontextgraphen mit Live-Betriebszustand und Herkunft sowie einen Policy Decision Point und liefert das Ergebnis per API oder MCP an Agenten aus.
- RAG verschwindet nicht, es rückt eine Ebene nach unten. Ähnlichkeitssuche wird eine Abrufmethode innerhalb der Plattform. Die Plattform entscheidet, was stimmt, was aktuell ist und was dieser Nutzer und dieser Agent sehen dürfen.
- Gartners Zahlen sind Prognosen, keine Benchmarks. „Bis zu 80 %" mehr Genauigkeit und „bis zu 60 %" weniger Kosten sind Obergrenzen aus einer Prognose vom Mai 2026. Messen Sie Ihre Ausgangslage, bevor Sie eines davon versprechen.
- Richtlinien je Anfrage: der Teil, den die meisten auslassen. Wer Dokumente mit den Rechten eines Dienstkontos indexiert, macht Agenten überprivilegiert. Prüfen Sie Zugriffe bei jedem Aufruf mit Nutzer- und Agentenidentität.
- Beginnen Sie mit der Semantik, die Sie schon haben. BI-Semantikmodelle, Kennzahldefinitionen und Stammdaten-IDs sind der Großteil des ersten Release. Kaufen Sie Auslieferung und Katalogfunktionen; die Definitionen gehören Ihnen.

Download: Editierbare draw.io-Datei · In diagrams.net öffnen · Diagrammdaten (CSV)
Warum das jetzt wichtig ist
Zwischen 2025 und Ende 2026 haben sich drei Dinge verändert.
Erstens: Agenten antworten nicht mehr nur, sie handeln. Ein Chatbot, der „aktiver Kunde" falsch versteht, schreibt einen falschen Satz. Ein Agent, der es falsch versteht, schickt das falsche Verlängerungsangebot an das falsche Segment. Gartner ordnet KI-Kontextplattformen gemeinsam mit KI-Agentenidentität, Agent Coding Harness und autonomer Behebung von Schwachstellen einem Thema zu: der Steuerung der autonomen Agentenplattform. Kontext ist damit eine Kontrolle, nicht nur ein Qualitätshebel.
Zweitens: Die Belege, dass „mehr Kontext" nicht „besserer Kontext" ist, wurden unübersehbar. Im Juli 2025 testete Chroma in seinem Bericht zu „Context Rot" 18 Modelle und stellte fest, dass die Leistung mit wachsender Eingabelänge zunehmend unzuverlässig wurde, selbst bei einfachen Aufgaben. Das bestätigte den älteren „Lost in the Middle"-Befund von Liu und Kollegen. Anthropic zog im September 2025 die Konsequenz: Kontext ist eine endliche Ressource mit einem „attention budget"; gesucht ist die kleinste Menge aussagekräftiger Tokens, die zum Ergebnis führt. Die Top-20-Chunks in den Prompt zu kippen, ist das Gegenteil.
Drittens: Die Auslieferung wurde standardisiert. Das Model Context Protocol, im November 2024 von Anthropic veröffentlicht, ging im Dezember 2025 an die Agentic AI Foundation der Linux Foundation. Die Spezifikation 2026-07-28 machte das Protokoll zustandslos und ergänzte Routing-Header und Cache-Hinweise für Gateways. Wenn jeder Agent eine Kontextquelle gleich aufrufen kann, verschiebt sich der Engpass von „Wie verbinden wir?" zu „Was liefern wir aus, und an wen?".
Gartner hat den Einsatz beziffert. Laut Pressemitteilung vom 11. Mai 2026 werden Organisationen, die Semantik in KI-fähigen Daten priorisieren, bis 2027 die Genauigkeit agentischer KI um bis zu 80 % steigern und die Kosten um bis zu 60 % senken. Rita Sallam, die zitierte Analystin, formulierte es so: Kontext mit semantischer Kohärenz werde „a cost-control and trust strategy, not a nice-to-have".
Was eine KI-Kontextplattform ist und was nicht
Gartner beschreibt KI-Kontextplattformen als Bündelung verstreuten Unternehmenswissens, damit Agenten Eingaben interpretieren, Entscheidungen treffen und im Einklang mit den Geschäftszielen handeln können. Als Kernkomponenten nennt Gartner Semantik, Betriebszustand und Herkunft (Provenance). Ein guter Rahmen, doch Architekten müssen zusätzlich festlegen, wer was sehen darf und wie der Kontext zum Agenten gelangt.
Unsere Arbeitsdefinition, die das Titelbild zeigt:
Eine KI-Kontextplattform ist die gesteuerte Schicht zwischen Unternehmensquellen und KI-Konsumenten. Sie gibt jeder Agentenanfrage eine vereinbarte Bedeutung der Fachbegriffe, den aktuellen Zustand der beteiligten Entitäten, die Herkunft jeder Information und nur das, was anfragender Nutzer und Agent sehen dürfen, zusammengestellt innerhalb eines Token-Budgets und ausgeliefert über eine Standardschnittstelle.
Ebenso hilfreich ist, was sie nicht ist:
- Keine Vektordatenbank. Vektorsuche ist eine Abrufmethode darin, ohne Begriff von Bedeutung, Aktualität oder Rechten.
- Kein Datenkatalog mit Chatbot. Kataloge beschreiben Daten für Menschen. Eine Kontextplattform liefert Fakten zur Laufzeit an Maschinen, unter Richtlinien.
- Kein Agentengedächtnis. Memory ist, was ein Agent über seine eigenen Sitzungen behält. Die Plattform ist gemeinsames, gesteuertes Wissen, das viele Agenten lesen.
- Noch kein einzelnes Produkt. Katalog-Anbieter, Datenplattformen und Hyperscaler vermarkten Teile davon. Atlan gibt an, von Gartner als Beispielanbieter geführt zu werden; Microsofts Fabric-IQ-Ontologie ist in der Preview. Rechnen Sie damit, die Schicht mindestens zwei Jahre lang aus Bausteinen zusammenzusetzen.
Der Unterschied zu RAG im direkten Vergleich:
| Frage | Naives RAG | Kuratiertes RAG | Kontextplattform |
|---|---|---|---|
| Was wird abgerufen? | Top-k ähnliche Chunks | Chunks aus geprüften Sammlungen, neu gerankt | Fakten, Definitionen und Entitäten, plus Chunks, wo Text die richtige Antwort ist |
| Was bedeutet ein Begriff? | Was der Chunk sagt | Was die kuratierten Dokumente sagen | Eine gesteuerte, versionierte Definition |
| Wie aktuell? | So aktuell wie der letzte Re-Index | Re-Index nach Zeitplan | Live-Betriebszustand, wo es zählt |
| Wer darf es sehen? | Indexebene, oft ein Dienstkonto | ACLs je Sammlung | Je Anfrage, Nutzer- und Agentenidentität, Zweck |
| Herkunft belegbar? | Chunk-ID, vielleicht | Link zum Quelldokument | Quelle, Owner, Version und Auslieferungsprotokoll je Fakt |
| Wem gehört es? | Dem App-Team | App-Team plus Content-Owner | Daten- und Fach-Ownern, betrieben als Plattform |
Die meisten Unternehmen, mit denen wir arbeiten, stehen in der mittleren Spalte. Die Frage ist, wo sich der Sprung nach rechts rechnet.
Die Architektur, Schicht für Schicht
Die Nummern entsprechen den Markierungen im Titelbild. Eine typische Anfrage läuft so ab:
① Quellen und Konnektoren
Alles beginnt bei den Systemen, die die Wahrheit halten: führende Systeme wie ERP, CRM und ITSM, Dokumente und Wikis, das Lakehouse mit seinen BI-Modellen, Event-Streams sowie die Arbeitssysteme, in denen Entscheidungen fallen, etwa Tickets und Freigaben.
Die eigentliche Designentscheidung lautet nicht „welche Konnektoren", sondern kopieren oder referenzieren. Klassisches RAG kopiert alles in einen Index. Das passt für Handbücher, die sich selten ändern. Für Auftragsstatus oder offene Störungen ist es falsch, denn die sind im Moment der Kopie veraltet. Eine Kontextplattform liest den Betriebszustand zur Laufzeit über APIs oder Change Data Capture. Anthropic nennt das „just in time"-Kontext.
Das Risiko dieser Schicht sind veraltete oder widersprüchliche Kopien, jede davon ein weiterer Speicher, den Sie absichern und nach DSGVO löschen müssen. Unsere Faustregel: Was sich öfter ändert, als Sie neu indexieren, wird referenziert.
② Die semantische Schicht
Um diese Schicht ging es in Gartners Mitteilung vom Mai 2026: Schema-basierte Datenmodelle allein reichen für agentische KI nicht, weil ihnen die fachliche Bedeutung fehlt. Eine Spalte status mit Werten von 1 bis 7 sagt einem Agenten nichts. „Ein aktiver Kunde hat ein bezahltes Abonnement und einen Login in den letzten 90 Tagen, interne Testmandanten ausgenommen" sagt ihm viel.
Die semantische Schicht liefert der Plattform vier Dinge:
- Ein Glossar und, wo es sich lohnt, eine Ontologie. Was ein Fachbegriff hier bedeutet, mit Synonymen und den Begriffen, die gern verwechselt werden.
- Kennzahlen und Geschäftsregeln als Definition, nicht als Prosa. Umsatz, Churn, Marge und SLA-Verletzung einmal definiert, von BI und Agenten gleich genutzt.
- Entitätsauflösung. Eine Kennung je Kunde, Anlage oder Lieferant über alle Systeme. Ohne sie kann der Kontextgraph in ③ nichts verknüpfen.
- Definitionen als Code. Versioniert, geprüft und testbar, idealerweise in einem offenen Format. Die Initiative Open Semantic Interchange, im September 2025 von Snowflake mit dbt Labs, Salesforce und weiteren Partnern gestartet, veröffentlichte um den Jahreswechsel 2025/26 eine erste YAML-Spezifikation unter Apache-2.0-Lizenz; seit Juli 2026 läuft sie als Apache Ossie im Apache Incubator. Die Formate, die die meisten Unternehmen schon haben, sind der dbt Semantic Layer und Power-BI-Semantikmodelle.
Im letzten Punkt steckt der größte Wert. In Microsoft-Umgebungen enthalten Power-BI-Semantikmodelle bereits den Großteil der Kennzahllogik, die ein Agent braucht. Unser Leitfaden zu Power-BI-Semantikmodellen für Copilot zeigt, wie Sie sie für maschinelle Konsumenten aufräumen. Microsoft geht in dieselbe Richtung: Arun Ulag, Corporate Vice President für Azure Data, beschreibt, wie Power-BI-Semantikmodelle zu einer vollständigen Fabric-IQ-Ontologie ausgebaut werden, und Fabric kann eine Ontologie (noch in der Preview) bereits aus einem bestehenden Semantikmodell erzeugen.
③ Der Kontextgraph
Der Kontextgraph verknüpft aufgelöste Entitäten: Dieser Kunde hat diese Verträge, diese Anlagen, diese offenen Tickets, und diese Richtlinien gelten für ihn. Zwei Dinge machen ihn zu mehr als einem Knowledge Graph.
Betriebszustand. Der Graph weiß, welche Fakten live sind, und holt sie zur Laufzeit. Ein Agent, der nach den offenen Störungen eines Kunden fragt, soll die Antwort des Störungssystems von jetzt bekommen, nicht den Export von letzter Nacht.
Herkunft und Entscheidungsspuren. Jeder Knoten und jede Kante weiß, woher sie stammt, wem sie gehört und welche Version gilt. Im Dezember 2025 argumentierten Jaya Gupta und Ashu Garg von Foundation Capital, Agenten fehle nicht mehr Daten, sondern Entscheidungsspuren (decision traces): welcher Kontext genutzt wurde, welche Richtlinie galt, welche Ausnahme gewährt wurde und wer sie freigab. Mit der Zeit werden diese Spuren zu durchsuchbaren Präzedenzfällen. Wir stimmen zu, mit einer Einschränkung: Die Spuren enthalten personenbezogene Daten und Geschäftsgeheimnisse und gehören deshalb in dieselbe Richtliniengrenze.
Eine Graphdatenbank brauchen Sie für den Start nicht; aufgelöste IDs und eine Beziehungstabelle im Lakehouse genügen. Graph-nativer Abruf lohnt sich, wenn Fragen Quellen übergreifen: „Welche Kunden mit Vertragsverlängerung im ersten Quartal haben mehr als drei offene Störungen hoher Priorität?" Unser kommender Benchmark GraphRAG vs. Vektor-RAG vs. agentischer Abruf untersucht, wann sich diese Komplexität rechnet.
④ Richtliniendurchsetzung
Diese Schicht unterscheidet eine Kontextplattform von einem Suchindex, und auf sie zielt Gartners Warnung vor überprivilegierten Agenten.
Das verbreitete Antimuster: Ein Ingestion-Job läuft unter einem Dienstkonto, liest alles und schreibt einen Index. Die App filtert nach einem Gruppen-Claim, wenn überhaupt. Die effektiven Leserechte des Agenten sind die des Dienstkontos, nicht die des Nutzers, und der Pilot bleibt im Security-Review hängen.
Eine Kontextplattform prüft Richtlinien je Anfrage, mit drei Eingaben:
- Wer fragt. Der menschliche Nutzer, durchgereicht als delegiertes Token, nicht als geteilter Schlüssel.
- Welcher Agent fragt. Eine eigene Workload-Identität je Agent, sodass ein „Rechnungsagent" anders berechtigt sein kann als ein „Vertriebsassistent", der für denselben Nutzer handelt. Unser Beitrag zu Agentenidentität und Token Exchange behandelt die OAuth-Mechanik.
- Zu welchem Zweck. Ein deklarierter Zweck und die Einstufung jeder Information. Hier wird die Zweckbindung der DSGVO von einem Richtliniendokument zu einer technischen Kontrolle.
Der Policy Decision Point liefert Scopes und Filter zurück, nicht nur Ja oder Nein. Die Assemblierung in ⑤ wendet sie an, bevor irgendetwas das Modell erreicht. Kann die Plattform nicht belegen, dass ein Filter angewendet wurde, verlässt die Information sie nicht.
⑤ Kontext-Assemblierung und Auslieferung
Die Assemblierung macht aus Kandidaten-Fakten den Kontext, den ein Agent erhält. Sie filtert nach Richtlinie, rankt nach Relevanz für die Aufgabe, verdichtet lange Dokumente auf die relevanten Passagen, belegt jeden Fakt mit Quelle und Version und hält ein Token-Budget ein. Dieses Budget ist der Hebel gegen den von Gartner beklagten übermäßigen Token-Verbrauch: Nach unserer Erfahrung schlagen einige hundert gut gewählte, belegte Tokens Tausende benachbarter Chunks, auf der Rechnung und, folgt man den Context-Rot-Befunden, auch bei der Qualität.
Die Auslieferung ist inzwischen der einfache Teil: eine API und ein oder mehrere MCP-Server. Drei Eigenschaften der MCP-Spezifikation 2026-07-28 helfen. Durch die Zustandslosigkeit skalieren Server wie jeder HTTP-Dienst. Die Header Mcp-Method und Mcp-Name erlauben einem Gateway Routing und Metering, ohne den Body zu parsen. Und die Hinweise ttlMs und cacheScope bei List- und Read-Antworten lassen Definitionen sicher cachen, während der Live-Zustand ungecacht bleibt. Unser Leitfaden zum MCP-Server-Design im Unternehmen vertieft die Serverseite.
Jede Antwort landet zudem im Audit-Log: was an wen, zu welchem Zweck und unter welcher Richtlinienversion geliefert wurde.
⑥ Die Feedback-Schleife
Diese Markierung macht aus einem Projekt eine Plattform. Korrigierte Antworten, strittige Definitionen, ungenutzte Fakten und revidierte Entscheidungen fließen als Entscheidungsspuren und Evaluierungsfälle zurück. Drei Schleifen zählen am meisten:
- Definitionsstreit geht an einen benannten Owner. Wenn Agent und Finanzanalyst über „aktiver Kunde" uneins sind, ist die Lösung eine geprüfte Änderung der semantischen Schicht, kein Prompt-Tuning.
- Ungenutzter Kontext wird entfernt. Trägt eine Quelle nie zu einer guten Antwort bei, hören Sie auf, für Indexierung und Auslieferung zu zahlen.
- Jeder Vorfall wird zum Regressionstest. Anfrage, gelieferter Kontext und erwartete Antwort kommen in das Evaluierungsset, damit der nächste Modell- oder Definitionswechsel daran geprüft wird.
Was die Zahlen sagen
Noch vergleicht kein unabhängiger Benchmark naives RAG, kuratiertes RAG und eine Kontextplattform auf derselben Unternehmenslast, und Fallstudien der Anbieter messen deren eigene Produkte. Wir bieten deshalb eine datierte Chronik der Kategorie und eine qualitative Bewertung, klar als unsere Analyse gekennzeichnet.
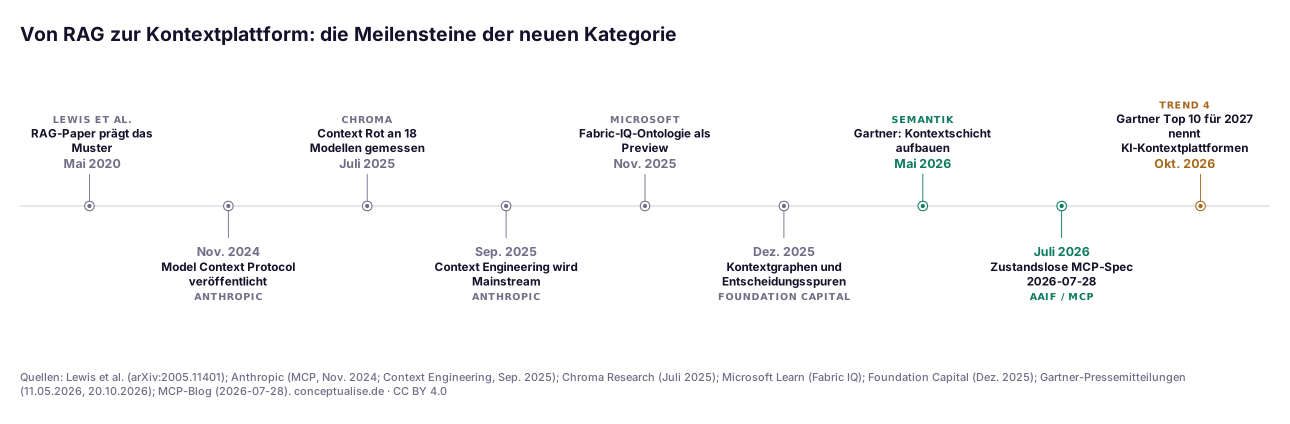
Die Abruftechnik ist sechs Jahre alt. Die Einsicht, dass Kontext Engineering und Governance braucht, verdichtete sich in rund fünfzehn Monaten, von Chromas Bericht im Juli 2025 bis zu Gartners Liste im Oktober 2026, und Standards wie Produkte kamen im selben Zeitfenster. So sieht eine Kategorie aus, die benannt wird, während sie noch entsteht. Deshalb würden wir heute keinen Fünfjahresvertrag für eine „Kontextplattform" unterschreiben.
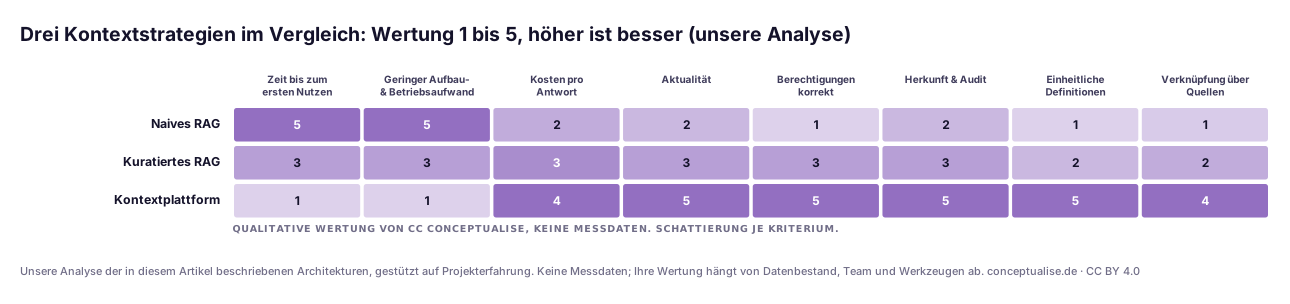
Drei Lesarten der Bewertung:
- Bei Tempo und Aufwand verliert die Kontextplattform, und das mit Absicht. Für die Fragen eines Teams zu einigen hundert stabilen Dokumenten ist kuratiertes RAG die richtige Antwort; eine Plattform wäre Overengineering.
- Sie gewinnt bei den Kriterien, die Produktion blockieren. Berechtigungen, Herkunft und einheitliche Definitionen sind das, wonach Security und Audit fragen, bevor ein Agent handeln darf, und genau dort schneidet naives RAG am schlechtesten ab.
- Die Kosten pro Antwort sinken, aber nicht umsonst. Weniger Tokens pro Antwort bezahlen Sie mit Aufbau und Betrieb; der Break-even hängt vom Volumen ab. Deshalb beginnt der Einführungspfad mit Ihrem volumenstärksten Anwendungsfall.
Gartners „bis zu"-Werte sind eine Obergrenze, kein gemessener Durchschnitt und auf kein Produkt bezogen. Nutzen Sie sie als Begründung, Ihre eigene Ausgangslage zu messen (Genauigkeit auf einem festen Fragenset, Tokens pro Antwort, abgefangene Richtlinienverstöße), nicht als Business Case.
Aus einem aktuellen Projekt
In diesem Jahr haben wir die Agenten-Roadmap einer europäischen Industriegruppe begutachtet. Drei RAG-Assistenten liefen produktiv, ein vierter, ein Agent für das Auftragsmanagement, steckte in der Vorproduktion. Die Assistenten funktionierten; genau das war das Problem. Jedes Team hatte seinen eigenen Index und sein eigenes Verständnis eines „offenen Auftrags". Der Vertrieb zählte Aufträge mit ausstehender Kreditfreigabe mit, der Service nicht. Beide deckten sich mit ihren Quelldokumenten.
Der blockierte Agent sollte Aufträge bearbeiten, nicht beschreiben. Das Security-Review hatte zwei Fragen gestellt, die niemand beantworten konnte: Welche Daten durfte der Agent im Namen einer regionalen Vertriebsleiterin lesen, und wie ließe sich einen Monat später nachvollziehen, warum er einen Liefertermin geändert hatte? Die Ingestion-Jobs aller drei Indizes liefen unter einem Dienstkonto mit weitreichenden Leserechten.
Wir haben keinen Plattformkauf empfohlen, sondern vier Änderungen in dieser Reihenfolge. Das bestehende Semantikmodell des Controllings für Aufträge und Kunden wird als einzige Definition hinter einer API veröffentlicht. Kopierte Auftragsdaten in den Indizes werden für Statusfelder durch Live-Abfragen ersetzt. Jeder Assistent und der Agent erhalten eine eigene Workload-Identität, und das delegierte Token des Nutzers wird vor dem Abruf an eine Richtlinienprüfung durchgereicht. Jeder ausgelieferte Fakt wird mit Quelle und Richtlinienversion protokolliert. Handbücher und Prozessdokumente blieben im kuratierten RAG, weil sie dorthin passen.
Die Technik war der kleinere Teil. Länger dauerte die Frage, wer festlegt, was ein „offener Auftrag" ist. Sobald das Controlling einen Owner benannt hatte, lösten sich die Streitfragen der drei Teams in einem Termin. Das ist der Teil, den niemand demonstriert, und er ist der Großteil der Arbeit.
Entscheidungshilfe: welche Kontextstrategie wofür
Nutzen Sie die Tabelle je Anwendungsfall, nicht je Unternehmen.
| Signal im Anwendungsfall | Naives RAG | Kuratiertes RAG | Kontextplattform |
|---|---|---|---|
| Nur-Lese-Fragen zu stabilen Dokumenten | Nur als Prototyp | Ja | Überdimensioniert |
| Antworten hängen an Kennzahlen oder KPIs | Nein | Riskant | Ja |
| Fakten ändern sich täglich oder öfter | Nein | Riskant | Ja, mit Live-Zustand |
| Agent schreibt, genehmigt oder versendet etwas | Nein | Nein | Ja |
| Gemischte Zielgruppen mit unterschiedlichen Rechten | Nein | Mit ACLs je Sammlung | Ja, Richtlinie je Anfrage |
| Fragen verknüpfen mehrere Systeme | Nein | Funktioniert selten | Ja, über den Graphen |
| Regulierte Entscheidung (Kredit, Personal, Gesundheit) | Nein | Nein | Ja, plus menschliche Aufsicht |
| Ein Team, ein kleiner Bestand | Für einen Piloten okay | Ja | Nein |
Checkliste Bauen oder Kaufen für die Plattform selbst:
- Definitionen selbst besitzen. Glossar, Kennzahlen und Entitäts-IDs liegen in Ihrem Repository, in einem offenen Format, egal welches Tool sie darstellt.
- Konnektoren und Katalogfunktionen kaufen. 40 SaaS-Systeme anzubinden ist kein Differenzierungsmerkmal.
- Richtlinienentscheidungen im eigenen Identity-Stack halten. Der Policy Decision Point muss Ihre Nutzer, Gruppen, Agentenidentitäten und Einstufungen kennen. Das ACL-Modell eines Anbieters allein reicht nicht.
- Auf MCP und schlichten APIs bestehen. Jedes zugekaufte Kontextprodukt sollte über offene Schnittstellen ausliefern, damit Sie es später austauschen können.
- Herkunft je Fakt verlangen. Kann ein Produkt Quelle, Version und Owner jedes gelieferten Fakts nicht nennen, ist es eine Suchmaschine.
- Datenresidenz und Unterauftragsverarbeiter prüfen. Hier entsteht die konzentrierteste Kopie Ihres Geschäftswissens, die es je geben wird.
Governance für europäische Unternehmen
Eine Kontextplattform entscheidet, was Agenten sehen. Das macht sie zum natürlichen Durchsetzungspunkt für drei europäische Regelwerke.
DSGVO. Speichert oder liefert die Plattform personenbezogene Daten, und das wird sie, gilt die Verordnung (EU) 2016/679 unmittelbar. Drei Artikel prägen das Design. Art. 5 Abs. 1 lit. b, die Zweckbindung, ist der Grund, warum die Richtlinienschicht einen deklarierten Zweck als Eingabe verlangt. Art. 5 Abs. 1 lit. c, die Datenminimierung, ist ein rechtliches Argument für Token-Budget und Filterung je Anfrage: nur die Felder, die die Aufgabe braucht, nicht der ganze Datensatz. Art. 25, Datenschutz durch Technikgestaltung und durch datenschutzfreundliche Voreinstellungen, spricht dafür, Richtlinien in die Plattform zu bauen, statt sie jedem Agententeam zu überlassen. Ein Nebeneffekt: Bei einem Auskunftsersuchen nach Art. 15 zeigt das Audit-Log, welche Agenten wann Daten der betroffenen Person erhalten haben.
KI-Verordnung. Die KI-Verordnung (Verordnung (EU) 2024/1689) reguliert KI-Systeme nach Risiko, nicht Kontextplattformen als solche. Die Hochrisiko-Pflichten für Anhang-III-Anwendungen, einschließlich der Aufzeichnungspflichten nach Art. 12, wurden durch die Verordnung (EU) 2026/1744, in Kraft seit dem 27. Juli 2026, auf den 2. Dezember 2027 verschoben. Das ist kein Grund zu warten. Unterstützt ein Agent eine Hochrisiko-Entscheidung, etwa bei Kreditvergabe oder Personalauswahl, sind Herkunftsangaben und Auslieferungsprotokolle der Plattform genau die Nachweise, die Sie brauchen werden, und jetzt deutlich günstiger aufzubauen als Ende 2027 zu rekonstruieren. Die Daten-Governance-Pflichten nach Art. 10 zielen auf Trainings-, Validierungs- und Testdaten; rechnen Sie trotzdem damit, dass Prüfer dieselben Fragen an den Abrufkontext stellen.
DORA. Für Finanzunternehmen gilt die Verordnung (EU) 2022/2554 seit dem 17. Januar 2025. Eine Kontextplattform eines Drittanbieters ist eine Vereinbarung über IKT-Dienstleistungen: Sie gehört ins Informationsregister, braucht eine Exit-Strategie und kann kritische oder wichtige Funktionen unterstützen.
Ein pragmatischer Einführungspfad
- Woche 1–2: einen volumenstarken Anwendungsfall wählen und die Ausgangslage messen. Idealerweise einen, der bereits als RAG-Assistent existiert. Bauen Sie ein festes Fragenset mit erwarteten Antworten; erfassen Sie Genauigkeit, Tokens pro Antwort und jede Berechtigungsfrage, die Security gestellt hat.
- Woche 3–6: den semantischen Kern veröffentlichen. Nehmen Sie die 20 bis 50 Begriffe und Kennzahlen, von denen der Anwendungsfall abhängt. Vereinbaren Sie je eine Definition mit einem benannten Owner, ausgehend von bestehenden BI-Modellen und Stammdaten. Als Code ablegen, per API und MCP bereitstellen. Der beste Ertrag pro Arbeitstag.
- Woche 6–10: volatile Fakten auf Live-Abfragen umstellen. Ersetzen Sie kopierte operative Felder in den Indizes durch Abfragen zur Laufzeit beim führenden System, hinter derselben API. Stabile Dokumente bleiben im kuratierten RAG; dafür gilt unser Leitfaden zur RAG-Pipeline im Unternehmen weiterhin.
- Woche 8–12: Richtlinien in den Pfad bringen. Jeder Agent bekommt eine eigene Workload-Identität, das delegierte Token des Nutzers wird durchgereicht, und Zugriffe werden je Anfrage vor dem Abruf geprüft. Jeder gelieferte Fakt wird mit Quelle, Version und Richtlinienversion protokolliert. Meist ist es dieser Schritt, der das Security-Review freigibt.
- Quartal 2: die Schleife schließen und einen zweiten Anwendungsfall aufnehmen. Streitfälle an Owner leiten, Vorfälle ins Evaluierungsset übernehmen, neu messen. Dann einen andersartigen Anwendungsfall anbinden. Nutzt er den semantischen Kern weitgehend mit, haben Sie eine Plattform. Wenn nicht, haben Sie zwei Projekte, und das sollten Sie früh wissen.
Das Fazit
KI-Kontextplattformen sind weder ein Rebranding von RAG noch ein Produkt, das Sie 2026 komplett kaufen können. Sie sind die Erkenntnis, dass, sobald Agenten handeln, nicht mehr zählt, ob ein passender Absatz gefunden wird. Es zählt, was ein Begriff hier bedeutet, ob ein Fakt aktuell ist, woher er stammt und ob dieser Agent ihn im Namen dieser Person sehen darf. Gartner hat die Schicht im Oktober 2026 benannt; die technischen Belege wiesen schon über ein Jahr in diese Richtung.
Unsere Sicht ist pragmatisch. Behalten Sie kuratiertes RAG überall dort, wo es um Fragen zu stabilen Dokumenten geht. Bauen Sie eine Kontextplattform dort, wo Agenten handeln, wo Antworten an Kennzahlen hängen oder wo mehrere Zielgruppen einen Bestand teilen. Und bauen Sie in der Reihenfolge, die sich auszahlt: zuerst Semantik, dann Live-Zustand, dann Richtlinien, den Graphen, sobald quellenübergreifende Fragen es verlangen. Der Anbietermarkt wird sich konsolidieren. Ihre Definitionen, Identitäten und Ihr Audit-Trail sollten jeden Anbieter überdauern, den Sie wählen.
Wenn Sie klären möchten, wo sich eine Kontextplattform in Ihrer Landschaft rechnet, führt unser Team für KI-Architektur ein kurzes Assessment mit festem Umfang durch. Es misst einen Agenten-Anwendungsfall, erfasst Ihre vorhandenen semantischen Bausteine und liefert einen Plan, was Sie für die Schicht bauen und was Sie kaufen.
FAQ
Was ist eine KI-Kontextplattform?
Eine KI-Kontextplattform ist die gesteuerte Schicht, die KI-Agenten das Geschäftswissen liefert, das sie zum richtigen Handeln brauchen: was Begriffe bedeuten, den aktuellen Zustand der Objekte, auf die sie zugreifen, die Herkunft jeder Information und was der anfragende Nutzer und Agent sehen dürfen. Gartner führt KI-Kontextplattformen unter den Top 10 der strategischen Technologietrends für 2027. Sie liegt zwischen Ihren Quellen und Ihren Agenten und liefert Kontext über eine API oder einen MCP-Server.
Worin unterscheidet sich eine KI-Kontextplattform von RAG?
RAG ist eine Abruftechnik: ähnliche Textabschnitte finden und in den Prompt kopieren. Eine Kontextplattform ist eine gesteuerte Schicht, in der RAG weiterläuft. Sie ergänzt eine semantische Schicht mit einer Bedeutung pro Begriff, einen Kontextgraphen mit Live-Betriebszustand, eine Richtlinienprüfung je Anfrage auf Basis von Nutzer- und Agentenidentität sowie Herkunftsangaben zu jeder Information. Vektorsuche wird eine Abrufmethode unter mehreren, nicht mehr die Architektur.
Brauchen wir für eine Kontextplattform einen Knowledge Graph?
Nicht am ersten Tag. Ein Kontextgraph kann mit aufgelösten Entitäts-IDs und einer Beziehungstabelle beginnen, die Sie bereits haben. Von Anfang an brauchen Sie eine vereinbarte Bedeutung je Fachbegriff und Kennzahl sowie stabile Kennungen für die Entitäten, auf die Agenten zugreifen. Bestehende BI-Semantikmodelle zu veröffentlichen bringt meist mehr als ein Graphdatenbank-Projekt.
Was hat Gartner zu Semantik und KI-Agenten prognostiziert?
Am 11. Mai 2026 prognostizierte Gartner, dass Organisationen, die Semantik in KI-fähigen Daten priorisieren, bis 2027 die Genauigkeit agentischer KI um bis zu 80 % steigern und die Kosten um bis zu 60 % senken, und empfahl den Aufbau einer Kontextschicht. Das sind Prognosen mit Obergrenze, keine gemessenen Durchschnittswerte. Nutzen Sie sie als Anlass, Ihre eigene Ausgangslage zu messen.
Ist MCP eine KI-Kontextplattform?
Nein. Das Model Context Protocol ist die Auslieferungsschnittstelle, über die Agenten Tools aufrufen und Ressourcen lesen. Eine Kontextplattform entscheidet, was diese zurückgeben, an wen und mit welcher Herkunft, und stellt dafür meist einen oder mehrere MCP-Server bereit. MCP ohne gesteuerte Schicht dahinter verschafft Agenten nur schnelleren Zugriff auf widersprüchliche Daten.
Welche EU-Vorschriften gelten für eine KI-Kontextplattform?
Die DSGVO gilt für alle personenbezogenen Daten, die die Plattform speichert oder ausliefert; Zweckbindung, Datenminimierung und Datenschutz durch Technikgestaltung prägen die Richtlinienschicht. Die Hochrisiko-Pflichten der KI-Verordnung für Anhang-III-Anwendungen wurden durch die Verordnung (EU) 2026/1744 auf den 2. Dezember 2027 verschoben, doch Herkunftsangaben und Protokolle der Plattform sind genau die Nachweise, die sie verlangen werden. Unter DORA ist eine externe Kontextplattform ein IKT-Drittdienst.
Quellen
Alle Quellen geprüft am 15. November 2026. Gartners eigene Seiten blockieren automatisierte Abrufe; für Gartner-Zitate nennen wir daher zusätzlich syndizierte Fassungen der Pressemitteilungen, Zitate wurden über mindestens zwei davon abgeglichen.
Tier A: Primärquellen, Standards und Regulierung
- Gartner, „Gartner Identifies the Top Strategic Technology Trends for 2027" (Pressemitteilung, 20.10.2026): https://www.gartner.com/en/newsroom/press-releases/2026-10-20-gartner-identifies-the-top-strategic-technology-trends-for-2027
- Gartner, „Gartner Says Lack of Semantics Causes Inaccurate AI Agents and Wasted Spending" (Pressemitteilung, 11.05.2026): https://www.gartner.com/en/newsroom/press-releases/2026-05-11-gartner-says-lack-of-semantics-causes-inaccurate-artificial-intelligence-agents-and-wasted-spending
- Model Context Protocol, „The 2026-07-28 Specification": https://blog.modelcontextprotocol.io/posts/2026-07-28/
- Linux Foundation, Gründung der Agentic AI Foundation (09.12.2025): https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation
- Anthropic, „Introducing the Model Context Protocol" (25.11.2024): https://www.anthropic.com/news/model-context-protocol
- Microsoft Learn, „What is Fabric IQ?": https://learn.microsoft.com/en-us/fabric/iq/overview
- Verordnung (EU) 2016/679 (DSGVO), Art. 5, 15 und 25: https://eur-lex.europa.eu/eli/reg/2016/679/oj/deu
- Verordnung (EU) 2024/1689 (KI-Verordnung), Art. 10 und 12: https://eur-lex.europa.eu/eli/reg/2024/1689/oj/deu
- Verordnung (EU) 2022/2554 (DORA): https://eur-lex.europa.eu/eli/reg/2022/2554/oj/deu
Tier B: Forschung und Analyse
- Lewis et al., „Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks" (arXiv:2005.11401, 2020): https://arxiv.org/abs/2005.11401
- Liu et al., „Lost in the Middle: How Language Models Use Long Contexts" (arXiv:2307.03172; TACL 2024): https://arxiv.org/abs/2307.03172
- Chroma Research, „Context Rot: How Increasing Input Tokens Impacts LLM Performance" (14.07.2025): https://www.trychroma.com/research/context-rot
- Anthropic Engineering, „Effective context engineering for AI agents" (29.09.2025): https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Network World, Zusammenfassung der Gartner-Trends 2027 mit den Alvarez-Zitaten: https://www.networkworld.com/article/4238030/gartners-top-tech-trends-for-2027-expand-and-accelerate.html
- IT-Online, syndizierte Gartner-Mitteilung zur Semantik mit den Sallam-Zitaten (12.05.2026): https://it-online.co.za/2026/05/12/lack-of-semantics-causes-inaccurate-ai-agents-wasted-spending/
- TechEdgeAI, syndizierte Gartner-Mitteilung zu den Trends 2027 (alle zehn Trends): https://techedgeai.com/gartner-identifies-the-top-strategic-technology-trends-for-2027/
Tier C: Anbieter und Meinung, richtungsweisend
- Jaya Gupta und Ashu Garg (Foundation Capital), „AI's trillion-dollar opportunity: Context graphs" (Dez. 2025): https://ashugarg.substack.com/p/ais-trillion-dollar-opportunity-context
- dbt Labs, „The OSI spec updates": https://www.getdbt.com/blog/the-osi-spec-updates
- Snowflake, „Open Semantic Interchange specs finalized": https://www.snowflake.com/en/blog/open-semantic-interchanges-specs-finalized/
- Apache Ossie, „Apache Ossie (Incubating): The New Name for Open Semantic Interchange" (10.07.2026): https://ossie.apache.org/updates/ossie-enters-apache-incubator/
- Be Informed, zu Gartners Kontextkomponenten (Semantik, Betriebszustand, Herkunft): https://www.beinformed.com/gartners-top-10-technology-trends-for-2027-why-context-matters-for-trusted-ai/
- Atlan, Erklärseite „AI context platform" (Anbieter; nennt Gartner-Listung als Beispielanbieter): https://atlan.com/know/ai-agent/context-layer/ai-context-platform/
- VentureBeat, Interview zur Fabric-IQ-Ontologie von Microsoft: https://venturebeat.com/data/microsofts-fabric-iq-teaches-ai-agents-to-understand-business-operations-not
Themen