Voice-AI-Agenten: Architektur, Latenz und Compliance
So bauen Sie Voice-AI-Agenten fürs Unternehmen: Echtzeit-Schleife, Latenzbudget je Hop, Barge-in, Speech-to-Speech im Vergleich und EU-Compliance.
Im Mai 2026 brachte OpenAI gpt-realtime-2 heraus, laut eigener Aussage mit „GPT-5-class reasoning" für Voice-Agenten. Im September folgte Google mit Gemini 3.8 Live. Auch das Geld bewegt sich: CRM Magazine berichtete über eine Gartner-Umfrage, nach der die KI-Ausgaben im Kundenservice um 38 Prozent stiegen, die Servicebudgets insgesamt aber nur um 2 Prozent.
Jedes Voice-Pilotprojekt, das wir gesehen haben, stößt zuerst an dieselbe Wand. Nicht Genauigkeit, nicht Kosten, sondern die Stille, nachdem der Anrufer aufgehört hat zu sprechen. Ein Chatbot, der in zwei Sekunden antwortet, wirkt schnell. Ein Telefonagent, der zwei Sekunden braucht, wirkt kaputt. Dieser Beitrag richtet sich an alle, die die Architektur verantworten: CTOs, Contact-Center-Verantwortliche, Architektinnen und CISOs. Wir zerlegen die Echtzeit-Schleife, geben jedem Hop ein Millisekundenbudget und zeigen, welche europäischen Regeln tatsächlich greifen.
TL;DR / Das Wichtigste in Kürze
- Latenz ist ein Budget, kein Feature. Die kaskadierte Referenz-Pipeline aus dem Pipecat-Primer braucht 1.293 ms Voice-to-Voice, die Hälfte davon wartet sie auf das erste LLM-Token. Planen Sie je Hop und zielen Sie auf einen Median um 800 ms vor der Telefonnetz-Laufzeit.
- Die Turn-Erkennung entscheidet über das Gefühl. Feste Stille-Timeouts schneiden Anrufern das Wort ab oder lassen sie warten. Semantische Turn-Ende-Modelle sind heute Standard.
- Barge-in trennt Demo und Produktion. Wiedergabe stoppen, laufende Arbeit abbrechen und den Kontext auf das tatsächlich Gehörte kürzen.
- Speech-to-Speech ist ein Tauschgeschäft. Weniger Hops und natürlichere Prosodie gegen Transkripttreue, freie Stimmwahl und ein Stück Verlässlichkeit beim Tool-Calling. Entscheiden Sie je Gesprächsfluss.
- EU-Compliance gilt bereits. Die Transparenzpflicht nach Art. 50 KI-Verordnung gilt seit 2. August 2026; Aufzeichnungen bringen DSGVO, § 201 StGB und PCI DSS ins Spiel.

Download: Editierbare draw.io-Datei · In diagrams.net öffnen · Diagrammdaten (CSV)
Warum das jetzt zählt
Die Ausgabenschere bei Gartner heißt: KI-Projekte im Service müssen ihren Wert belegen, sonst werden sie gestrichen. In einer Kundenumfrage, die Gartner im August 2026 veröffentlichte, sagten zudem 87 Prozent der Befragten, dass Unternehmen mit generativer KI im Service einen Weg zu einem Menschen anbieten müssen. Ein Voice-Agent, der Anrufer festhält, scheitert an beidem.
Die Bausteine sind reif. OpenAIs Realtime API nimmt SIP-Anrufe direkt an, mit eigenem EU-Endpunkt (sip-eu.api.openai.com). Azures Voice Live API, seit Ende September 2025 allgemein verfügbar, führt inzwischen gpt-realtime-2.1 mit globaler, Data-Zone- und regionaler Verarbeitung, daneben kaskadierte Varianten mit Azure Speech. Amazon Nova 2 Sonic ist seit Dezember 2025 allgemein verfügbar; laut AWS-Release-Notes auch in der Region Europe (Stockholm).
Die Physik bleibt dieselbe. ITU-T G.114 hält fest, dass unter 150 ms Mund-zu-Ohr die meisten Anwendungen „essentially transparent interactivity" erleben, und setzt 400 ms Einwegverzögerung als Obergrenze für die Netzplanung. Danach muss ein Voice-Agent zuhören, denken und sprechen, und zwar in der Pause, die ein Mensch lassen würde. Der Pipecat-Primer beziffert sie auf etwa 500 ms. Eine PNAS-Studie über zehn Sprachen fand 2009: Menschen minimieren überall die Stille zwischen Redebeiträgen.
Die Echtzeit-Schleife, Hop für Hop
Die Nummern entsprechen den Markierungen im Diagramm. Jeder Hop trägt unser Planungsziel, kein Herstellerversprechen.
① Telefonie und Media-Schicht
Anrufe kommen über das Telefon- oder Mobilfunknetz, meist als 8-kHz-Schmalbandaudio, laufen über SIP-Trunk und Session Border Controller und landen im Media-Gateway. In der Referenz-Pipeline des Primers kostet diese Transportschicht 203 ms über beide Richtungen; ein Telefonieanbieter fügt laut Primer „a few hundred milliseconds" hinzu. Der einzige Hebel ist die Platzierung: Media-Gateway, Sprachdienste und Modell-Endpunkt in einer Region. Ziel: 200 ms.
② Streaming-STT und Turn-Erkennung
Transkription ist schnell. Langsam ist die Entscheidung, dass der Anrufer fertig ist. Ein kurzer Stille-Timeout unterbricht Menschen, die ihre IBAN vorlesen; ein langer bremst jede Antwort. Semantische Turn-Ende-Modelle hören, wie jemand spricht, nicht nur, ob er schweigt. Der Primer nennt rund 250 ms für Pipecats quelloffenes Smart Turn. Deepgram veröffentlicht für die Turn-Ende-Erkennung von Flux ein p90 von etwa einer Sekunde (p95: 1,5 Sekunden): Achten Sie also auf den Tail, nicht nur auf den Median. OpenAIs Realtime API bietet semantic_vad mit einer eagerness-Einstellung. Ziel: 250 ms, getestet mit Ihren Anrufern, Ihren Sprachen und 8-kHz-Audio.
③ Das LLM und seine Tools
Der größte Hop: 650 von 1.293 ms in der Referenz. Entscheidend ist die Zeit bis zum ersten Token, also: schnelles Modell, kurzer cachebarer Prompt, regionaler Endpunkt, durchgängiges Streaming. Der stille Killer ist ein Tool-Call vor dem ersten Wort. Lassen Sie den Agenten „Ich schaue kurz nach Ihrer Bestellung" sagen, während die CRM-Abfrage parallel läuft. Zur Kostenseite dieser Modellwahl siehe unseren Vergleich Small Language Models vs. API-Modelle. Ziel: 250 ms, damit bleiben große Reasoning-Modelle aus dem kritischen Pfad.
④ Streaming-TTS und Wiedergabe
Der Orchestrator streamt den ersten sprechbaren Satzteil an die TTS (20 ms Chunking im Primer). ElevenLabs nennt für Flash v2.5 etwa 100 ms im Median, ohne Netz- und Anwendungslatenz; die Tabelle des Primers zeigt 120 ms bis zum ersten Audio. Ziel: 100 ms. Testen Sie, ob die Stimme Produktnamen, Zahlen und Adressen über eine Schmalbandleitung korrekt ausspricht.
⑤ Barge-in: der Pfad, den keine Demo zeigt
Spricht der Anrufer in die Ansage hinein, muss die Barge-in-Steuerung den Wiedergabepuffer leeren, LLM-Generierung und TTS-Synthese abbrechen und den Verlauf auf die tatsächlich abgespielten Wörter kürzen. Den dritten Schritt vergessen die meisten Teams. OpenAIs Realtime API hat dafür das Event conversation.item.truncate; in der Kaskade bauen Sie es aus den Wort-Zeitstempeln der TTS. Der Primer warnt auch vor dem Gegenfehler: Husten, Tastaturklicks, Hintergrundstimmen und Echo lösen falsche Unterbrechungen aus. Optimieren Sie beide Fehlerraten gemeinsam.
⑥ Übergabe, Aufzeichnungen und Kontrollzone
Geben Sie dem Agenten eng begrenzte, zunächst nur lesende Tools und behandeln Sie jede gesprochene Eingabe als nicht vertrauenswürdig; Sprache ist nur ein weiterer Kanal für indirekte Prompt Injection. Machen Sie die Übergabe an Menschen zum regulären Pfad: Warm Transfer (etwa per SIP REFER) mit Zusammenfassung. Wann ein Agent übergeben sollte, beschreibt unser Beitrag zu Human-in-the-Loop-Freigaben. Speichern Sie Aufzeichnungen und Transkripte mit Einwilligung, Schwärzung und durchgesetzten Löschfristen, und tracen Sie jeden Turn mit Zeiten je Hop wie in unserem Leitfaden zur Agent-Observability. Ohne Zeiten je Hop gibt es kein Budget, das sich steuern ließe.
⑦ Die Speech-to-Speech-Alternative
Ein Echtzeitmodell nimmt Audio entgegen und gibt Audio aus: OpenAIs gpt-realtime-Familie, Gemini Live, Amazon Nova Sonic oder die Echtzeitmodelle in Azure Voice Live. Die Hops ② bis ④ verschwinden als eigene Dienste, und der Tonfall, den ein Transkript verliert, bleibt erhalten. Der Pipecat-Primer nennt die Kosten: Diese Modelle „do not follow instructions or call tools as reliably as text-mode LLMs", ihre Transkripte reichen für Compliance und Evals womöglich nicht, und das Kontextmanagement ist weniger flexibel. Bei gemischtsprachigen Gesprächen schneiden sie laut Primer besser ab.
Was die Zahlen sagen
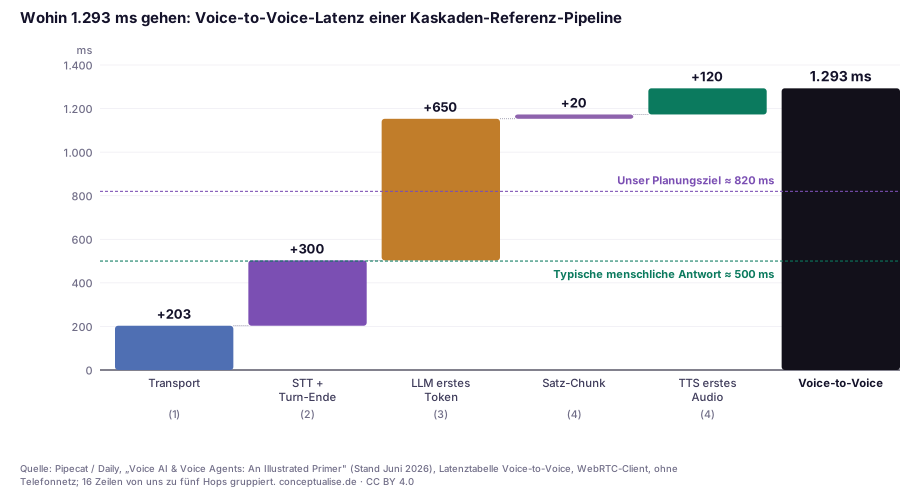
Der Wasserfall nutzt die veröffentlichte Latenztabelle des Pipecat-Primers: 16 Zeilen für einen WebRTC-Client ohne Telefonnetz, von uns zu den fünf Hops des Diagramms gruppiert. Am Ende der Transkription sind die 500 ms eines Menschen bereits verbraucht, und das erste LLM-Token macht die Hälfte der Gesamtzeit aus.
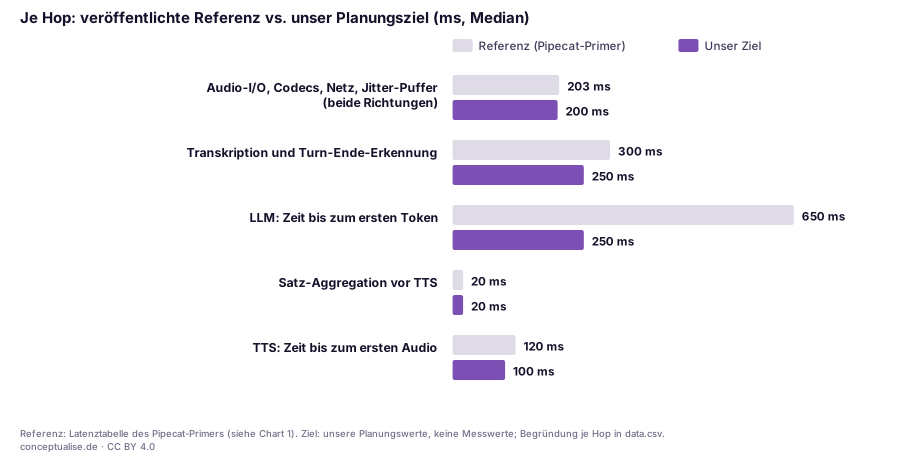
Unsere Ziele sind Planungswerte, keine Messungen; die CSV nennt die Begründung je Hop. Der Transport bewegt sich kaum, die Turn-Erkennung gewinnt etwas. Von den 473 ms, die wir einsparen müssen, kommen 400 aus dem LLM. Die Modellwahl für Voice ist damit zuerst eine Latenz- und erst dann eine Qualitätsentscheidung.
Aus einem aktuellen Projekt
Kürzlich haben wir das Voice-Pilotprojekt eines europäischen Dienstleisters begutachtet. Die Demo hatte den Vorstand beeindruckt; am Telefon legten die Anrufer auf. Die Traces zeigten, warum: Media-Gateway und Modell-Endpunkt lagen in verschiedenen Regionen, der Prompt schleppte bei jedem Turn ein langes Richtliniendokument mit, und vor dem ersten Wort lief eine blockierende CRM-Abfrage.
Kein Fix brauchte ein neues Modell. Wir haben alles in eine EU-Region gezogen, den Prompt gekürzt und cachebar gemacht und den Agenten erst bestätigen, dann nachschlagen lassen. Semantische Turn-Erkennung ersetzte den Stille-Timeout, und die Kontextkürzung beim Barge-in behob einen Fehler, der als „Bot wiederholt sich" im Ticketsystem stand. Die schwierigste Frage war organisatorisch: Wem gehört ein Budget, das sich über drei Anbieter verteilt?
Kaskade oder Speech-to-Speech? Die Entscheidungstabelle
| Anforderung | Kaskade STT → LLM → TTS | Speech-to-Speech |
|---|---|---|
| Exaktes Transkript für Compliance und QS | Nativ: das Transkript ist die Eingabe | Nebenprodukt; Genauigkeit prüfen |
| Verlässliches mehrstufiges Tool-Calling | Heute am stärksten | Wird besser; mit eigenen Flows testen |
| Freie Wahl der Stimme, Custom Voice | Jede TTS | An das Modell gekoppelt (Azure Voice Live ergänzt Azure-Stimmen) |
| Natürliche Prosodie und Emotion | Geht im Transkript verloren | Bleibt erhalten |
| Gemischtsprachige Anrufer | Schwieriger | Besser, laut Pipecat-Primer |
| Tuning je Hop, Anbieterwechsel | Ja | Nein: ein undurchsichtiger Hop |
| Datenresidenz in der EU | Je Komponente zusammenstellen | Verarbeitungsoptionen des Modells prüfen |
| Engineering-Aufwand | Höher | Geringer |
Unsere Faustregel: Offene Servicegespräche können mit Speech-to-Speech starten. Authentifizierung, Zahlungen, Schadenmeldungen und alles, was Sie wortgetreu nachvollziehen müssen, bleiben in der Kaskade, bis Ihre eigenen Tests etwas anderes zeigen.
Governance für europäische Unternehmen
KI-Verordnung. Art. 50 Abs. 1 gilt seit dem 2. August 2026: Menschen müssen spätestens bei der ersten Interaktion erfahren, dass sie mit einem KI-System sprechen, sofern das nicht offensichtlich ist. Am Telefon ist es das nie, also gehört der Hinweis in die Begrüßung. Anbieter von Systemen, die synthetische Audioinhalte erzeugen, müssen diese nach Art. 50 Abs. 2 maschinenlesbar kennzeichnen; der KI-Omnibus, Verordnung (EU) 2026/1744, gibt Systemen, die vor dem 2. August 2026 in Verkehr gebracht wurden, Zeit bis zum 2. Dezember 2026. Vorsicht bei Emotionsanalysen: Art. 5 Abs. 1 Buchst. f verbietet seit Februar 2025 die Emotionserkennung am Arbeitsplatz, und die Leitlinien der Kommission nennen die Sprachüberwachung von Call-Center-Beschäftigten als Beispiel. Emotionserkennung bei Kunden ist nicht verboten, aber ein Hochrisiko-Anwendungsfall nach Anhang III. Diese Pflichten wurden auf den 2. Dezember 2027 verschoben, die Informationspflicht gegenüber Betroffenen nach Art. 50 Abs. 3 gilt bereits. Wo diese Kontrollen im Gesamtbild liegen, zeigt unsere Referenzarchitektur für Agentenplattformen.
DSGVO und deutsches Strafrecht. Aufzeichnungen, Transkripte, Traces und Eval-Datensätze enthalten personenbezogene Daten: Dokumentieren Sie Rechtsgrundlage und Löschfrist je Speicherort. Stimmabdrücke zur Authentifizierung sind biometrische Daten zur eindeutigen Identifizierung nach Art. 9 DSGVO. § 201 StGB stellt die unbefugte Aufnahme des nichtöffentlich gesprochenen Wortes unter Strafe: Der Hinweis auf die Aufzeichnung ist keine Formalie.
PCI DSS. Gesprochene Kartennummern landen in Audio, Transkript und LLM-Kontext. Halten Sie sie mit DTMF-Maskierung oder einem eigenen Zahlungsfluss heraus, wie es die PCI-SSC-Leitlinie für Telefonzahlungen empfiehlt.
Pragmatischer Einführungspfad
- Einen Gesprächsfluss wählen und instrumentieren. Ein häufiger, risikoarmer Anlass wie der Bestellstatus. Tracen Sie jeden Hop und messen Sie p50 und p95 Voice-to-Voice auf echten Telefonaten, nicht über WebRTC.
- Erst das Budget, dann die Anbieter. Legen Sie Ziele je Hop fest und wählen Sie Komponenten, die sie in einer EU-Region erreichen.
- Die unspektakulären Pfade zuerst. Barge-in mit Kontextkürzung, Warm Transfer, KI-Hinweis und Aufzeichnungseinwilligung.
- Beide Architekturen an denselben Anrufen testen. Bewerten Sie Aufgabenerfolg, Latenz, falsche Unterbrechungen und Transkriptgenauigkeit.
- Nach Gesprächsfluss skalieren, nicht nach Kanal. Neue Anlässe nur, solange Automatisierungsquote und Beschwerden stabil bleiben; Identitätsprüfung und Zahlungen bleiben auf deterministischen Pfaden.
Das Fazit
Voice-AI ist 2026 reif für den Unternehmenseinsatz. Der Engpass sind nicht mehr die Modelle, sondern die Architektur um sie herum. Wer jedem Hop ein Budget und einen Verantwortlichen gibt, Barge-in und Übergabe vor der Persona baut und Kaskade oder Speech-to-Speech je Gesprächsfluss wählt, liefert Agenten, bei denen Anrufer dranbleiben.
Wirkt Ihr Voice-Pilot zu langsam, führt unser Team für KI-Architektur genau diese Latenz- und Compliance-Prüfung je Hop durch. Sie gehen mit einem ausgefüllten Budget für Ihren eigenen Stack heraus.
FAQ
Welche Latenz ist für einen Voice-AI-Agenten im Unternehmen realistisch?
Planen Sie mit einer medianen Voice-to-Voice-Latenz deutlich unter einer Sekunde, vor der Laufzeit im Telefonnetz. Unser Planungsbudget liegt bei etwa 820 ms: 200 ms Transport, 250 ms Transkription und Turn-Ende, 250 ms bis zum ersten LLM-Token, 20 ms Chunking und 100 ms bis zum ersten TTS-Audio. Die Referenz-Pipeline des Pipecat-Primers kommt auf 1.293 ms. Messen Sie auch das 95. Perzentil.
Speech-to-Speech-Modell oder kaskadierte Pipeline aus STT, LLM und TTS?
Die Kaskade passt, wenn Sie verlässliches Tool-Calling, ein exaktes Transkript, freie Wahl von Stimme und Modell sowie Tuning je Hop brauchen. Speech-to-Speech, etwa OpenAIs gpt-realtime-Familie, Gemini Live, Amazon Nova Sonic oder Azure Voice Live, passt, wenn Prosodie, gemischtsprachige Anrufer und weniger Komponenten wichtiger sind. Sie können auch beides betreiben, je nach Gesprächsfluss.
Was ist Barge-in und warum ist es schwierig?
Barge-in bedeutet, dass Anrufer den Agenten mitten im Satz unterbrechen können. Das System muss echte Sprache von Husten oder dem eigenen Echo unterscheiden, die Wiedergabe stoppen, laufende LLM- und TTS-Arbeit abbrechen und den Gesprächsverlauf auf das tatsächlich Gehörte kürzen. Ohne diese Kürzung glaubt der Agent, Dinge gesagt zu haben, die niemand gehört hat.
Gilt die KI-Verordnung für Voicebots im Contact Center?
Ja. Seit dem 2. August 2026 verlangt Art. 50 Abs. 1, dass Anrufer erfahren, dass sie mit einer KI sprechen, sofern das nicht offensichtlich ist. Anbieter synthetischer Audioinhalte müssen diese nach Art. 50 Abs. 2 maschinenlesbar kennzeichnen; für Bestandssysteme gilt eine Übergangsfrist bis 2. Dezember 2026. Emotionserkennung bei Beschäftigten ist verboten, bei Kunden ab 2. Dezember 2027 hochriskant nach Anhang III.
Lassen sich die Daten eines Voice-Agenten in der EU halten?
Weitgehend, wenn Sie bewusst auswählen. OpenAI dokumentiert einen EU-SIP-Endpunkt für die Realtime API, Azure Voice Live bietet Data-Zone- und regionale Varianten seiner Echtzeitmodelle, und AWS führt Nova 2 Sonic in Stockholm. Prüfen Sie jede Komponente einzeln: Sprache, Modell, Aufzeichnungen, Transkripte und Traces können an verschiedenen Orten liegen.
Darf ein Voice-Agent Kartenzahlungen am Telefon annehmen?
Nicht, indem er Kartennummern mithört. Gesprochene Kartendaten in Aufzeichnungen, Transkripten oder im LLM-Kontext ziehen all diese Systeme in den PCI-DSS-Scope. Übergeben Sie den Zahlschritt an DTMF-Maskierung oder eine Payment-IVR und kehren Sie mit einem Token zum Agenten zurück, wie es die Leitlinie des PCI Security Standards Council für Telefonzahlungen empfiehlt.
Quellen
Alle Quellen geprüft am 15. November 2026. Latenzangaben der Hersteller sind deren eigene Werte unter eigenen Messbedingungen. Die ms-Ziele im Diagramm und in Chart 2 sind unsere Planungswerte.
Tier A: Primärquellen, Normen, Regulierung
- ITU-T Recommendation G.114 (05/2003), One-way transmission time (Einweg-Übertragungszeit): https://www.itu.int/rec/T-REC-G.114
- Verordnung (EU) 2024/1689 (KI-Verordnung), Art. 5, Art. 50 und Anhang III: https://eur-lex.europa.eu/eli/reg/2024/1689/oj/eng
- Europäische Kommission, Rechtsrahmen und Zeitplan der KI-Verordnung: https://digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai
- Verordnung (EU) 2016/679 (DSGVO), Art. 4 Nr. 14 und Art. 9: https://eur-lex.europa.eu/eli/reg/2016/679/oj/eng
- § 201 StGB, Verletzung der Vertraulichkeit des Wortes: https://www.gesetze-im-internet.de/stgb/__201.html
- PCI SSC, Protecting Telephone-Based Payment Card Data (Information Supplement v3.0, Nov. 2018): https://listings.pcisecuritystandards.org/documents/Protecting_Telephone_Based_Payment_Card_Data_v3-0_nov_2018.pdf
- OpenAI, Realtime API with SIP: https://developers.openai.com/api/docs/guides/realtime-sip
- OpenAI, Realtime voice activity detection: https://developers.openai.com/api/docs/guides/realtime-vad
- Microsoft Learn, Voice Live API overview (Stand Okt. 2026): https://learn.microsoft.com/en-us/azure/ai-services/speech-service/voice-live
- AWS, Amazon Nova 2 release notes: https://docs.aws.amazon.com/nova/latest/nova2-userguide/release-notes.html
Tier B: Forschung und Analyse
- Pipecat / Daily, Voice AI & Voice Agents: An Illustrated Primer (Stand Juni 2026): https://voiceaiandvoiceagents.com/
- Stivers et al., Universals and cultural variation in turn-taking in conversation, PNAS 2009: https://doi.org/10.1073/pnas.0903616106
- Gartner, Kundenumfrage zu GenAI im Kundenservice (Aug. 2026), berichtet von CRM Magazine: https://www.destinationcrm.com/Articles/CRM-News/CRM-Featured-Articles/Companies-Using-GenAI-for-Customer-Service-Must-Provide-Access-to-a-Human-Agent-176195.aspx
- CRM Magazine, Customer Service AI Spending Surges Amid Budget Stagnation (Sep. 2026): https://www.destinationcrm.com/Articles/CRM-Insights/Insight/Customer-Service-AI-Spending-Surges-Amid-Budget-Stagnation-176758.aspx
- Cloud Security Alliance, Research Note zur Übergangsfrist für die Kennzeichnung nach Art. 50: https://labs.cloudsecurityalliance.org/research/csa-research-note-eu-ai-act-article50-watermarking-deadline/
- Gibson Dunn, EU AI Act Omnibus agreement: https://www.gibsondunn.com/eu-ai-act-omnibus-agreement-postponed-high-risk-deadlines-and-other-key-changes/
- Bird & Bird, AI and the workplace: prohibited AI practices: https://cm.twobirds.com/en/insights/2025/global/ai-and-the-workplace-navigating-prohibited-ai-practices-in-the-eu
Tier C: Hersteller und Nachrichten, richtungsweisend
- The Next Web, OpenAI launches GPT-Realtime-2 (Mai 2026): https://thenextweb.com/news/openai-gpt-realtime-2-voice-models
- Google, Build real-time voice applications with Gemini 3.8 Live and 3.5 Transcribe (15. Sep. 2026): https://blog.google/innovation-and-ai/technology/developers-tools/build-real-time-voice-applications-gemini-audio/
- AWS News Blog, Introducing Amazon Nova 2 Sonic: https://aws.amazon.com/blogs/aws/introducing-amazon-nova-2-sonic-next-generation-speech-to-speech-model-for-conversational-ai
- Deepgram, Introducing Flux: conversational speech recognition: https://deepgram.com/learn/introducing-flux-conversational-speech-recognition
- ElevenLabs, Models overview (Latenz Flash v2.5): https://elevenlabs.io/docs/overview/models
- ElevenLabs, Understanding latency: https://elevenlabs.io/docs/eleven-api/concepts/latency
- Microsoft Developer Community, Voice Live API general availability (Sep. 2025): https://techcommunity.microsoft.com/blog/azure-ai-foundry-blog/upgrade-your-voice-agent-with-azure-ai-voice-live-api/4458247
Themen