SLM selbst hosten oder API? Der TCO-Break-even-Rechner
Ab wann lohnt es sich, ein Small Language Model selbst zu betreiben statt per Token zu zahlen? Transparente TCO-Formel, EU-Listenpreise und xlsx-Rechner.
Am 15. November 2026 kostet ein Azure-Knoten NC40ads H100 v5 in Germany West Central laut Liste 8,15 € pro Stunde. Im Dauerbetrieb sind das 5.946 € im Monat, mit dreijähriger Reservierung 3.271 €. Am selben Tag kostet eine Million Eingabe-Tokens für GPT-5.4 nano in der EU-Datenzone 0,20 €. Und jede Woche fragt irgendwo ein Vorstand: „Wäre es nicht günstiger und souveräner, ein kleines Modell selbst zu betreiben?" Die ehrliche Antwort hängt an einer Zahl, die die meisten Teams nie gemessen haben: Tokens pro Monat.
Dieser Beitrag richtet sich an alle, die diese Entscheidung verantworten: CTOs, CISOs, Plattformverantwortliche und Architekten. Wir legen eine transparente Formel offen, setzen tagesaktuell geprüfte Listenpreise ein und zeigen, wo der Break-even tatsächlich liegt. Im Rechner ersetzen Sie jede Annahme durch Ihre eigene. Unser Ergebnis vorweg: Allein über die Kosten gewinnt der Eigenbetrieb eines Small Language Models selten unterhalb von zig Milliarden Tokens pro Monat. Souveränität und Offline-Betrieb sind die besseren Gründe, und sie verdienen eine eigene Zeile im Business Case.
TL;DR / Das Wichtigste in Kürze
- Die Untergrenze entscheidet, nicht die GPU. Eine H100 mit einem 8B-Modell hat mehr Kapazität, als die meisten Workloads nutzen. Zwei Knoten, Plattform und Personal bilden eine fixe Untergrenze von rund 11.900 € pro Monat bei dreijähriger Reservierung.
- Der Break-even liegt im Milliardenbereich. In unserem Referenz-Workload schlägt der Eigenbetrieb GPT-5.4 ab 3,4 Mrd. Tokens pro Monat, GPT-5.4 mini ab 11,3 Mrd. und GPT-5.4 nano ab 41,6 Mrd.
- Vergleichen Sie Gleiches mit Gleichem. Ein 8B-Modell konkurriert qualitativ mit APIs der Nano-Klasse, nicht mit Frontier-Modellen. Erst die Evaluierung, dann die Rechnung.
- Der Aufschlag für die EU-Datenzone ist klein. Azure listet Data Zone EU für die GPT-5.4-Familie 10 % über Global. Das ist die günstigste Souveränitätsmaßnahme, die Sie kaufen können.
- In der Praxis gewinnt hybrid. Ein Gateway, das jede Aufgabe an die günstigste Option leitet, die ihre Evaluierung besteht, schlägt jede Einzelentscheidung.

Download: Editierbare draw.io-Datei · In diagrams.net öffnen · Diagrammdaten (CSV) · TCO-Rechner (xlsx)
Warum das jetzt wichtig ist
In den Budgets für 2026 treffen zwei Kräfte aufeinander. Erstens sind kleine Modelle für die meisten Unternehmensaufgaben gut genug geworden. Gartner prognostizierte im April 2025, dass Unternehmen bis 2027 kleine, aufgabenspezifische KI-Modelle dreimal häufiger nutzen werden als allgemeine LLMs. Open-Weight-Modelle mit 8 bis 30 Milliarden Parametern erledigen Klassifikation, Extraktion, Zusammenfassung und Routing inzwischen so gut, dass ein Frontier-Modell für den Großteil des Traffics überdimensioniert ist.
Zweitens die Souveränität. Im November 2025 meldete Gartner, dass 61 % der 241 befragten CIOs und IT-Verantwortlichen in Westeuropa erwarten, dass die Geopolitik ihre Abhängigkeit von lokalen Cloud-Anbietern erhöht. Im DACH-Raum fragen heute die meisten KI-Lenkungsgremien, mit denen wir arbeiten, wo das Modell läuft und wer zur Herausgabe der Prompts gezwungen werden könnte.
Gleichzeitig fallen die API-Preise weiter. Epoch AI stellte im März 2025 fest, dass der Preis für ein bestimmtes Leistungsniveau je nach Benchmark um das 9- bis 900-Fache pro Jahr gesunken ist. Eine dreijährige GPU-Reservierung ist eine Wette gegen diese Kurve.
Die vier Betriebsoptionen im Überblick
Das Titeldiagramm ordnet die Optionen danach, wie viel Kontrolle Sie gewinnen und wie viel Last Sie tragen.
① Öffentliche Modell-API
Sie rufen den Endpunkt eines Anbieters auf und zahlen pro Token. Der Anbieter betreibt GPUs, Skalierung und Upgrades. Die Fixkosten liegen nahe null. Sie steuern Prompts, Schlüssel und Vertrag, sonst nichts. Für Exploration und sprunghafte, kleine Volumina ist das der richtige Standard, aber die falsche Antwort, wenn Ihre Richtlinie die Rechtsordnung des Anbieters ausschließt.
② Verwalteter privater Endpunkt
Das Modell betreibt weiterhin der Anbieter, aber innerhalb einer definierten Grenze. Bei Azure verarbeitet eine Data-Zone-Bereitstellung Prompts und Antworten nur innerhalb der von Microsoft definierten Datenzone. Die EU-Zone folgt der EU Data Boundary, die auch EFTA-Staaten einschließen kann. Ruhende Daten bleiben in Ihrer gewählten Geografie. Sie erreichen die Bereitstellung über einen Private Endpoint in Ihrem eigenen VNet, ohne öffentlichen Netzwerkpfad.
Abgerechnet wird pro Token (Data Zone Standard) oder pro reservierter Durchsatzeinheit (Data Zone Provisioned), und Data Zone Batch gewährt 50 % Rabatt für asynchrone Aufträge. Am 15. November 2026 wies die Azure Retail Prices API für GPT-5.4 mini in der Data Zone EU 0,74 € pro Million Eingabe- und 4,44 € pro Million Ausgabe-Tokens aus, exakt 10 % über Global. Prüfen Sie vorher, ob sich das Modell tatsächlich bereitstellen lässt, denn ein Preis-Meter ist noch keine verfügbare Bereitstellung. Mitte 2026 beschrieb Microsoft Q&A 5.4 mini und nano als Data Zone Standard noch als reine US-Angebote, ohne Termin für die EU-Zone.
③ AKS + vLLM im Eigenbetrieb
Sie betreiben ein Open-Weight-Modell auf GPU-Knoten in Ihrer eigenen Subscription, ausgeliefert über vLLM auf Kubernetes. Sie wählen die Gewichte, fixieren die Version und behalten die Logs. Die Größe NC40ads H100 v5 bietet eine H100 NVL mit 94 GB, genug für ein 8B-Modell mit reichlich KV-Cache oder ein Modell der 30B-Klasse in FP8. Das Kostenmodell ändert seine Form: GPU-Stunden mal Knoten, plus Cluster, plus Personal. Das ist eine Treppenfunktion, keine Gerade. Unser Leitfaden zu vLLM und KServe auf AKS beschreibt die Serving-Architektur, unser Beitrag zur GPU-Kostensteuerung die Auslastung der Knoten.
④ Edge und On-Premises
Derselbe Stack läuft auf eigener Hardware: im Rechenzentrum, in der Fertigung oder an einem Standort, der auch ohne WAN funktionieren muss. vLLM und llama.cpp laufen vollständig offline. Sie steuern alles, auch Strom, Ersatzteile und den Erneuerungszyklus. Aus der GPU-Stunde werden Investitionskosten geteilt durch Monate, plus Strom, Kühlung, Rackfläche und Support. Dazwischen liegt dedizierte Hardware bei einem EU-Hoster. Hetzner listet den GEX131 mit einer RTX PRO 6000 Blackwell Max-Q (96 GB) in Falkenstein und Helsinki ab 1.499 € pro Monat zuzüglich 1.499 € Einrichtung. Mangels veröffentlichtem MLPerf-Ergebnis für diese Karte mit Llama 3.1 8B fehlt sie in der Break-even-Kurve; selbst gemessenen Durchsatz nimmt der Rechner als Eingabe.
⑤ Das Gateway: nach Aufgabe routen, nicht nach Ideologie
Die kosteneffizientesten Landschaften, die wir sehen, entscheiden sich nicht für eine Option. Sie stellen ein KI-Gateway vor alle und leiten jede Aufgabe an die günstigste Bereitstellung, die ihre Evaluierung besteht: Massenextraktion zum selbst betriebenen SLM, sobald das Volumen es rechtfertigt, anspruchsvolles Reasoning zur Frontier-API, Assistenten in der Fertigung an die Edge. Das Gateway setzt zudem Kontingente durch, ordnet Kosten zu und filtert personenbezogene Daten.
Die Formel
Jede Zahl in diesem Beitrag folgt aus dieser Formel. Der Rechner bildet sie mit Live-Zellen ab.
anteil_ein = eingabe_tokens / (eingabe_tokens + ausgabe_tokens)
b_api      = anteil_ein × p_ein + (1 − anteil_ein) × p_aus     [€ pro 1 Mio. Tokens]
API(T)     = T / 1.000.000 × b_api

kap_knoten = ausgabe_tok_pro_s / ausgabe_tokens × (eingabe_tokens + ausgabe_tokens)
             × auslastung × 3.600 × 730                         [Tokens pro Monat]
knoten(T)  = max(n_min, aufrunden(T / kap_knoten))
EIGEN(T)   = knoten(T) × knotenpreis + plattform + personal

Break-even T* = (n_min × knotenpreis + plattform + personal) / b_api × 1.000.000
                (gültig, solange T* ≤ n_min × kap_knoten)
Die Eingaben und ihre Herkunft:
- Workload. Das Profil des MLPerf-Inference-v5.1-Benchmarks Llama 3.1 8B: im Schnitt 778 Eingabe- und 73 Ausgabe-Tokens je Anfrage (Zusammenfassung von CNN-DailyMail). Für dieses Profil gibt es einen öffentlichen Durchsatzwert, und es ist typisch für SLM-Aufgaben im Unternehmen: viel lesen, wenig schreiben.
- Durchsatz. Die MLPerf-v5.1-Einreichung von Red Hat: 5.104 Tokens pro Sekunde auf einer H100-SXM-80GB im Server-Szenario (2 Sekunden bis zum ersten Token, 100 ms je Ausgabe-Token), mit vLLM 0.10.0 und Llama 3.1 8B in FP8. Azures NC40ads nutzt die Variante H100 NVL. Betrachten Sie den Wert als Näherung und messen Sie selbst.
- GPU-Knoten. NC40ads H100 v5, Germany West Central, Azure Retail Prices API: 8,1458 € pro Stunde nach Verbrauch, 53.517,66 € für ein Jahr reserviert, 117.739,58 € für drei Jahre. Das sind 5.946 €, 4.460 € und 3.271 € pro Monat.
- Plattform. AKS-Tarif Standard (0,0898 € pro Stunde) plus zwei Systemknoten D4s v5 (je 0,2065 € pro Stunde): 367 € pro Monat.
- Unsere Annahmen. 50 % durchschnittliche Auslastung, mindestens zwei GPU-Knoten für Verfügbarkeit und rollierende Upgrades sowie 5.000 € pro Monat für Personal (etwa eine halbe Stelle bei Vollkosten von rund 120.000 € im Jahr). Ersetzen Sie alle drei.
- API-Preise. Die GPT-5.4-Familie in der Data Zone EU laut Azure Retail Prices API; Mistral Small 4 zu 0,15 USD Eingabe und 0,60 USD Ausgabe pro Million Tokens, umgerechnet zum EZB-Referenzkurs von 1,1052 (13. November 2026).
Was die Zahlen sagen
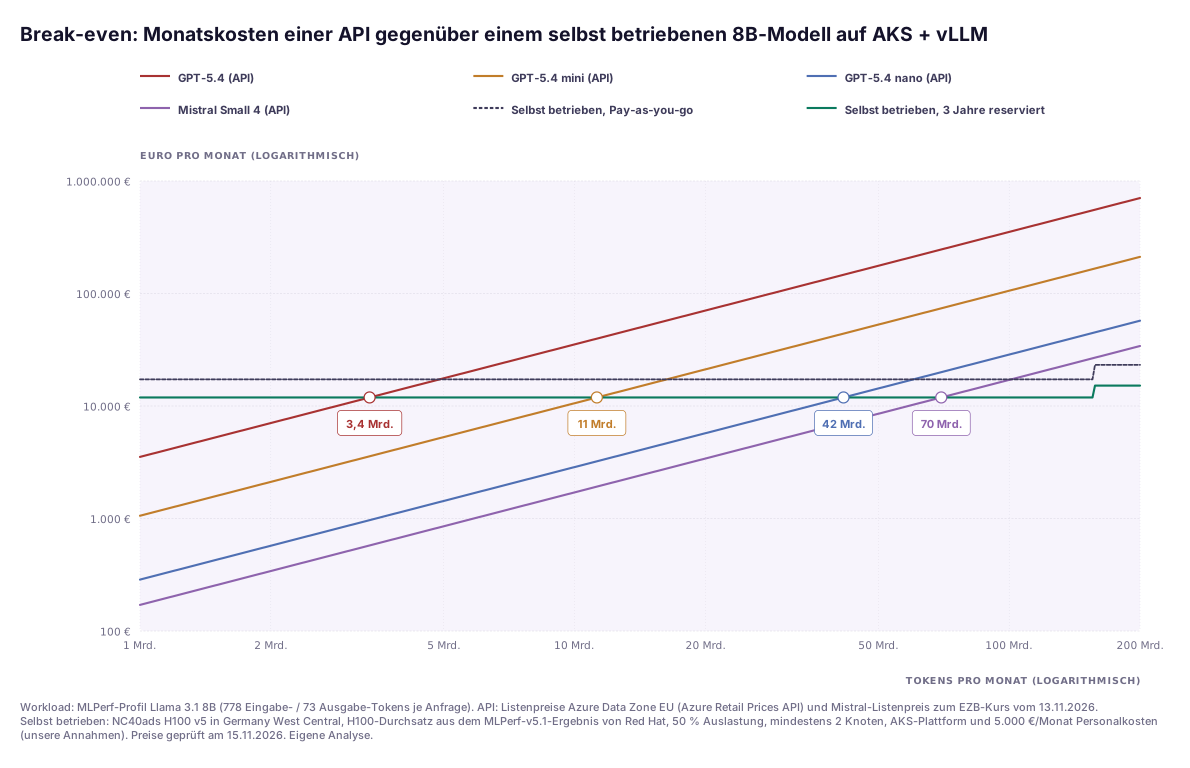
Die Linien für den Eigenbetrieb verlaufen fast über das ganze Diagramm flach, und darin liegt die Kernaussage. Ein H100-Knoten bei 50 % Last bewältigt in diesem Workload rund 78 Mrd. Tokens pro Monat, etwa 35 Anfragen pro Sekunde rund um die Uhr. Mit zwei Knoten als Minimum wird ein dritter erst bei etwa 156 Mrd. Tokens nötig. Darunter zahlen Sie die Untergrenze: 11.908 € pro Monat bei dreijähriger Reservierung oder 17.260 € nach Verbrauch.
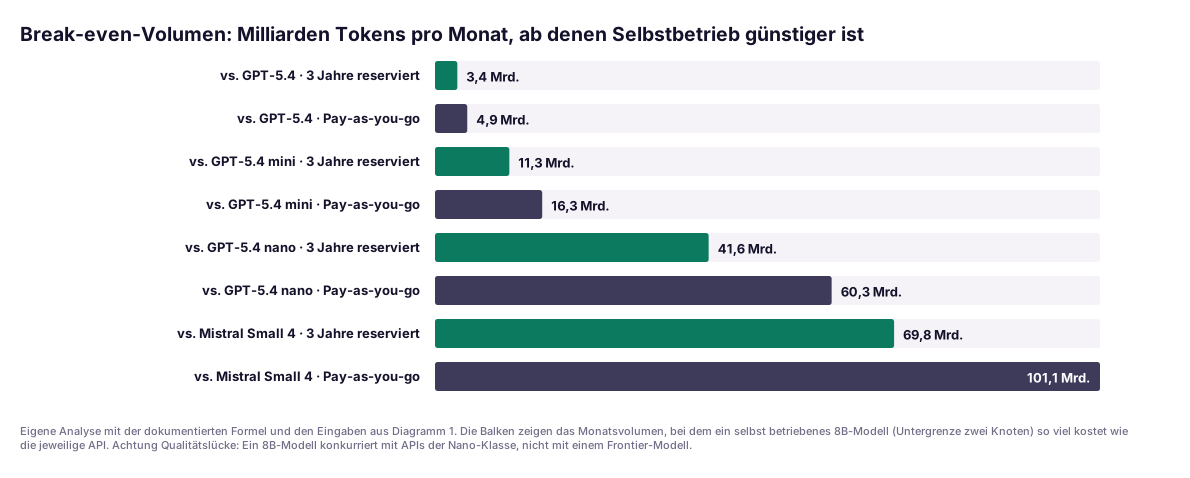
Drei Lesarten sind für die Entscheidung wichtig.
Erstens: Der faire Vergleich ist die Nano-Linie. Ein 8B-Modell erreicht GPT-5.4 beim anspruchsvollen Reasoning nicht. Der Break-even von 3,4 Mrd. zählt also nur, wenn Ihre Evaluierung das kleine Modell für ausreichend befindet. Gegenüber GPT-5.4 nano, qualitativ am nächsten, rechnet sich der Eigenbetrieb ab 41,6 Mrd. Tokens pro Monat: rund 49 Millionen Anfragen oder im Schnitt 19 pro Sekunde. Gegenüber Mistral Small 4, einem Mixture-of-Experts-Modell unter Apache-2.0-Lizenz, das auch als günstige API angeboten wird, brauchen Sie etwa 70 Mrd.
Zweitens: Unterhalb der Untergrenze spielt die Auslastung kaum eine Rolle. Halbieren Sie sie auf 25 %, verschiebt sich kein einziger Break-even-Punkt. Was ihn verschiebt, ist die fixe Untergrenze. Ohne Personalkosten sinkt der Nano-Break-even auf 24,1 Mrd. Ein einzelner Knoten ohne Personal, den wir so nicht produktiv betreiben würden, bringt ihn auf 12,7 Mrd. Verdoppeln Sie die Personalkosten auf 10.000 €, steigt er auf 59 Mrd. Die Entscheidung reagiert stärker auf Ihr Betriebsmodell als auf Ihre GPU.
Drittens: Die Form des Workloads ist die versteckte Variable. Unser Profil liest 778 Tokens und schreibt 73. Chat, Agenten und Code schreiben weit mehr, und Ausgabe-Tokens sind das, was eine GPU auslastet. Die Kapazität pro Knoten kann um eine Größenordnung sinken, die Stufen kommen viel früher, und die API steht oft besser da, als dieses Diagramm nahelegt. Messen Sie Ihren eigenen Token-Mix, bevor Sie irgendetwas kaufen.
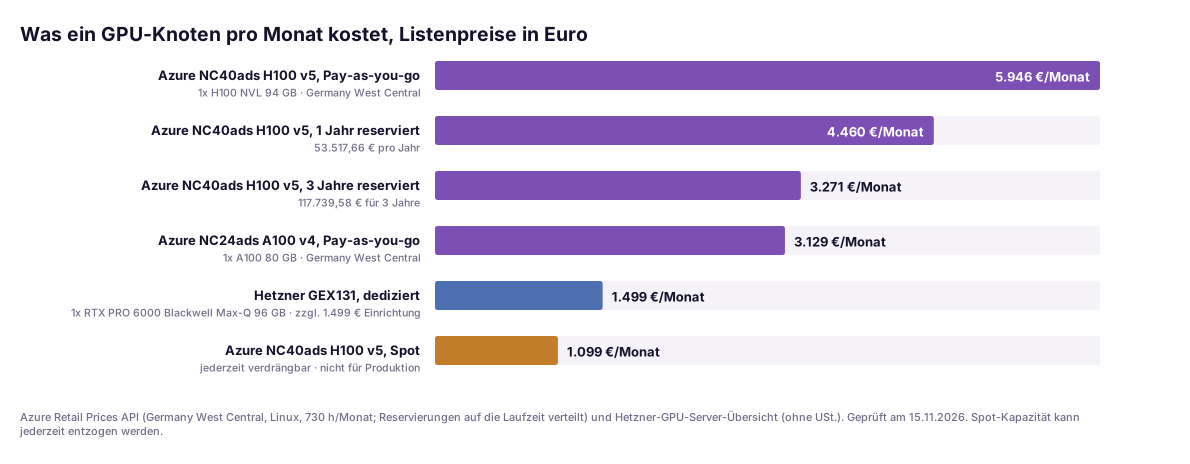
Eine dreijährige Bindung senkt den Preis des H100-Knotens gegenüber Pay-as-you-go um 45 %. Das ist viel Geld und zugleich eine Dreijahreswette auf eine GPU-Generation. Spot-Kapazität für 1.099 € pro Monat kann jederzeit entzogen werden und eignet sich für Batch-Evaluierungen, nicht für den Produktivbetrieb. Die Hetzner-Zeile zeigt, warum dedizierte EU-Hardware souveränitätsgetriebene Teams anzieht. Behandeln Sie sie als Preispunkt, bis Sie die Karte selbst vermessen haben.
Aus einem aktuellen Projekt
Eine regulierte Organisation im DACH-Raum bat uns, einen Business Case zu prüfen: Ihre Assistenten für die Dokumentenverarbeitung sollten von einer US-gehosteten API auf selbst betriebene Open-Weight-Modelle umziehen. Der Business Case enthielt ein GPU-Angebot und einen Tokenpreis, sonst nichts: kein gemessenes Volumen, kein Token-Mix, kein Latenzziel.
Wir haben den Traffic vier Wochen lang über das bestehende Gateway instrumentiert. Das Volumen lag in jedem Szenario deutlich unter der Untergrenze, und der Workload war stark eingabelastig. Bei den Kosten verlor der Eigenbetrieb klar. Bei der Souveränität, dem eigentlichen Treiber, erfüllte eine Bereitstellung in der EU-Datenzone hinter einem Private Endpoint die Richtlinie für alle Anwendungsfälle bis auf einen: einen Produktionsstandort ohne verlässliche Netzanbindung.
Das Ergebnis war hybrid. Die API zog in die EU-Datenzone, mit Gateway-Routing und Kostenzuordnung je Team. Eine kleine Edge-Installation versorgt den Offline-Standort. Und ein schriftlicher Auslöser setzt den Eigenbetrieb wieder auf die Agenda, sobald das gemessene Volumen den Break-even überschreitet. Die längste Diskussion war nicht technisch. Es ging darum, wem der Evaluierungsdatensatz gehört, der entscheidet, ob ein kleines Modell gut genug ist.
Die Entscheidungstabelle
Lesen Sie jede Zeile als „Wenn das zutrifft, tendieren Sie zu".
| Situation | Tendenz | Warum |
|---|---|---|
| Volumen unbekannt oder unter ca. 1 Mrd. Tokens/Monat | ① oder ② API | Weit unter jeder Fixkostenschwelle; erst messen |
| Sprunghafter Traffic, viele Modelle, schnell wechselnde Anforderungen | ② Data Zone Standard | Zahlung pro Token, Verarbeitung in der EU, kein Kapazitätsrisiko |
| Konstant hohes Volumen, latenzkritisch, Modell muss vom Anbieter kommen | ② Data Zone Provisioned | Reservierter Durchsatz ohne eigene GPUs |
| Volumen über Ihrem Break-even, und ein SLM besteht Ihre Evaluierung | ③ AKS + vLLM | Fixkosten verteilen sich auf genug Tokens |
| Richtlinie verlangt europäische Kontrolle über Gewichte und Stack | ③ auf EU-Infrastruktur oder ④ | Die Datenzone allein genügt womöglich nicht |
| Offline, Air-Gap oder Latenz in der Fertigung | ④ Edge | Die einzige Option, die ohne WAN funktioniert |
| Ausgabelastiger Chat oder Agenten bei mittlerem Volumen | ① oder ② API | Decode-lastige Arbeit füllt GPUs schnell; Stufen greifen früh |
| Große asynchrone Aufträge | ② Data Zone Batch | 50 % unter Listenpreis, Zielzeit 24 Stunden |
Vergleichen Sie ein selbst betriebenes Modell nie mit einer API, die es auf Ihrem Evaluierungsdatensatz nicht erreicht, und reservieren Sie keine GPUs für drei Jahre ohne Plan für das Modell, das Sie im dritten Jahr betreiben.
Governance für europäische Unternehmen
DSGVO. Jede Option außer ④ beinhaltet einen Auftragsverarbeiter. Ihr Vertrag nach Art. 28 DSGVO, das Verzeichnis von Verarbeitungstätigkeiten und die Bewertung von Drittlandübermittlungen müssen zum tatsächlich genutzten Bereitstellungstyp passen: Global und Data Zone EU sind für denselben Modellnamen unterschiedliche Verarbeitungsorte. Fixieren Sie den Typ per Azure Policy, damit niemand wegen des höheren Kontingents stillschweigend auf Global wechselt.
KI-Verordnung. Das Hosting ändert nichts daran, ob ein Anwendungsfall ein Hochrisiko-System ist. Das hängt vom Einsatzzweck ab, und die Pflichten nach Anhang III gelten nun ab dem 2. Dezember 2027. Wer Open-Weight-Modelle unverändert betreibt, wird dadurch nicht zum Anbieter des KI-Modells mit allgemeinem Verwendungszweck; die Pflichten knüpfen an das KI-System an, das Sie darauf aufbauen. Durch Feinabstimmung werden Sie nur bei einer wesentlichen Änderung zum Anbieter eines veränderten KI-Modells mit allgemeinem Verwendungszweck. Die Leitlinien der Kommission vom Juli 2025 nennen als Richtwert mehr als ein Drittel der ursprünglichen Trainingsrechenleistung, weit über typischen LoRA-Feinabstimmungen. Dokumentieren Sie trotzdem Basismodell, Datenübersicht und eingesetzte Rechenleistung.
DORA. Für Finanzunternehmen ist eine API, die eine kritische oder wichtige Funktion unterstützt, ein IKT-Drittdienst. Sie gehört ins Informationsregister, und Art. 28 Abs. 8 verlangt eine Ausstiegsstrategie. Selbst betriebene Open-Weight-Modelle sind ein glaubwürdiger Ausstiegspfad, und der Rechner beziffert ihn. Schon das kann rechtfertigen, Option ③ auch unterhalb des Break-even betriebsbereit zu halten. Die Infrastrukturseite dieses Ausstiegs behandelt unser Vergleich souveräner Clouds.
Ein pragmatischer Einführungspfad
- Woche 1–4: messen. Leiten Sie den gesamten LLM-Traffic über ein Gateway und erfassen Sie Eingabe- und Ausgabe-Tokens je Anwendungsfall, Latenzziele und Modell. Was Sie protokollieren sollten, zeigt unser Leitfaden zum Token-Kosten-Engineering.
- Woche 3–6: Evaluierungsdatensatz aufbauen. Sammeln Sie je volumenstarker Aufgabe einige hundert echte Beispiele. Lassen Sie das Frontier-Modell, eine API der Nano-Klasse und ein bis zwei Open-Weight-SLMs dagegen laufen. Die Kosten entscheiden nur zwischen Modellen, die bestehen.
- Woche 6: den richtigen API-Tarif wählen. Verlagern Sie EU-sensible Workloads in die Data Zone, asynchrone Aufträge in Batch und erzwingen Sie die Bereitstellungstypen per Policy. Das spart oft mehr, als der Eigenbetrieb würde.
- Quartal 2: den Rechner mit Ihren Zahlen füllen. Ersetzen Sie Workload, Durchsatz (gemessen mit Ihrem Modell und Latenzziel), Personalkosten und Mindestknotenzahl. Liegt ein Workload klar über dem Break-even, pilotieren Sie AKS + vLLM nach Verbrauch, bevor Sie etwas reservieren.
- Jedes Quartal: neu rechnen. Preise fallen, GPUs ändern sich, Volumen wächst. Ein schriftlicher Auslöser je Workload sorgt dafür, dass die Entscheidung wegen Daten neu aufgerollt wird, nicht wegen eines Vertriebsgesprächs.
Das Fazit
Small Language Models sind ein echter Umbruch, aber ihr Eigenbetrieb ist ein Fixkostengeschäft. Zwei Knoten, eine Plattform und die Menschen, die sie betreiben, kosten 12.000 bis 17.000 € im Monat, bevor das erste Token fließt, und die meisten Unternehmens-Workloads füllen das bei Weitem nicht aus. Allein über die Kosten gewinnt eine API in der EU-Datenzone unterhalb von zig Milliarden Tokens pro Monat, und ihr Aufschlag von 10 % ist die günstigste Souveränitätsmaßnahme am Markt.
Der Eigenbetrieb gewinnt in drei Fällen: bei gemessenem Volumen klar über dem Break-even für eine Aufgabe, die ein kleines Modell gut beherrscht, bei einer Richtlinie, die europäische Kontrolle über den gesamten Stack verlangt, oder an einem Standort, der offline funktionieren muss. Stellen Sie ein Gateway davor, messen Sie, bevor Sie kaufen, und lassen Sie sich jeden Workload seinen Platz auf Ihren eigenen GPUs verdienen.
Wenn Sie eine zweite Meinung zu Ihren Zahlen möchten: Unser KI-Architektur-Team führt diese Rechnung als kurzes Review mit festem Umfang auf Basis Ihres gemessenen Traffics durch, einschließlich des Evaluierungsdatensatzes, der entscheidet, welches Modell gut genug ist.
FAQ
Ab welchem Volumen ist ein selbst betriebenes Small Language Model günstiger als eine API?
Mit unseren Annahmen ab mehreren Milliarden Tokens pro Monat. Bei 778 Eingabe- und 73 Ausgabe-Tokens je Anfrage kosten zwei für drei Jahre reservierte Azure-H100-Knoten samt Plattform und einer halben Stelle rund 11.900 € pro Monat. Das entspricht GPT-5.4 bei 3,4 Mrd., GPT-5.4 mini bei 11,3 Mrd. und GPT-5.4 nano bei 41,6 Mrd. Tokens pro Monat, gerechnet mit Listenpreisen der Data Zone EU vom 15. November 2026.
Mit welcher Formel vergleicht man API- und Eigenbetriebskosten für LLMs?
API-Kosten sind Monatstokens mal Mischpreis, wobei Eingabe- und Ausgabepreis nach Ihrem Token-Mix gewichtet werden. Eigenbetrieb kostet Anzahl GPU-Knoten mal Knotenpreis plus Plattform und Personal. Die Knotenzahl ist Volumen geteilt durch Kapazität je Knoten, aufgerundet, aber nie unter Ihrem Minimum für Verfügbarkeit. Der Break-even ist das Volumen, bei dem beide gleich sind.
Warum ist der GPU-Durchsatz weniger wichtig als gedacht?
Ein kleines Modell auf einer aktuellen GPU hat mehr Kapazität, als die meisten Unternehmens-Workloads nutzen. Eine H100 mit einem 8B-Modell schaffte im MLPerf-v5.1-Serverlauf von Red Hat rund 5.100 Ausgabe-Tokens pro Sekunde, bei 50 % Last etwa 78 Mrd. Tokens pro Monat für diesen Workload. Die zwei Knoten, die Sie für Verfügbarkeit brauchen, füllen die wenigsten aus. Deshalb bestimmt die fixe Untergrenze den Break-even.
Reicht eine API in der EU-Datenzone für Souveränität, oder müssen wir selbst hosten?
Oft reicht sie. Microsoft verarbeitet Data-Zone-EU-Anfragen innerhalb der EU Data Boundary und speichert ruhende Daten in Ihrer Geografie, zu einem Aufschlag von 10 % auf die Global-Listenpreise. Die Rechtslage eines US-Anbieters ändert das nicht. Eine strenge Souveränitätsrichtlinie kann daher weiterhin Open-Weight-Modelle auf EU-Infrastruktur oder eigener Hardware verlangen.
Ändert der Eigenbetrieb eines Open-Weight-Modells unsere Pflichten nach der KI-Verordnung?
Wer ein Modell unverändert betreibt, wird dadurch nicht zum Anbieter des KI-Modells mit allgemeinem Verwendungszweck. Durch Feinabstimmung werden Sie nur bei einer wesentlichen Änderung zum Anbieter eines veränderten KI-Modells mit allgemeinem Verwendungszweck; die Leitlinien der Kommission vom Juli 2025 nennen als Richtwert mehr als ein Drittel der ursprünglichen Trainingsrechenleistung. Hochrisikopflichten nach Anhang III, die nun ab dem 2. Dezember 2027 gelten, hängen vom Einsatzzweck ab, nicht vom Hosting.
Was gehört neben GPUs in eine TCO-Rechnung für selbst betriebene LLMs?
Cluster-Steuerungsebene und Systemknoten, Monitoring und Logs, mindestens zwei GPU-Knoten für Verfügbarkeit sowie Personal für Patches, Modell-Upgrades, Evaluierung und Rufbereitschaft. On-Premises kommen abgeschriebene Investitionen, Strom, Kühlung, Rackfläche und Supportverträge hinzu. Der häufigste Fehler, den wir sehen, ist das Weglassen des Personals: Eine halbe Stelle kostet pro Monat mehr als ein reservierter H100-Knoten.
Quellen
Alle Preise und Seiten geprüft am 15. November 2026. Listenpreise ohne Umsatzsteuer und ohne verhandelte Rabatte. Wo wir eigene Annahmen verwenden, sagen Text und Rechner das ausdrücklich.
Tier A: Primärquellen, Preislisten der Anbieter und Regulierung
- Azure Retail Prices API (NC40ads H100 v5, NC24ads A100 v4, D4s v5, AKS, Data-Zone- und Global-Meter der GPT-5.4-Familie, EUR): https://prices.azure.com/api/retail/prices
- Microsoft Learn, NCads-H100-v5-Serie: https://learn.microsoft.com/en-us/azure/virtual-machines/sizes/gpu-accelerated/ncadsh100v5-series
- Microsoft Learn, Bereitstellungstypen in Microsoft Foundry Models (Data Zone, Provisioned, Batch): https://learn.microsoft.com/en-us/azure/ai-foundry/foundry-models/concepts/deployment-types
- Microsoft-Foundry-Blog, Einführung von GPT-5.4 mini und nano (17. März 2026): https://techcommunity.microsoft.com/t5/microsoft-foundry-blog/introducing-openai-s-gpt-5-4-mini-and-gpt-5-4-nano-for-low/ba-p/4500569
- Mistral AI, Modellkarte Mistral Small 4: https://docs.mistral.ai/models/mistral-small-4-0-26-03
- Hetzner, Übersicht GPU-Server (GEX131): https://www.hetzner.com/dedicated-rootserver/matrix-gpu/
- Europäische Zentralbank, Euro-Referenzkurs USD (13. November 2026): https://data-api.ecb.europa.eu/service/data/EXR/D.USD.EUR.SP00.A?lastNObservations=5&format=csvdata
- Europäische Kommission, Leitlinien zum Umfang der Pflichten für Anbieter von KI-Modellen mit allgemeinem Verwendungszweck (Juli 2025): https://digital-strategy.ec.europa.eu/de/library/guidelines-scope-obligations-providers-general-purpose-ai-models-under-ai-act
- Verordnung (EU) 2024/1689 (KI-Verordnung): https://eur-lex.europa.eu/eli/reg/2024/1689/oj/deu
- Verordnung (EU) 2022/2554 (DORA), Artikel 28: https://eur-lex.europa.eu/eli/reg/2022/2554/oj/deu
Tier B: Forschung und Benchmarks
- Red Hat, MLPerf-Inference-v5.1-Ergebnisse mit vLLM (Llama 3.1 8B auf H100 und L40S): https://www.redhat.com/en/blog/efficient-and-reproducible-llm-inference-red-hat-mlperf-inference-v51-results
- Gartner, Prognose zu kleinen, aufgabenspezifischen Modellen (9. April 2025): https://www.gartner.com/en/newsroom/press-releases/2025-04-09-gartner-predicts-by-2027-organizations-will-use-small-task-specific-ai-models-three-times-more-than-general-purpose-large-language-models
- Gartner, Geopolitik und lokale Cloud-Anbieter in Westeuropa (12. November 2025): https://www.gartner.com/en/newsroom/press-releases/2025-11-12-gartner-survey-reveals-geopolitics-will-drive-61-percent-of-cios-and-information-technology-leaders-in-western-europe-to-increase-reliance-on-local-cloud-providers
- Epoch AI, Preisentwicklung der LLM-Inferenz (12. März 2025): https://epoch.ai/data-insights/llm-inference-price-trends
Tier C: richtungsweisend
- Microsoft Q&A, Verfügbarkeit von GPT-5.4 mini und nano als Data Zone Standard (EU): https://learn.microsoft.com/en-us/answers/questions/5868707/availability-timeline-for-gpt-5-4-mini-gpt-5-4-nan
- CIO Dive, Bericht zur Gartner-Prognose über kleine Modelle: https://www.ciodive.com/news/small-AI-model-use-growth-Gartner-prediction/745435/
- The Register, Bericht zur Gartner-Umfrage zur Cloud-Souveränität in Europa: https://www.theregister.com/2025/11/13/gartner_cio_cloud_sovereignty/
Themen