vLLM auf AKS: KServe, MIG und GPU-Sharing im Betrieb
LLM-Inferenz mit vLLM auf AKS: KServe oder KAITO, MIG vs. Time-Slicing vs. MPS, KEDA-Skalierung nach Warteschlange und Kaltstart-Realität. Stand Nov. 2026.
Am 11. November 2026 hat Microsoft die AKS-Dokumentation zu Multi-Instance-GPU aktualisiert. Sie beschreibt einen verwalteten Weg, auf dem AKS NVIDIA-Treiber, Device-Plugin und DCGM-Metrik-Exporter installiert und eine A100 für Sie in Hardware-Partitionen schneidet. Sieben Wochen zuvor hatte KServe 0.21 seinem LLMInferenceService direkte KEDA-Skalierung und Scale-to-Zero spendiert. Und vLLM, die Engine unter fast allem davon, erschien am 18. Oktober in Version 0.32.0. Es war das neunzehnte Minor-Release in diesem Jahr.
Die Bausteine für ernsthafte LLM-Inferenz auf Azure Kubernetes Service sind damit vorhanden. Die Kosten entstehen in den Entscheidungen dazwischen: welche GPUs Sie wie teilen, welches Signal eine Skalierung auslöst und wie lange ein Kaltstart wirklich dauert. Dieser Beitrag richtet sich an alle, die die GPU-Rechnung verantworten und nachts erreichbar sind: Plattformverantwortliche, Cloud-Architekten und CTOs.
TL;DR / Das Wichtigste in Kürze
- Drei Pools statt einem. Ganze GPUs für tensor-parallele Modelle, MIG-Slices für kleine Modelle und Embeddings, Time-Slicing nur für Entwicklung und Test.
- Nur MIG isoliert wirklich. NVIDIA dokumentiert für MIG Speicher- und Fehlerisolation in Hardware. Beim Time-Slicing reißt ein abstürzender Workload alle anderen auf derselben GPU mit. MPS liegt dazwischen und ist weiterhin experimentell.
- Nach Warteschlange skalieren, nicht nach GPU-Auslastung. KEDA skaliert Replikate anhand von
vllm:num_requests_waiting; Cluster Autoscaler oder Node Auto-Provisioning ergänzen GPU-Nodes. - Kaltstarts dauern Minuten. Microsofts KAITO-Dokumentation nennt bis zu 10 Minuten für einen GPU-Node und bis zu 20 für einen einsatzbereiten Workspace. Scale-to-Zero ist ein Batch-Feature.
- Der Stack ist schneller als Ihr Change-Prozess. Wir haben von Januar bis Mitte November 2026 neunzehn vLLM-Minor-Versionen gezählt. Pinnen Sie Versionen und aktualisieren Sie über einen Canary.

Download: Editierbare draw.io-Datei · In diagrams.net öffnen · Diagrammdaten (CSV)
Warum das jetzt wichtig ist
Bis vor Kurzem hieß ein selbst gehostetes LLM auf Kubernetes: handgeschriebene Deployments, der NVIDIA GPU Operator und die Hoffnung, dass der Treiber das nächste Node-Image-Upgrade überlebt. 2026 haben sich drei Dinge geändert.
Erstens übernimmt AKS die GPU-Infrastruktur. Microsoft empfiehlt für die meisten Szenarien inzwischen AKS-verwaltete GPU-Node-Pools. Mit --enable-managed-gpu=true installiert und pflegt AKS NVIDIA-Treiber, Kubernetes-Device-Plugin und DCGM-Exporter und legt die MIG-Strategie (None, Single oder Mixed) bei der Pool-Erstellung fest. Der verwaltete MIG-Weg ist noch Preview (ManagedGPUExperiencePreview), und das zählt bei der Produktionsfreigabe.
Zweitens ist die Serving-Schicht erwachsen geworden. KServes LLMInferenceService baut auf llm-d auf, das am 20. Oktober 2026 Version 1.0 erreichte. Es kombiniert vLLM mit Gateway-API-Routing, einem KV-Cache-bewussten Endpoint Picker und optionaler Trennung von Prefill und Decode. Dynamic Resource Allocation, der langfristige Ersatz für das Zählen von nvidia.com/gpu-Einheiten, ist seit Kubernetes 1.34 allgemein verfügbar, und KServe 0.21 unterstützt DRA-resourceClaims in seinen Runtimes.
Drittens hat sich der Kostendruck von Tokens zu GPU-Stunden verschoben. Wer planbare Lasten mit hohem Volumen von Token-APIs wegbewegt hat (den Break-even rechnen wir in unserem TCO-Rechner für selbst gehostete SLMs durch), bezahlt GPUs nun unabhängig davon, ob sie Anfragen bedienen. GPU-Sharing und Autoskalierung sind deshalb keine Optimierungen. Sie entscheiden, ob der Business Case trägt.
Der Referenzaufbau, Schicht für Schicht
Die Nummern entsprechen den Markierungen im Diagramm. Der Aufbau geht von einem AKS-Cluster aus, der mehrere Modelle über eine OpenAI-kompatible API an interne Anwendungen und Agenten ausliefert.
① Inferenzbewusstes Routing am Eingang
Ein normaler Kubernetes-Service verteilt Verbindungen, ohne auf den Zustand des Modells zu achten. Für LLMs ist das falsch. Anfragen mit demselben langen System-Prompt sollten auf demselben Replikat landen, um den gecachten Präfix wiederzuverwenden, und ein Replikat mit fast vollem KV-Cache sollte weniger neue Anfragen bekommen als ein leeres.
Die Gateway API Inference Extension (v1.6) löst das mit einem InferencePool und einem Endpoint Picker (EPP), der Warteschlangenlänge und KV-Cache-Zustand jedes Replikats auswertet. Er läuft im CPU-System-Pool hinter dem API-Gateway, das Sie ohnehin für Authentifizierung und Kontingente nutzen. Unsere Architektur für semantisches Caching beschreibt die Cache-Schicht, die davor sitzen kann. llm-d 1.0 hat prioritäts- und fairnessbewusste Flusskontrolle ergänzt, damit ein Schwall von Agenten-Aufrufen das Chat-Frontend nicht aushungert.
② KServe LLMInferenceService als Steuerungsebene
Realistisch gibt es drei Wege, vLLM auf AKS zu betreiben.
- KAITO (das Add-on „AI toolchain operator“). Aktivierung per
az aks update --enable-ai-toolchain-operator; eineWorkspace-Ressource stellt ein Preset- oder eigenes Modell auf vLLM bereit und provisioniert GPU-Nodes. KAITO ist ein CNCF-Sandbox-Projekt, Upstream-Version 0.13.0 (24. Oktober 2026) bringt vLLM 0.30.0 mit. Laut Microsoft hinkt das Add-on typischerweise ein Release hinter dem Upstream-Projekt her und setzt GPUs mit Compute Capability 8.0 oder höher voraus. - KServe
LLMInferenceService. Die Option für Plattformteams: eine Ressource für Modell, vLLM-Runtime, Router, Canary-Rollouts und optionale Prefill-Worker. Die API ist noch Alpha (v1alpha2in KServe 0.21), Feldänderungen sind also zu erwarten. - Einfache Deployments. Ausreichend für ein oder zwei Modelle, wenn Sie Routing, Skalierung und Rollout selbst bauen.
Unsere Faustregel: KAITO, wenn ein Team schnell ein Modell braucht; KServe, wenn ein Plattformteam mehrere Modelle für mehrere Abnehmer betreibt. Lassen Sie nie beide Controller auf dieselben GPU-Pools los, denn jeder geht davon aus, dass ihm die Platzierung gehört.
③ Pools mit ganzen GPUs für tensor-parallele Modelle
Modelle, die nicht auf eine GPU passen, werden per Tensor-Parallelität auf mehrere verteilt. Das funktioniert nur über eine schnelle Verbindung gut. Auf Azure bedeutet das Größen wie ND H100 v5 (acht H100 mit je 80 GB und NVLink 4.0), komplett genutzt. Versehen Sie diese Pools mit einem eigenen Taint und setzen Sie vLLMs --tensor-parallel-size auf die GPU-Anzahl des Nodes.
Hier zahlen sich vLLMs Speicherfunktionen aus: PagedAttention begrenzt die Fragmentierung des KV-Caches, Präfix-Caching nutzt gemeinsame Prompts wieder, und FP8-KV-Caches tauschen etwas Latenz gegen Kapazität. Laut Release Notes von vLLM 0.32 halbiert ein FP8-KV-Cache bei GLM-5.x auf SM100 den KV-Speicher, kostet aber 7–11 % mehr Time to First Token. Das ist ein Modell auf einer GPU-Generation; messen Sie Ihres selbst.
④ MIG-Pools für kleine Modelle
Multi-Instance-GPU teilt eine unterstützte GPU in bis zu sieben Partitionen mit eigenen Streaming-Multiprozessoren und eigenem Speicher. Auf AKS betrifft das die Familien A100 v4 und H100 v5. Für die A100 80 GB veröffentlicht Microsoft fünf einheitliche Profile, von MIG1g (sieben Slices 1g.10gb) bis MIG7g (die ganze GPU).
Drei dokumentierte Fakten prägen das Design.
- Layouts sind unveränderlich. Laut Microsoft lässt sich die Profilkonfiguration nach dem Anlegen des MIG-Pools nicht mehr ändern. Eine neue Slice-Größe heißt: neuer Pool, Migration.
- Single- oder Mixed-Strategie. Bei
Singleist jeder Slice einnvidia.com/gpu, der Name verrät die Slice-Größe nicht; nutzen Sie also einen Node-Selector. BeiMixedhat jedes Profil einen eigenen Ressourcennamen (etwanvidia.com/mig-1g.10gb). Das ist explizit, fragmentiert aber die Kapazität: Ein Pod kann laut Microsoft warten, obwohl Partitionen anderer Typen frei sind. - Keine Tensor-Parallelität über Slices. Laut NVIDIA-MIG-Leitfaden wird mit Treiber R570 Peer-to-Peer nur zwischen MIG-Instanzen derselben GPU unterstützt, NCCL-Unterstützung für MIG ist experimentell. MIG ist für Modelle, die in einen Slice passen: quantisierte 7–8B-Modelle, Embeddings, Reranker und Guard-Modelle.
Der verwaltete Weg lautet az aks nodepool add ... --enable-managed-gpu=true --gpu-mig-strategy Single --gpu-mig-profiles MIG3g und setzt Node-Image 202609.01.0 oder neuer voraus. Das ältere Flag --gpu-instance-profile funktioniert weiter, mit dem verwalteten wie mit einem eigenen Device-Plugin, lässt sich aber nicht mit --gpu-mig-profiles kombinieren.
⑤ Time-Slicing und MPS: für Entwicklung und Test, mit offenen Augen
Time-Slicing meldet eine GPU als mehrere an und lässt Pods abwechselnd rechnen. Die Dokumentation des NVIDIA-Device-Plugins ist deutlich: Für die Isolation werde nichts Besonderes getan, alle Workloads sehen denselben GPU-Speicher und teilen dieselbe Fehlerdomäne. Stürzt einer ab, stürzen alle ab. Wer zwei Time-Slicing-Replikate anfordert, bekommt nicht einmal garantiert einen proportionalen Rechenanteil.
MPS lässt Clients gleichzeitig rechnen und begrenzt jeden auf einen gleichen Anteil von Speicher und Rechenleistung. Besser, aber laut NVIDIAs MPS-Dokumentation kann ein fataler Fehler eines Clients im Mehrbenutzerbetrieb andere mitreißen, und das Device-Plugin führt MPS seit v0.15.0 als experimentell. Mit MIG lässt es sich nicht kombinieren.
Auf AKS gehört beides nicht zum verwalteten Stack: Sie legen einen Pool nur mit Treiber an (--enable-managed-gpu=false) und betreiben Device-Plugin oder GPU Operator selbst. Wir nutzen Time-Slicing für Entwicklungscluster, Notebooks und CI-Smoke-Tests, nie für Lasten mit SLA oder Mandanten, die sich nicht gegenseitig abschießen dürfen.
⑥ Autoskalierung nach Warteschlangenlänge
LLM-Server bündeln Anfragen kontinuierlich, deshalb täuscht die GPU-Auslastung: Ein Server kann ausgelastet wirken und doch Reserven haben, oder ruhig wirken, während Anfragen hinter einem vollen KV-Cache warten. Die Signale, die das Nutzererlebnis abbilden, sind vLLMs eigene Metriken: vllm:num_requests_waiting (Warteschlange), vllm:kv_cache_usage_perc (Speicherdruck) und das Histogramm vllm:time_to_first_token_seconds (was Nutzer spüren).
Der Regelkreis hat zwei Ebenen. KEDA liest die Warteschlange aus Azure Monitor Managed Prometheus und setzt die Replikatzahl; lässt sich ein Replikat nicht einplanen, ergänzt Cluster Autoscaler oder Node Auto-Provisioning (NAP) einen GPU-Node. Ein minimales ScaledObject für ein einfaches vLLM-Deployment:
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: chat-8b-vllm
spec:
  scaleTargetRef:
    name: chat-8b-vllm            # das vLLM-Deployment
  minReplicaCount: 1              # ein warmes Replikat für interaktiven Traffic
  maxReplicaCount: 6
  cooldownPeriod: 600             # GPU-Nodes kommen langsam zurück; sanft herunterskalieren
  triggers:
    - type: prometheus
      metadata:
        serverAddress: https://<ihr-amw>.<region>.prometheus.monitor.azure.com
        query: sum(vllm:num_requests_waiting{model_name="chat-8b"})
        threshold: "4"            # Ziel: wartende Anfragen je Replikat
      authenticationRef:
        name: managed-prometheus  # TriggerAuthentication mit Entra Workload Identity
Für einen LLMInferenceService bindet KServe 0.21 KEDA direkt an und erlaubt idleReplicaCount: 0 für Scale-to-Zero. Leiten Sie den Schwellenwert aus Ihrem Ziel für die Time to First Token ab, nicht aus dem Bauchgefühl.
⑦ Modellgewichte und das Kaltstart-Budget
Ein neues Replikat ist erst bereit, wenn der GPU-Node existiert, das Image gezogen ist, die Gewichte im GPU-Speicher liegen und die Kernel warm sind. Microsofts KAITO-Dokumentation nennt für die Bereitschaft der Maschine bis zu 10 Minuten und für den Workspace bis zu 20 Minuten, je nach Modellgröße. Diese Zahl gehört neben jeden Scale-to-Zero-Vorschlag.
Verkürzen Sie, wo es geht: Gewichte in Blob Storage oder als OCI-Artefakte in Azure Container Registry ablegen, auf lokalem NVMe des Nodes cachen, Images schlank halten. vLLM 0.32 hat vllm download-kernels und vllm preload --preload-autotune ergänzt, beide zielen auf die Startzeit. Und halten Sie ein warmes Replikat für alles vor, worauf ein Mensch wartet.
Was die Zahlen sagen
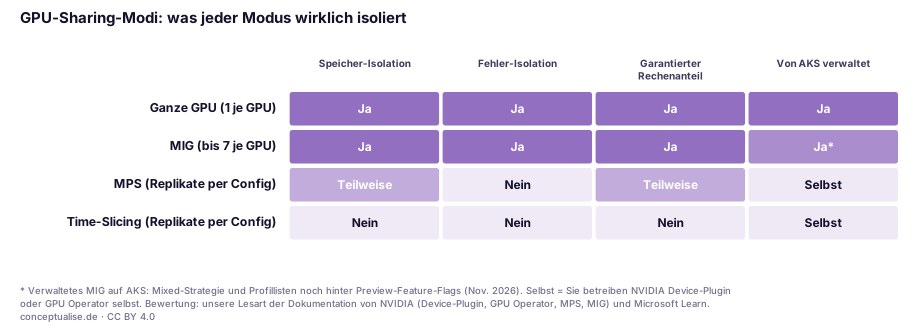
Das erste Diagramm bildet ab, was NVIDIA und Microsoft dokumentieren, bewertet von uns; ein Benchmark ist es nicht. Nur ganze GPUs und MIG isolieren Speicher und Fehler, und nur diese beiden verwaltet AKS (MIG noch als Preview). MPS ist ein halber Schritt, Time-Slicing isoliert nichts. Wer es in Produktion einsetzt, wählt Dichte vor Verfügbarkeit, ob gewollt oder nicht.
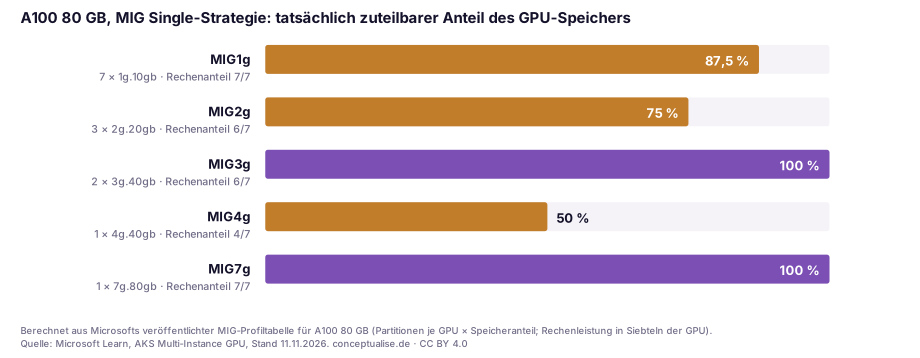
Das zweite Diagramm ist reine Arithmetik auf Microsofts Profiltabelle für die A100 80 GB: Ein einheitliches Layout lässt oft einen Teil der GPU liegen. MIG1g teilt 70 von 80 GB zu, MIG2g 60 GB bei einem Siebtel ungenutzter Rechenleistung, MIG4g nur die Hälfte des Speichers und vier Siebtel der Rechenleistung. Nur MIG3g und MIG7g teilen den gesamten Speicher zu, und MIG3g lässt trotzdem einen Rechen-Slice ungenutzt. Wählen Sie das Profil nach dem Speicherbedarf des Modells und prüfen Sie dann, was brachliegt.
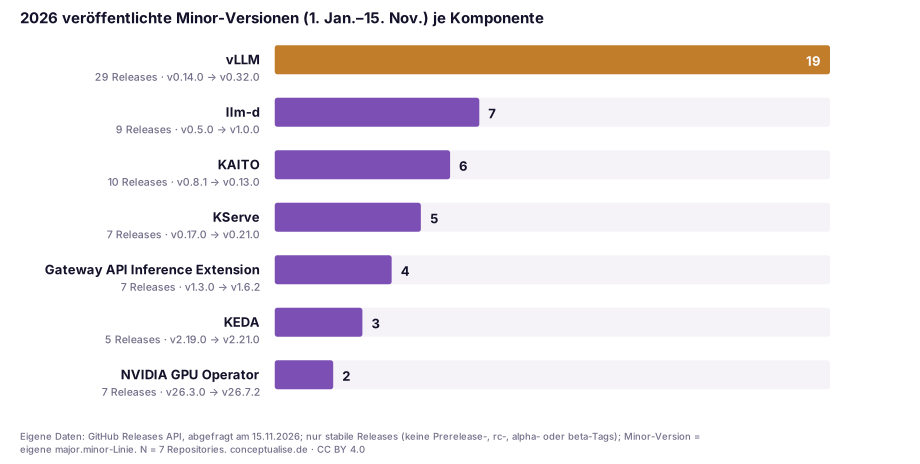
Das dritte Diagramm sind eigene Daten: Minor-Versionen, die sieben Komponenten dieses Stacks seit dem 1. Januar veröffentlicht haben, gezählt über die GitHub Releases API am 15. November 2026 (nur stabile Releases). vLLM kam auf 19, von v0.14.0 bis v0.32.0, rund alle zwei Wochen eine; die Steuerungsebene drumherum bewegt sich deutlich langsamer. Das ist ein Betriebsproblem. Allein vLLM 0.32 hat Python 3.10 gestrichen, die Standard-CORS-Origins eingeschränkt und drei Sicherheitslücken geschlossen, während das KAITO-Add-on die vLLM-Version ausliefert, die sein Release gepinnt hat. Pinnen Sie Versionen und aktualisieren Sie zuerst über einen Canary.
Aus einem aktuellen Projekt
Ein europäisches Industrieunternehmen bat uns, eine AKS-Inferenzplattform zu prüfen, die von einem Pilotmodell auf eine Handvoll Modelle gewachsen war. Auslöser war die GPU-Rechnung. Nichts daran war fahrlässig; die Plattform war schlicht für den Pilot dimensioniert.
Jedes Modell hatte eine eigene ganze A100, auch ein Embedding-Modell und ein kleines Guard-Modell, die nur einen Bruchteil des Speichers nutzten. Der einzige Pool, der GPUs teilte, nutzte Time-Slicing, weil das als Erstes funktioniert hatte. Ein GPU-Fehler in einem experimentellen Modell hatte kurz zuvor unbeteiligte Dienste mit in den Abgrund gerissen. Die Autoskalierung lief auf CPU, dem Standard des Horizontal Pod Autoscalers, also skalierten die vLLM-Replikate nie. Das Team hatte das durch Überprovisionierung ausgeglichen.
Die Änderungen waren unspektakulär. Die kleinen Modelle zogen in einen MIG-Pool mit einheitlichem MIG3g-Layout, in dem jedes Platz für seinen KV-Cache fand. Time-Slicing wanderte zurück in den Entwicklungscluster. Skalierung nach Warteschlange ersetzte die CPU-Skalierung, mit einem warmen Replikat je interaktivem Modell und nächtlichem Scale-to-Zero für reine Batch-Modelle. Das große Modell behielt seinen Pool mit ganzen GPUs. Die längste Diskussion war keine technische: Wem gehört der vLLM-Versions-Pin, nachdem mehrere Teams ihn unabhängig voneinander hochgezogen hatten?
Die Entscheidungstabelle
Das ist der Teil für den Screenshot.
| Workload | GPU-Pool | Sharing | Skalierungssignal | Min. Replikate |
|---|---|---|---|---|
| Großes Modell mit Tensor-Parallelität (z. B. 70B-Klasse in voller oder FP8-Präzision) | Ganze GPUs mit NVLink (z. B. ND H100 v5) | Keines | vllm:num_requests_waiting, Leitplanke TTFT p95 | 1 (interaktiv) |
| Kleines Instruct-Modell, interaktiv (7–8B, quantisiert) | MIG, einheitliches Profil passend zu Modell + KV-Cache | MIG-Slice | Warteschlange je Replikat | 1 |
| Embeddings, Reranker, Guard-Modelle | MIG, kleinstes passendes Profil | MIG-Slice | Warteschlange oder Anfragerate | 1 |
| Batch-Zusammenfassung, Offline-Evaluierung | Ganze GPU oder MIG, Spot wo vertretbar | wie oben | Warteschlange (oder Job-Queue) | 0 |
| Notebooks, Entwicklung, CI-Smoke-Tests von Serving-Images | Eigener Pool nur mit Treiber | Time-Slicing | Keines oder zeitgesteuert | 0 |
| Mandantenübergreifendes Serving mit SLA | Nur ganze GPU oder MIG | Nie Time-Slicing oder MPS | Warteschlange je Mandanten-Pool | 1 je Mandant |
Vier Prüffragen gehören in jedes Design-Review. Ist vLLM gepinnt und wird über einen Canary aktualisiert? Ist das MIG-Layout durch gemessenen Speicherbedarf begründet? Teilt irgendein Produktions-Workload per Time-Slicing eine Fehlerdomäne? Ist die Kaltstartzeit mit dem Product Owner abgestimmt? Den größeren Blick auf GPU-Kosten bietet unser Leitfaden zur Kostenkontrolle für GPU- und KI-Workloads auf Azure mit Reservierungen, Spot und Zeitplänen.
Governance für europäische Unternehmen
Self-Hosting auf AKS in einer EU-Region hält Prompts und Antworten in Ihrem Tenant, und für viele Organisationen im DACH-Raum ist genau das der Grund. Pflichten entfallen dadurch nicht; es ändert sich nur, wer sie trägt.
DSGVO. Self-Hosting nimmt einen Auftragsverarbeiter aus der Kette, dafür verantworten Sie nun die Aufbewahrung von Request-Logs, Prompt-Caches und Traces. Nehmen Sie Präfix- und semantische Caches in Ihr Verzeichnis von Verarbeitungstätigkeiten auf und legen Sie Löschfristen bewusst fest.
KI-Verordnung. Die Transparenzpflichten nach Artikel 50 der Verordnung (EU) 2024/1689 gelten seit dem 2. August 2026. Interagiert Ihr selbst gehostetes Modell mit Menschen oder erzeugt es synthetische Inhalte, greifen die Offenlegungspflichten unabhängig vom Hosting. Die Pflichten für Hochrisiko-KI-Systeme nach Anhang III wurden durch die Verordnung (EU) 2026/1744, in Kraft seit dem 27. Juli 2026, auf den 2. Dezember 2027 verschoben. Nutzen Sie die Zeit, um Anwendungsfälle einzustufen, nicht um das Logging der Plattform aufzuschieben.
NIS2. Für besonders wichtige und wichtige Einrichtungen fällt eine interne Inferenzplattform unter die Risikomanagementmaßnahmen nach Artikel 21, einschließlich Schwachstellenmanagement und Sicherheit der Lieferkette; in Deutschland setzt das NIS2-Umsetzungsgesetz (NIS2UmsG) diese Pflichten um. Eine Runtime mit 19 Minor-Releases in zehn Monaten, mehrere davon mit Sicherheitskorrekturen, braucht einen dokumentierten Patch-Prozess. Unsere Best Practices für Kubernetes in Produktion beschreiben die Basiskontrollen, die die GPU-Pools erben.
Für DORA-regulierte Finanzunternehmen kann Self-Hosting die Konzentration auf einen einzelnen Modell-API-Anbieter verringern. Die GPUs kommen aber weiterhin aus einer Cloud-Region. Dokumentieren Sie die Ausweichlösung.
Ein pragmatischer Einführungspfad
- Wochen 1–2: messen, bevor Sie schneiden. Erfassen Sie je Modell den GPU-Speicher bei Ziel-Kontextlänge und -Parallelität, Tokens pro Sekunde und Time to First Token auf einer ganzen GPU. Ohne diese Zahlen ist jedes MIG-Layout geraten, und ändern lässt es sich nicht im laufenden Pool.
- Wochen 3–4: Pools trennen. Legen Sie einen Pool mit ganzen GPUs für große Modelle und einen verwalteten MIG-Pool mit einem einheitlichen Profil für kleine an. Verlegen Sie Time-Slicing in einen eigenen Entwicklungspool nur mit Treiber. Alles bekommt Taints.
- Monat 2: Router und Skalierung nach Warteschlange einführen. Setzen Sie die Gateway API Inference Extension ein, über KServe
LLMInferenceServiceoder eigenständig. Ersetzen Sie CPU- oder auslastungsbasierte Skalierung durch KEDA aufvllm:num_requests_waiting. Aktivieren Sie Cluster Autoscaler oder NAP für die GPU-Pools. - Monat 2–3: den Kaltstart verkürzen. Legen Sie die Gewichte neben den Cluster, cachen Sie sie auf lokalen Node-Disks, messen Sie die Bereitschaft Ende zu Ende von „Pod wartet“ bis „erstes Token“ und stimmen Sie die Mindestreplikate auf Basis dieser Zahl mit den Product Ownern ab.
- Monat 3: die Runtime industrialisieren. Pinnen Sie vLLM-, KServe- und KAITO-Versionen in Git, aktualisieren Sie über einen Canary mit Evaluierungs-Gate und abonnieren Sie im Plattformteam die vLLM-Sicherheitshinweise. Unsere Referenzarchitektur für Enterprise-Agentenplattformen zeigt, wo diese Inferenzschicht in der Gesamtplattform sitzt.
Das Fazit
vLLM auf AKS zu betreiben ist kein Forschungsprojekt mehr. AKS verwaltet GPU-Treiber und MIG-Partitionen, KServe und llm-d bringen inferenzbewusstes Routing und Skalierung, und mit KAITO läuft das erste Modell an einem Nachmittag. Die Schwierigkeit liegt nicht mehr darin, dass es funktioniert, sondern darin, danach kein Geld zu verbrennen.
Unsere Einschätzung: ganze GPUs für Modelle, die sie brauchen, MIG für alles, was in einen Slice passt, kein Time-Slicing in Produktion. Skalieren Sie nach Warteschlange und halten Sie überall dort ein warmes Replikat vor, wo ein Mensch wartet. Behandeln Sie vLLM als schnelllebige, sicherheitsrelevante Abhängigkeit. Wer diese vier Punkte richtig setzt, macht aus der GPU-Rechnung eine Designentscheidung statt einer Überraschung.
Wenn Sie einen zweiten Blick auf Ihre GPU-Plattform wünschen: Unser Cloud-Architektur-Team führt ein AKS-Inferenz-Review mit festem Umfang durch. Wir vermessen Ihre Modelle, schlagen Pool- und MIG-Layout vor und hinterlassen Ihnen die Skalierungskonfiguration und die ausgefüllte Entscheidungstabelle für Ihre Umgebung.
FAQ
Sollten wir vLLM auf AKS mit KServe, KAITO oder einfachen Deployments betreiben?
KAITO ist der schnellste Weg zum laufenden Endpunkt, das AKS-Add-on hinkt laut Microsoft aber typischerweise ein Release hinter dem Upstream-Projekt her. KServes LLMInferenceService passt zu Plattformteams mit mehreren Modellen: inferenzbewusstes Routing, Canary-Rollouts und seit KServe 0.21 direkte KEDA-Skalierung. Einfache Deployments genügen für ein oder zwei Modelle.
Was unterscheidet MIG, Time-Slicing und MPS auf AKS?
MIG teilt eine A100 oder H100 in bis zu sieben Hardware-Partitionen mit dokumentierter Speicher- und Fehlerisolation. Time-Slicing lässt Pods abwechselnd auf einer GPU rechnen, ohne jede Isolation: Stürzt ein Workload ab, trifft es alle. MPS ergänzt Speicher- und Rechenlimits je Client, gilt im NVIDIA-Device-Plugin aber weiterhin als experimentell. MIG verwaltet AKS selbst, Time-Slicing und MPS erfordern ein eigenes Device-Plugin oder den GPU Operator.
Welche Metrik sollte die Autoskalierung von vLLM auslösen?
Die Warteschlangenlänge: vLLMs Metrik vllm:num_requests_waiting, mit vllm:kv_cache_usage_perc und der Time to First Token als Leitplanken. GPU-Auslastung täuscht bei Continuous Batching. Auf AKS liest KEDA die Metrik aus Azure Monitor Managed Prometheus, Cluster Autoscaler oder Node Auto-Provisioning ergänzen GPU-Nodes für wartende Pods.
Können wir vLLM auf AKS auf null skalieren?
Technisch ja: KServe 0.21 erlaubt idleReplicaCount: 0 mit KEDA. Die erste Anfrage wartet dann aber auf GPU-Node, Image-Pull und Modell-Laden, und Microsofts KAITO-Dokumentation nennt bis zu 20 Minuten, bis ein Workspace bereit ist. Wir halten für interaktiven Traffic ein warmes Replikat vor und skalieren nur Batch- und Nachtlasten auf null.
Lässt sich Tensor-Parallelität über MIG-Slices verteilen?
Davon raten wir ab. Laut NVIDIA-MIG-Leitfaden wird mit Treiber R570 Peer-to-Peer nur zwischen MIG-Instanzen derselben GPU unterstützt, und die NCCL-Unterstützung für MIG ist experimentell. Tensor-parallele Modelle gehören auf ganze GPUs mit NVLink, etwa ND H100 v5; MIG bleibt Modellen vorbehalten, die in einen Slice passen.
Ändert Self-Hosting auf AKS unsere Pflichten aus KI-Verordnung oder NIS2?
Es ändert, wohin die Daten fließen, nicht ob die Regeln gelten. Die Transparenzpflichten nach Artikel 50 der KI-Verordnung gelten seit dem 2. August 2026; die Pflichten für Hochrisiko-Systeme nach Anhang III wurden durch die Verordnung (EU) 2026/1744 auf den 2. Dezember 2027 verschoben. Für NIS2-Einrichtungen fällt die Inferenzplattform unter die Risikomanagementmaßnahmen nach Artikel 21, einschließlich des Patchens eines schnell wechselnden Serving-Stacks.
Quellen
Alle Quellen geprüft am 15. November 2026. Release-Daten und Versionen stammen von den GitHub-Release-Seiten der Projekte; die Zählung der Release-Kadenz ist eine eigene Abfrage der GitHub Releases API vom selben Tag.
Stufe A: Primärdokumentation, Release Notes und Rechtstexte
- Microsoft Learn, Create an AKS-managed GPU node pool (Stand 11.11.2026): https://learn.microsoft.com/en-us/azure/aks/aks-managed-gpu-nodes
- Microsoft Learn, Multi-instance GPU partitioning strategies in AKS: https://learn.microsoft.com/en-us/azure/aks/multi-instance-gpu-overview
- Microsoft Learn, Create a single strategy multi-instance GPU node pool in AKS: https://learn.microsoft.com/en-us/azure/aks/gpu-multi-instance
- Microsoft Learn, Use GPUs on AKS (selbstverwaltetes Setup): https://learn.microsoft.com/en-us/azure/aks/use-nvidia-gpu
- Microsoft Learn, AI toolchain operator add-on (KAITO) auf AKS: https://learn.microsoft.com/en-us/azure/aks/ai-toolchain-operator
- Microsoft Learn, ND H100 v5 size series (8 × H100 80 GB, NVLink 4.0, lokales NVMe): https://learn.microsoft.com/en-us/azure/virtual-machines/sizes/gpu-accelerated/ndh100v5-series
- KEDA 2.21, Prometheus-Scaler (Azure Workload Identity für Azure Monitor Managed Prometheus): https://keda.sh/docs/2.21/scalers/prometheus/
- NVIDIA, Kubernetes Device Plugin README (Time-Slicing und MPS): https://github.com/NVIDIA/k8s-device-plugin
- NVIDIA GPU Operator, GPU Sharing (Time-Slicing): https://docs.nvidia.com/datacenter/cloud-native/gpu-operator/latest/gpu-sharing.html
- NVIDIA, MIG User Guide: unterstützte Profile, Konzepte und Deployment Considerations: https://docs.nvidia.com/datacenter/tesla/mig-user-guide/
- NVIDIA, Multi-Process Service, Architektur: https://docs.nvidia.com/deploy/mps/architecture.html
- vLLM v0.32.0 Release Notes (18.10.2026): https://github.com/vllm-project/vllm/releases/tag/v0.32.0
- vLLM, Metrics-Design-Dokumentation: https://docs.vllm.ai/en/latest/design/metrics.html
- KServe v0.21.0 Release Notes (25.09.2026): https://github.com/kserve/kserve/releases/tag/v0.21.0
- KServe, LLMInferenceService Overview: https://kserve.github.io/website/docs/model-serving/generative-inference/llmisvc/llmisvc-overview
- KAITO v0.13.0 Release Notes (24.10.2026): https://github.com/kaito-project/kaito/releases/tag/v0.13.0
- llm-d v1.0.0 Release Notes (20.10.2026): https://github.com/llm-d/llm-d/releases/tag/v1.0.0
- Gateway API Inference Extension, Releases: https://github.com/kubernetes-sigs/gateway-api-inference-extension/releases
- Kubernetes Blog, v1.34 DRA Updates (DRA-Kern GA): https://kubernetes.io/blog/2025/09/01/kubernetes-v1-34-dra-updates/
- Verordnung (EU) 2024/1689 (KI-Verordnung), Artikel 50: https://eur-lex.europa.eu/eli/reg/2024/1689/oj/deu
- Richtlinie (EU) 2022/2555 (NIS2), Artikel 21: https://eur-lex.europa.eu/eli/dir/2022/2555/oj/deu
Stufe B: eigene Daten und Analyse
- conceptualise.de, Zählung der Release-Kadenz über die GitHub Releases API für vllm-project/vllm, llm-d/llm-d, kaito-project/kaito, kserve/kserve, kubernetes-sigs/gateway-api-inference-extension, kedacore/keda und NVIDIA/gpu-operator, 1.1. bis 15.11.2026 (Methode und Rohwerte in der CSV): https://www.conceptualise.de/blog/kubernetes-ai-inference-vllm-kserve-aks/data.csv
- conceptualise.de, MIG-Zuteilungsrechnung auf Basis von Microsofts Profiltabelle für A100 80 GB (dieselbe CSV)
Stufe C: Hersteller, richtungsweisend
- vLLM-Pull-Request-Benchmarks aus den Release Notes v0.32.0 (ein Modell, eine GPU-Generation; nur richtungsweisend)
Themen