GraphRAG vs. RAG vs. agentisches Retrieval: Benchmarks
GraphRAG, Vektor-RAG und agentisches Retrieval im Vergleich: was sechs veröffentlichte Benchmarks zeigen und wie Sie es mit Ihren eigenen Daten testen.
Am 24. April 2024 veröffentlichte Microsoft Research das GraphRAG-Paper. Die Kernaussage war kaum zu überhören: Bei korpusweiten „Sensemaking"-Fragen schlugen Antworten auf Basis eines LLM-generierten Wissensgraphen klassisches Vektor-RAG in 72 bis 83 % der direkten Vergleiche bei der Vollständigkeit. Binnen Monaten hatte jeder Anbieter von Vektordatenbanken, Graphdatenbanken und KI-Plattformen eine GraphRAG-Geschichte. 2026 lautete die Frage unserer Kunden dann einfacher: Bauen wir unser Retrieval auf einen Graphen um, oder lassen wir einen Agenten suchen?
Achtzehn Monate unabhängiger Benchmarks erzählen eine interessantere Geschichte als die Launch-Folien. Graphbasiertes Retrieval gewinnt bei manchen Fragetypen deutlich und verliert bei anderen ebenso deutlich. Agentisches Retrieval steigert die Genauigkeit bei schweren Fragen, aber nur so weit, wie die darunterliegende Suche es zulässt. Und manche der meistzitierten Win-Rates messen eher den Richter als das System. Dieser Beitrag richtet sich an alle, die eine Retrieval-Architektur auswählen und finanzieren müssen: CTOs, Verantwortliche für KI-Plattformen und Enterprise-Architekten. Wir fassen die veröffentlichte Evidenz zusammen, belegen jede Zahl und geben Ihnen eine reproduzierbare Methode, um denselben Vergleich mit Ihren eigenen Dokumenten durchzuführen. Eigene Messwerte veröffentlichen wir hier bewusst nicht. Dem Benchmark eines Beratungshauses über den eigenen Lieblings-Stack sollte niemand trauen, auch unserem nicht.
TL;DR / Das Wichtigste in Kürze
- Keine Architektur gewinnt überall. In GraphRAG-Bench und bei Han et al. hält gut abgestimmtes Vektor-RAG bei einfachen Faktenfragen mit GraphRAG mit oder schlägt es. Graphverfahren gewinnen bei Multi-Hop-, zeitlichen und korpusweiten Zusammenfassungsfragen.
- Der Fragetyp sagt den Sieger besser voraus als Hersteller oder Bibliothek. Bei zeitlichen Fragen in MultiHop-RAG erreichte die lokale GraphRAG-Suche 49,1 %, Vektor-RAG 25,7 %. Bei einfachen Schlussfolgerungsfragen lag Vektor-RAG mit 94,9 % zu 92,0 % vorn.
- Hybride schlagen Puristen. Die Kombination von Vektor- und Graph-Retrieval erreichte auf MultiHop-RAG 77,6 %, das beste Einzelverfahren 71,2 %. Routing pro Frage kam auf 72,3 %.
- Agentisches Retrieval verstärkt den Retriever, es ersetzt ihn nicht. In BrowseComp-Plus erreichte GPT-5 mit BM25 55,9 % und mit einem starken Embedding-Retriever 70,1 %, bei rund 22 Suchaufrufen pro Frage.
- Misstrauen Sie Win-Rates. Eine Evaluationsstudie fand einen LLM-Richter, der identischen Systemen ein Verhältnis von 90 zu 10 bescheinigte. Bestehen Sie auf Referenzantworten, vertauschter Reihenfolge und wiederholten Durchläufen, bevor Sie einen Umbau finanzieren.

Download: Editierbare draw.io-Datei · In diagrams.net öffnen · Diagrammdaten (CSV)
Warum die Entscheidung jetzt ansteht
Seit dem GraphRAG-Paper haben sich drei Dinge verändert.
Erstens sind die Werkzeuge gereift und in Plattformen gewandert, für die Sie ohnehin bezahlen. Microsofts Open-Source-Bibliothek graphrag erreichte am 8. Oktober 2026 Version 3.3.0. Amazon Bedrock Knowledge Bases bietet GraphRAG mit Neptune Analytics seit dem 7. März 2025 allgemein verfügbar an. Azure AI Search hat agentisches Retrieval mit der REST-API-Version 2026-04-01 allgemein verfügbar gemacht; es bildet inzwischen die Grundlage von Foundry IQ, Microsofts verwalteter Wissensschicht für Agenten. Die Wahl ist damit eine Konfigurationsentscheidung innerhalb einer Plattform, oft getroffen von dem, der die Produktseite zuerst liest.
Zweitens liegt unabhängige Evidenz vor, und sie ist gemischt. Die Autoren von GraphRAG-Bench gehen von einem ernüchternden Befund der bisherigen Forschung aus: GraphRAG „often fails to outperform vanilla RAG on many NLP tasks". Ihre eigenen Ergebnisse zeigen, wie die anderer Studien, dennoch konsistente Graphvorteile beim Schlussfolgern und Zusammenfassen. Beides stimmt, nur für unterschiedliche Fragen.
Drittens ist die Bewertung selbst zur Schwachstelle geworden. Zeng et al. zeigten 2025, dass das in mehreren GraphRAG-Papern verwendete LLM-as-a-Judge-Protokoll einem von zwei identischen Systemen eine Win-Rate von 90 % zusprach. Nach Korrektur von Positions-, Längen- und Durchlauf-Bias fielen die GraphRAG-Vorteile „much more moderate than reported previously" aus. Wenn Ihr Business Case auf einem Win-Rate-Diagramm beruht, prüfen Sie, wie es entstanden ist.
Retrieval-Architektur ist heute eine Portfolio-Entscheidung, getroffen pro Fragetyp und auf Basis eigener Messungen. Unser Leitfaden für Enterprise-RAG-Pipelines behandelt die Vektor-Basis im Detail. Hier geht es darum, wann sich mehr lohnt.
Die drei Pipelines im direkten Vergleich
Das Titeldiagramm stellt alle drei Ansätze über denselben Korpus, dieselben Fragen und dasselbe Antwortmodell. Nur so lassen sie sich fair vergleichen, und genau so sind die Benchmarks weiter unten aufgebaut. Die nummerierten Abschnitte entsprechen den Markierungen im Diagramm.
① Vektor-RAG: Chunks, Embeddings und hybride Suche
Bei der Indexierung werden Dokumente in Chunks von einigen hundert Tokens zerlegt, jeder Chunk wird eingebettet, die Vektoren landen in einem Index. In ernsthaften Unternehmensumgebungen ist dieser Index hybrid: Vektorähnlichkeit plus Keyword-Suche (BM25), mit Berechtigungsfeldern, damit Treffer auf das beschränkt werden, was der Nutzer sehen darf. Zur Abfragezeit wird die Frage eingebettet, die Top-k-Chunks werden abgerufen, ein Reranker sortiert sie neu, und das Modell antwortet aus den Chunks mit Quellenangaben.
Die Stärken sind unspektakulär und wertvoll: günstige Indexierung, inkrementelle Updates, niedrige Latenz und einfache Fehlersuche, weil Sie genau sehen, welche Chunks abgerufen wurden. Die Schwäche ist strukturell. Jeder Chunk wird für sich bewertet. Braucht die Antwort Fakten aus fünf Dokumenten, die einander nie erwähnen, oder ein Thema, das sich durch tausend Tickets zieht, kann Top-k-Ähnlichkeit das nicht zusammensetzen.
Zwei Details wiegen schwerer, als die meisten Teams erwarten. Reranking ist Pflicht: In GraphRAG-Bench verbesserte es Vektor-RAG in sieben von acht Aufgabenspalten. Ebenso wichtig ist die Qualität des Retrievers, wie die BrowseComp-Plus-Ergebnisse unten zeigen.
② GraphRAG: ein LLM-gebauter Wissensgraph plus Community-Zusammenfassungen
„GraphRAG" bezeichnet inzwischen eine ganze Familie von Verfahren. Microsofts Referenzimplementierung funktioniert so: Bei der Indexierung liest ein LLM jeden Chunk und extrahiert Entitäten, Beziehungen und optional Aussagen. Daraus entsteht ein Wissensgraph. Ein Community-Erkennungsverfahren (im Original-Paper Leiden) gliedert den Graphen in eine Hierarchie von Communities, und das LLM schreibt für jede Community auf jeder Ebene eine Zusammenfassung. Zur Abfragezeit gibt es mehrere Modi:
- Lokale Suche startet bei den Entitäten, die zur Frage passen, und zieht deren Nachbarn, Beziehungen und Quell-Chunks hinzu. Sie eignet sich für Fragen zu konkreten Dingen und ihren Verbindungen.
- Globale Suche aggregiert per Map-Reduce über Community-Zusammenfassungen, um korpusweite Fragen zu beantworten, etwa „Was sind die wichtigsten Risikothemen in diesen Verträgen?". Das ist der Modus, den das Original-Paper untersucht hat, und der teure.
- DRIFT-Suche kombiniert beides und wird in der Dokumentation der Bibliothek neben lokaler und globaler Suche geführt.
Andere Familienmitglieder setzen andere Schwerpunkte. LightRAG sucht über Schlüsselwörter zu Entitäten und Beziehungen. HippoRAG 2 kombiniert einen Graphen aus Entitäten und Passagen mit Personalized PageRank und wurde auf der ICML 2025 veröffentlicht. Microsofts LazyGraphRAG verlagert fast die gesamte LLM-Arbeit in die Abfragezeit, sodass die Indexierung etwa so viel kostet wie bei Vektor-RAG. Achtung, Namensfalle: „Fast-GraphRAG" ist eine Open-Source-Bibliothek, die in GraphRAG-Bench bewertet wurde, während Microsoft eine günstigere, NLP-basierte Indexierungsmethode in der eigenen Bibliothek „FastGraphRAG" nennt. Prüfen Sie, was ein Paper meint, bevor Sie Zahlen vergleichen.
Die Kosten entstehen bei der Indexierung. Microsofts Dokumentation schätzt, dass allein die Graphextraktion rund 75 % der Indexierungskosten ausmacht, weil ein generatives Modell den gesamten Korpus liest. Das hat datenschutzrechtliche Folgen, auf die wir im Governance-Abschnitt eingehen.
③ Agentisches Retrieval: Das Modell steuert die Suche
Agentisches Retrieval baut keinen neuen Index. Es behandelt die vorhandenen Indizes, ob Vektor, Keyword, Graph, SQL oder Web, als Werkzeuge. Ein Planer-LLM zerlegt die Frage in Teilfragen, führt sie parallel gegen die passenden Quellen aus, sortiert und führt die Ergebnisse zusammen und entscheidet dann, ob die Evidenz reicht. Reicht sie nicht, plant es neu. Das Ergebnis sind Grounding-Daten mit Quellenangaben und, in guten Implementierungen, ein Aktivitätsprotokoll, das zeigt, welche Abfrage wohin ging.
Das ist der Ansatz hinter „Deep Research"-Agenten, und er ist inzwischen eine Produktfunktion. In Azure AI Search orchestriert eine Knowledge Base die Pipeline über eine oder mehrere Knowledge Sources. Microsofts Dokumentation räumt offen ein, dass dies „adds latency compared to a single-query pipeline", und die Abrechnung wechselt von pro Abfrage zu pro Token. Die allgemein verfügbare API-Version 2026-04-01 deckt minimales, extraktives Retrieval ab. Bei minimalem Reasoning-Aufwand entfällt der LLM-Planungsschritt. LLM-Abfrageplanung, Antwortsynthese und höherer Reasoning-Aufwand liegen in der API-Version 2026-08-01-preview. Das GA-Produkt ist heute also vor allem paralleles Retrieval über mehrere Quellen; die vollständig agentische Schleife ist noch Preview.
Die Stärke des agentischen Retrievals: Es deckt komplexe, mehrteilige Fragen ab, ohne dass etwas neu gebaut werden muss. Die Schwächen: Kosten und Latenz schwanken pro Frage, und es entsteht eine neue Fehlerklasse, denn der Planer kann selbstbewusst an der falschen Stelle suchen. Unser Beitrag RAG reicht nicht ordnet ein, wo Agenten in die übergeordnete Wissensarchitektur passen.
④ Das Evaluations-Harness: unsere Methode
Benchmarks zeigen, was möglich ist, nicht, was mit Ihren Verträgen, Tickets und Richtlinien passiert. Das vierte Element im Diagramm halten wir für unverzichtbar: ein Harness, das jeden Kandidaten mit demselben Korpus, denselben Fragen und demselben Antwortmodell testet. So gehen wir vor, und wir veröffentlichen die Methode, damit Sie sie ohne uns anwenden können.
- Echte Fragen sammeln. Nehmen Sie 200 bis 400 Fragen aus Suchprotokollen, Helpdesk-Tickets oder Nutzerinterviews, nicht aus einem LLM-Brainstorming. Synthetische Fragen taugen als Ergänzung, nie als Basis.
- Jede Frage nach Typ markieren. Fünf Kategorien: einfacher Fakt, Multi-Hop, zeitlich, korpusweit (Zusammenfassung oder Thema) und unbeantwortbar. Die Benchmarks unten zeigen, dass der Sieger je nach Typ wechselt; ein Gesamtdurchschnitt verdeckt die Entscheidung.
- Referenzantworten als Kernaussagen formulieren. Notieren Sie pro Frage die drei bis sieben Aussagen, die eine korrekte Antwort enthalten muss, mit ihren Quelldokumenten. Aussagen-Recall ist robuster als die Bewertung ganzer Antworten.
- Alles außer dem Retrieval festhalten. Gleicher Korpus-Snapshot, gleiches Antwortmodell und gleiche Temperatur, gleiche Prompt-Vorlage und, wo möglich, gleiches Token-Budget für den Kontext.
- Fünf Größen messen. Aussagen-Recall und Quellenpräzision (stützt die zitierte Passage die Aussage?), Kosten pro 1.000 Fragen inklusive anteiliger Indexierungskosten, p95-Latenz und Aktualität: Wie lange nach einer Dokumentänderung erscheint die richtige Antwort?
- Fair bewerten. Wenn ein paarweiser LLM-Richter nötig ist: beide Reihenfolgen, mindestens drei Durchläufe, Unentschieden getrennt ausweisen. 10 % der Urteile stichprobenartig von Hand prüfen.
- Berechtigungen testen. Stellen Sie Fragen, deren Antworten in Dokumenten liegen, die der Testnutzer nicht sehen darf. Jedes Leck ist ein K.-o.-Kriterium, unabhängig von der Genauigkeit.
Das Harness selbst ist solides Engineering. Unser Beitrag zum Evaluations-Harness für KI-Agenten behandelt Golden Datasets, Tracing und CI-Gates. Die Schleife sieht so aus:
Was die Benchmarks zeigen
Wir haben Benchmarks ausgewählt, die mindestens zwei der drei Ansätze auf gemeinsamen Daten vergleichen und ihre Tabellen veröffentlichen. Alle Zahlen sind wie veröffentlicht wiedergegeben, keine stammt aus eigenen Läufen. Die Datendatei führt jeden Wert mit Quelle.
| Benchmark | Durchgeführt von | Was verglichen wird | Bewertung | Wichtigste Einschränkung |
|---|---|---|---|---|
| GraphRAG-Paper (Edge et al., 2024/2025) | Microsoft Research | GraphRAG global vs. Vektor-RAG, Korpora mit ca. 1 Mio. und 1,7 Mio. Tokens | Paarweise LLM-Win-Rates, plus Aussagenzählung | Eigene Methode der Autoren; nur korpusweite Fragen |
| RAG vs. GraphRAG (Han et al., 2025/2026) | Unabhängig, akademisch | Vektor-RAG, KG-GraphRAG, Microsoft GraphRAG lokal/global, Hybride | Genauigkeit und F1 gegen Referenzantworten | Offene Modelle (Llama 3.1); öffentliche QA-Datensätze |
| GraphRAG-Bench (Xiang et al., 2025/2026) | Unabhängig, akademisch | Vektor-RAG und sieben Graphverfahren, Roman- und Medizin-Korpus | Genauigkeit nach Aufgabentyp | Ein Generator (GPT-4o-mini) |
| Unverzerrte GraphRAG-Evaluierung (Zeng et al., 2025) | Unabhängig, akademisch | Microsoft GraphRAG, LightRAG, Fast-GraphRAG, naives RAG | Bias-korrigierte paarweise Bewertung | Schwerpunkt ist die Bewertungsmethode |
| BrowseComp-Plus (Chen et al., 2025) | Unabhängig, akademisch | Suchagenten × Retriever auf festem Korpus mit 100.195 Dokumenten | Genauigkeit gegen Referenz, Suchaufrufe | Web-Rechercheaufgaben, keine Unternehmensdokumente |
| LazyGraphRAG / BenchmarkQED (2024–2025) | Microsoft Research | LazyGraphRAG vs. Vektor-RAG und GraphRAG | LLM-Win-Rates | Hersteller bewertet eigene Methode |
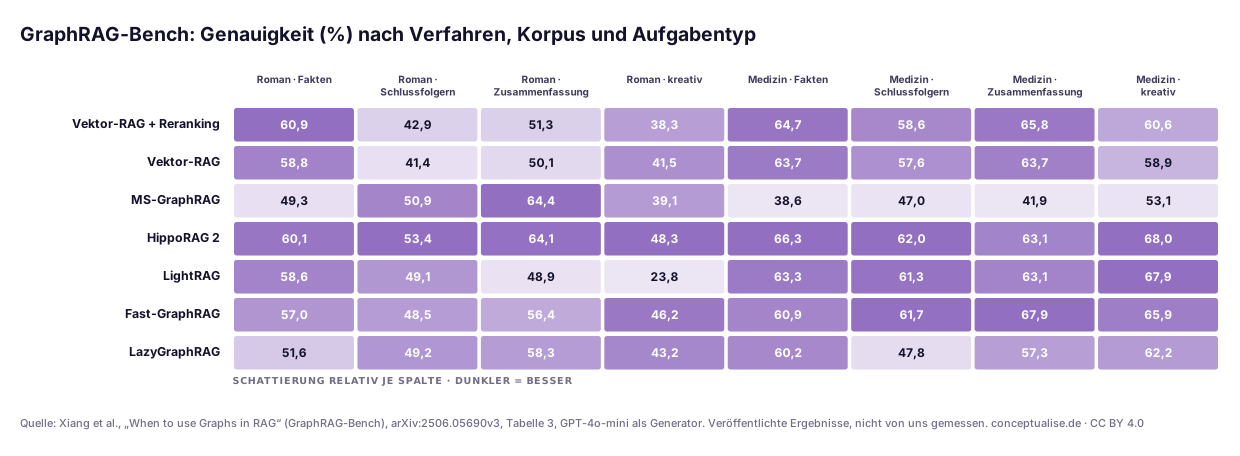
GraphRAG-Bench ist für Architekten die nützlichste Einzeltabelle, weil sie die Ergebnisse nach Aufgabentyp aufschlüsselt. Lesen Sie sie spaltenweise, nicht zeilenweise. Beim Faktenabruf liegt Vektor-RAG mit Reranker auf beiden Korpora an oder nahe der Spitze: 60,9 % auf dem Roman- und 64,7 % auf dem Medizin-Korpus. Microsofts GraphRAG fällt bei medizinischen Fakten mit 38,6 % deutlich ab. Beim komplexen Schlussfolgern und bei Zusammenfassungen kippt das Bild. Auf dem Roman-Korpus erreicht GraphRAG bei Zusammenfassungen 64,4 % gegenüber 51,3 % für Vektor-RAG, und HippoRAG 2 führt beim Schlussfolgern mit 53,4 %. HippoRAG 2 ist insgesamt das konsistenteste Graphverfahren, und sein Prompt ist ähnlich groß wie der von Vektor-RAG, was für die Kosten zählt. Die Prompt-Längen-Analyse der Autoren zeigt, dass der globale Modus von Microsoft GraphRAG die Prompts um Größenordnungen aufbläht. Absolute Token-Zahlen nennen wir nicht, weil Text und Tabellen des Papers hier voneinander abweichen.
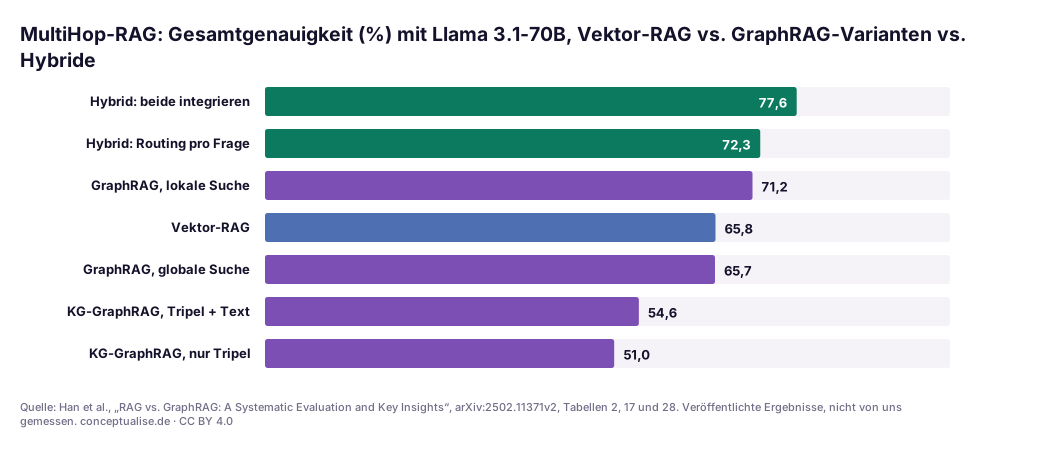
Han et al. lieferten den saubersten direkten Vergleich auf einem Multi-Hop-Benchmark mit Referenzantworten. Drei Ergebnisse stechen heraus. Erstens schlug die lokale Suche von Microsoft GraphRAG Vektor-RAG insgesamt mit 71,2 % zu 65,8 %. Die globale Suche, die das Original-Paper beworben hatte, lag mit 65,7 % gleichauf mit Vektor-RAG. Zweitens war das Retrieval reiner Wissensgraph-Tripel mit 51,0 % deutlich schlechter. Der zusätzliche Quelltext half auf 54,6 %, aber nicht genug. Ein Graph, der den Originaltext verwirft, verliert Information. Drittens gewannen die Hybride. Routing jeder Frage zum besseren Verfahren erreichte 72,3 %, die Integration beider Retrieval-Ergebnisse 77,6 %.
Die Aufschlüsselung nach Fragetyp ist die entscheidungsrelevanteste Zahl dieses Beitrags. Bei zeitlichen Fragen erreichte die lokale GraphRAG-Suche 49,1 % gegenüber 25,7 % für Vektor-RAG, bei Vergleichsfragen 60,2 % zu 56,3 %. Bei Schlussfolgerungsfragen lag Vektor-RAG mit 94,9 % zu 92,0 % vorn, bei unbeantwortbaren („Null"-)Fragen mit 91,4 % zu 88,7 %. Auf den allgemeinen QA-Datensätzen drehte sich die Reihenfolge um: Bei Natural Questions kam Vektor-RAG auf einen F1-Wert von 68,2 gegenüber 65,4 für die lokale GraphRAG-Suche, bei NovelQA auf 61,4 % gegenüber 57,3 % Genauigkeit. Wenn der Großteil Ihrer Anfragen Nachschlagefragen sind, hilft ein Graph nicht.
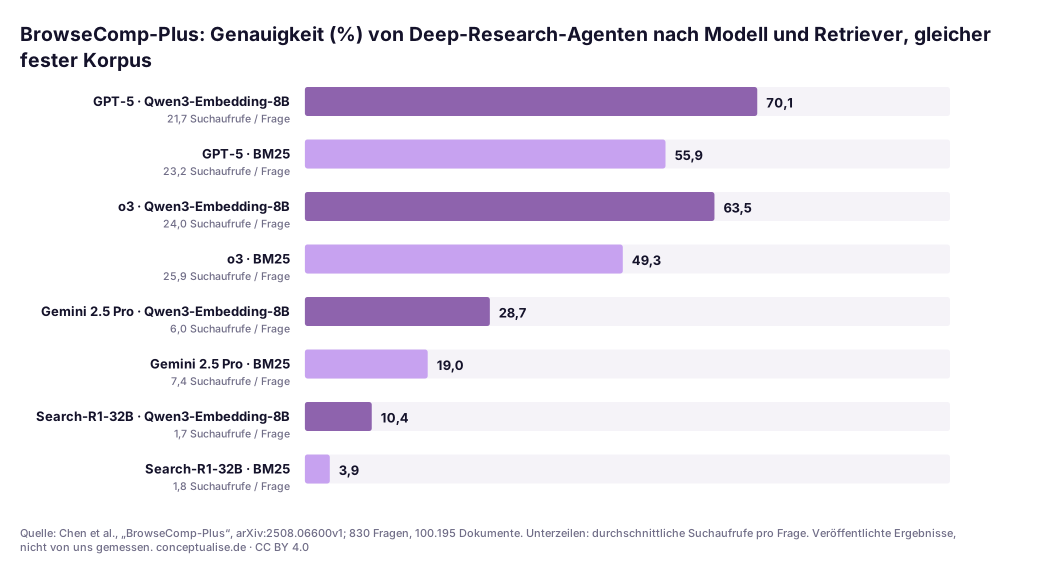
Für agentisches Retrieval ist BrowseComp-Plus die beste kontrollierte Evidenz, die wir gefunden haben. Der Korpus ist auf 100.195 Dokumente und 830 schwere Rechercheaufgaben fixiert, sodass Modell und Retriever unabhängig variiert werden können. Zwei Lesarten zählen. Der Retriever ist selbst bei einem starken Agenten enorm wichtig: GPT-5 stieg von 55,9 % mit BM25 auf 70,1 % mit dem Retriever Qwen3-Embedding-8B, o3 von 49,3 % auf 63,5 %. Agentisches Retrieval ist ein Multiplikator auf Ihren Index, kein Ersatz dafür. Und die agentische Schleife ist teuer. Die beiden stärksten Agenten setzten rund 22 bis 26 Suchaufrufe pro Frage ab; schwächere Agenten suchten weniger und schnitten deutlich schlechter ab. Ältere Evidenz weist in dieselbe Richtung: IRCoT, das Retrieval mit Chain-of-Thought verschränkt, verbesserte das Retrieval um bis zu 21 Punkte und die QA-Leistung um bis zu 15 Punkte auf vier Multi-Hop-Datensätzen. Auf Googles FRAMES-Benchmark hob eine mehrstufige Retrieval-Pipeline die Genauigkeit von 0,41 ohne Retrieval auf 0,66.
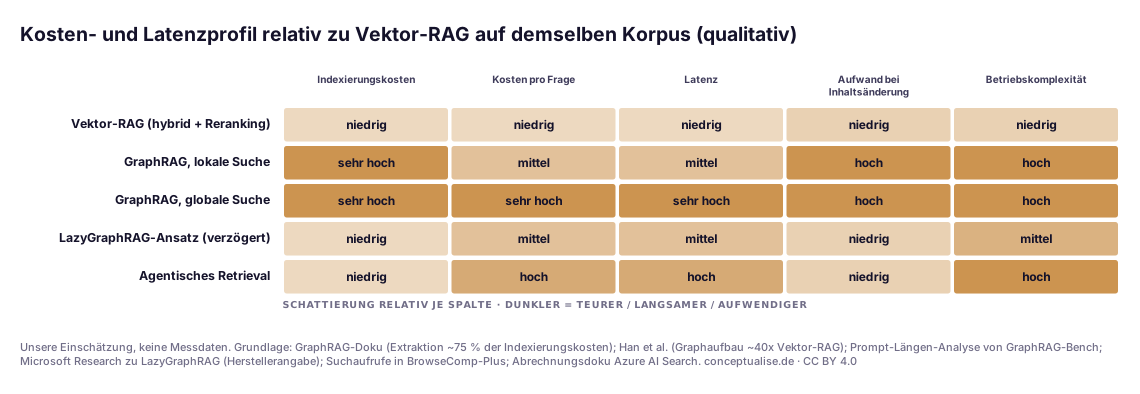
Das letzte Diagramm ist unsere Einschätzung und als solche gekennzeichnet. Es stützt sich auf die genannten Quellen. Die Graphextraktion macht rund 75 % der GraphRAG-Indexierungskosten aus. Han et al. berichten für MultiHop-RAG eine etwa 40-mal längere Aufbauzeit für den Graphen als für den Vektorindex. GraphRAG-Bench dokumentiert das Prompt-Wachstum. Agenten setzen viele Suchaufrufe ab. Microsoft gibt an, dass LazyGraphRAG zu den Kosten von Vektor-RAG indexiert und die Qualität der globalen GraphRAG-Suche bei mehr als 700-mal niedrigeren Abfragekosten erreicht. Diese Zahl stammt von einem Hersteller, der seine eigene Methode misst. Dasselbe gilt für Microsofts BenchmarkQED-Studie, in der LazyGraphRAG alle 96 Vergleiche gegen konkurrierende Konfigurationen gewann, darunter Vektor-RAG mit Kontextfenstern von 8.000 und 120.000 Tokens sowie die Suchmodi von GraphRAG selbst. Wir halten die Idee des verzögerten Graphen für vielversprechend, die Zahlen aber für unbelegt, bis jemand anderes sie reproduziert.
Bleiben die ursprünglichen GraphRAG-Win-Rates: 72 bis 83 % bei der Vollständigkeit und 62 bis 82 % bei der Vielfalt, bewertet von einem LLM auf korpusweiten Fragen. Dasselbe Paper hält fest, dass Vektor-RAG in jedem Vergleich die direktesten Antworten lieferte. Die Ergebnisse beantworten eine enge Frage, nämlich ob Map-Reduce über Community-Zusammenfassungen bei „Was sind die Themen?"-Fragen vollständiger ist als Top-k-Chunks. Die Antwort ist ja. Dass GraphRAG generell das bessere Retrieval wäre, zeigen sie nicht.
Aus einem aktuellen Projekt
Anfang dieses Jahres bat uns ein europäischer Industriekunde, einen GraphRAG-Proof-of-Concept zu bewerten. Ein Anbieter hatte ihn über die Dokumentation technischer Änderungen gebaut, und die Demo war beeindruckend. Auf die Frage „Welche Konstruktionsänderungen in allen Produktlinien gingen auf Qualitätsprobleme bei Lieferanten zurück?" lieferte er eine strukturierte, sauber belegte Übersicht, die der bestehende vektorbasierte Assistent nicht leisten konnte.
Wir ließen das oben beschriebene Harness mit echten Fragen aus dem technischen Helpdesk laufen, nach Typ markiert. Das Muster entsprach den Benchmarks. Die meisten Fragen waren konkrete Nachschlagefragen: Teilenummern, Freigabestatus, „Welches Dokument definiert X?". Hier war die Graph-Pipeline nicht besser als die bestehende hybride Suche, teils schlechter, weil die Entitätsextraktion fast gleichlautende Teilebezeichnungen zusammengeführt hatte. Ein kleiner Anteil war tatsächlich korpusweit oder chronologisch, und dort war der Graph klar überlegen. Den gesamten Korpus zu indexieren hätte jedoch ein Vielfaches des Vektorindex gekostet, und jede nächtliche Änderungscharge hätte eine Neuextraktion bedeutet.
Die Entscheidung fiel für einen Router, nicht für einen Umbau. Nachschlagefragen bleiben bei hybrider Suche mit Reranker. Korpusweite oder chronologische Fragen gehen an einen Graphen über einen eingegrenzten Ausschnitt: Änderungsmitteilungen und Lieferantenberichte, nicht jede Zeichnung. Das wertvollste Ergebnis war am Ende der markierte Fragensatz. Er läuft heute in der CI und fängt Regressionen ab, sobald jemand Chunking oder Prompts ändert.
Entscheidungstabelle: welches Retrieval für welche Frage
Das ist der Teil für den Screenshot. Nutzen Sie ihn zusammen mit Ihrem eigenen markierten Fragenmix, nicht stattdessen.
| Dominanter Fragetyp | Standardwahl | Warum (Evidenz) | Worauf achten |
|---|---|---|---|
| Einfache Faktenfrage („Welche Kündigungsfrist hat Vertrag X?") | Hybrides Vektor-RAG + Reranker | Gleichstand oder Sieg beim Faktenabruf in GraphRAG-Bench und bei Han et al. | Chunking- und Metadatenqualität, nicht die Architektur |
| Multi-Hop über Dokumente („Welche Lieferanten von Teil A sind auch bei Audit B durchgefallen?") | Lokale GraphRAG-Suche oder Vektor-Graph-Hybrid | Lokale Suche 71,2 % vs. 65,8 % auf MultiHop-RAG; Integration 77,6 % | Fehler bei der Entitätsauflösung führen Dinge stillschweigend zusammen |
| Zeitlich / chronologisch („Was hat sich nach der Richtlinienänderung 2025 geändert?") | Graph mit datierten Entitäten oder agentisch mit Datumsfiltern | 49,1 % vs. 25,7 % bei zeitlichen Fragen in MultiHop-RAG | Datumsangaben müssen bei der Indexierung extrahiert und normalisiert werden |
| Korpusweite Themen („Hauptrisiken über alle Auditberichte") | Globale GraphRAG-Suche oder verzögerter Graph-Ansatz | Ursprüngliche GraphRAG-Win-Rates; Zusammenfassungsaufgaben in GraphRAG-Bench | Abfragekosten des globalen Map-Reduce; nur richterbasierte Evidenz |
| Mehrteilige, offene Rechercheaufgaben | Agentisches Retrieval über Ihre besten vorhandenen Indizes | Zuwächse durch iterative Suche in BrowseComp-Plus, IRCoT und FRAMES | Latenz, schwankende Kosten pro Frage, Planungsfehler |
| Gemischter Verkehr (die meisten Unternehmen) | Router: Frage klassifizieren, dann weiterleiten | Ergebnisse für Selection und Integration bei Han et al. | Die Router-Genauigkeit braucht einen eigenen Testsatz |
| Unbeantwortbare Fragen oder Fragen außerhalb des Scopes | Vektor-RAG mit Enthaltungsschwelle | Vektor-RAG vorn bei Null-Fragen (91,4 % vs. 88,7 %) | Agenten suchen womöglich weiter, statt sich zu enthalten |
Zwei Regeln stehen über der Tabelle. Setzen Sie nie einen Graphen für einen Korpus ein, dessen Neuextraktion bei Änderungen Sie sich nicht leisten können. Und setzen Sie nie einen Agenten ohne Kosten- und Schrittlimit pro Frage ein.
Governance für europäische Unternehmen
Für Organisationen in der EU ist die Retrieval-Architektur nicht nur eine Genauigkeitsfrage. Drei Regelwerke greifen tatsächlich.
DSGVO. GraphRAG verändert Ihr Datenschutzbild auf eine Weise, wie Vektor-RAG es nicht tut. Bei der Indexierung liest ein generatives Modell den gesamten Korpus und erzeugt neue Artefakte: Beschreibungen von Entitäten und Beziehungen sowie Community-Zusammenfassungen. Enthält der Korpus personenbezogene Daten, sind diese Artefakte neue, daraus abgeleitete personenbezogene Daten, die oft Fakten über eine Person aus vielen Dokumenten zusammenführen. Daraus folgen drei Fragen. Ist diese Verarbeitung vom ursprünglichen Zweck und der Rechtsgrundlage gedeckt (Art. 5 Abs. 1 lit. b und Art. 6 DSGVO)? Können Sie Auskunfts- und Löschersuchen (Art. 15 und 17 DSGVO) erfüllen, wenn eine Person in extrahierten Entitäten und Community-Zusammenfassungen auftaucht? Läuft das Extraktions-LLM in einer Region und unter einem Auftragsverarbeitungsvertrag, die Sie geprüft haben? Für Personal-, Kunden- oder Gesundheitsdaten ist eine Datenschutz-Folgenabschätzung nach Art. 35 DSGVO der vernünftige Standard. Vektor-RAG hat dieselben Themen in milderer Form, weil sich Chunks leichter einem Quelldokument zuordnen und löschen lassen.
Berechtigungen und Oversharing. Jede Pipeline muss die Dokumentberechtigungen des Nutzers zur Abfragezeit durchsetzen, und Graph-Zusammenfassungen erschweren das: Eine einzige Community-Zusammenfassung kann Fakten aus Dokumenten mit unterschiedlichen Zugriffsrechten kombinieren. Bauen Sie getrennte Graphen pro Berechtigungsgrenze, oder indexieren Sie nur Inhalte, die alle Berechtigten sehen dürfen. Agentisches Retrieval sollte Quellen im Namen des Nutzers aufrufen, nie mit einer breit berechtigten Dienstidentität. Dasselbe Oversharing-Problem trifft Copilot-Einführungen; siehe unser Playbook gegen Oversharing in Microsoft 365 Copilot.
KI-Verordnung. Für die meisten internen Wissensassistenten sind heute Transparenz und KI-Kompetenz die relevanten Pflichten. Die Transparenzpflichten nach Artikel 50 gelten seit dem 2. August 2026; Nutzer müssen wissen, wenn sie mit einem KI-System interagieren. Speist ein Retrieval-System einen Anwendungsfall aus Anhang III, etwa Personalentscheidungen, gelten die Pflichten für Hochrisiko-KI-Systeme nach der Verschiebung durch die Verordnung (EU) 2026/1744 nun ab dem 2. Dezember 2027. So oder so sind Aktivitätsprotokolle und Quellenangaben, die eine gut gebaute Pipeline liefert, genau die Aufzeichnungen, die Sie als Nachweis brauchen werden. Das Aktivitätsprotokoll des agentischen Retrievals ist ein Governance-Merkmal, nicht nur eine Debugging-Hilfe.
Ein pragmatischer Einführungspfad
- Wochen 1–2: Fragensatz aufbauen. 200 bis 400 echte Fragen sammeln, nach Typ markieren und Referenzaussagen schreiben. Diesen Schritt überspringen die meisten Teams, und er entscheidet alles Weitere.
- Wochen 3–4: die Basis in Ordnung bringen. Sorgen Sie dafür, dass Ihr Vektor-RAG wirklich gut ist: hybride Suche, Reranker, sinnvolles Chunking, Metadatenfilter und Berechtigungsfilterung. Viele „GraphRAG-Siege" sind in Wahrheit Siege über eine schwache Basis.
- Wochen 5–6: der Vergleichstest. Basis, ein Graphverfahren und eine agentische Konfiguration auf demselben Korpus-Snapshot durch das Harness schicken, für den Graphen mit eingegrenztem Korpus, damit die Indexierungskosten beherrschbar bleiben. Ergebnisse pro Fragetyp ausweisen, mit Kosten und p95-Latenz.
- Wochen 7–8: das Routing festlegen. Die meisten Unternehmen landen bei einem Router: Vektor-RAG als Standard, Graph für die Fragetypen, bei denen er messbar gewinnt, agentisches Retrieval für mehrteilige Fragen, jeweils mit Schritt- und Kostenlimits. Schreiben Sie die Schwellenwerte auf.
- Laufend: das Harness in der CI halten. Bei jeder Änderung an Chunking, Modellen, Prompts oder Graphschema erneut ausführen und alles stilllegen, was seine Kosten nicht mehr rechtfertigt. Wohin sich die Architektur entwickelt, beschreibt unser Beitrag zu KI-Kontextplattformen nach RAG.
Das Fazit
GraphRAG ist kein besseres RAG. Es ist ein anderes Werkzeug, das bei bestimmten Fragen sehr gut ist. Die unabhängige Evidenz ist konsistent, sobald man sie nach Fragetyp aufschlüsselt. Graphen helfen, wenn Antworten von Verbindungen, zeitlicher Abfolge oder korpusweiten Themen abhängen. Bei Nachschlagefragen kosten sie mehr und erzeugen Rauschen. Agentisches Retrieval hilft bei mehrteiligen, offenen Fragen, und seine Genauigkeit ist durch die Qualität der durchsuchten Indizes begrenzt.
Unsere Position ist klar. Stellen Sie Ihr Retrieval nicht wegen eines Win-Rate-Diagramms auf einen Graphen um. Machen Sie zuerst Ihre hybride Vektor-Basis exzellent. Messen Sie dann Ihren eigenen Fragenmix nach Typ. Ergänzen Sie einen Graphen nur dort, wo er auf Ihren Daten gewinnt und Sie sich die Neuextraktion bei Korpusänderungen leisten können. Ergänzen Sie Agenten, wo Fragen wirklich mehrstufig sind, mit harten Limits. Gewinnen werden nicht die Organisationen mit der raffiniertesten Pipeline, sondern die, die pro Fragetyp belegen können, warum jede Pipeline da ist.
Wenn Sie diesen Vergleich auf Ihrem eigenen Korpus durchführen möchten, setzt unser Team für KI-Architektur das hier beschriebene Harness als Assessment mit festem Umfang um. Sie behalten den markierten Fragensatz, die Ergebnisse nach Fragetyp und eine Routing-Empfehlung, die Sie gegenüber CFO und Datenschutzbeauftragtem vertreten können.
FAQ
Ist GraphRAG besser als Vektor-RAG?
Nicht pauschal. Unabhängige Benchmarks aus 2025 und 2026 zeigen: Eine gut abgestimmte Vektor-RAG-Pipeline hält bei einfachen Faktenfragen mit GraphRAG mit oder schlägt es, während graphbasierte Verfahren bei Multi-Hop-, zeitlichen und korpusweiten Fragen gewinnen. In GraphRAG-Bench erreichte Vektor-RAG mit Reranking beim Faktenabruf auf einem Roman-Korpus 60,9 % gegenüber 49,3 % für Microsofts GraphRAG; bei kontextuellen Zusammenfassungen lag GraphRAG mit 64,4 % gegenüber 51,3 % vorn. Entscheidend ist, welche Fragen Ihre Nutzer tatsächlich stellen.
Wann schlägt GraphRAG tatsächlich Vektor-RAG?
Wenn eine Antwort Fakten aus vielen Dokumenten verknüpfen, Ereignisse zeitlich ordnen oder Themen über einen ganzen Korpus zusammenfassen muss. Auf MultiHop-RAG mit Llama 3.1-70B maßen Han et al. bei zeitlichen Fragen 49,1 % Genauigkeit für die lokale GraphRAG-Suche gegenüber 25,7 % für Vektor-RAG, insgesamt 71,2 % gegenüber 65,8 %. Bei einfachen Nachschlagefragen bringt der zusätzliche Graphkontext vor allem Rauschen und Tokens.
Was ist agentisches Retrieval und worin unterscheidet es sich von Agentic RAG?
Beim agentischen Retrieval steuert ein Sprachmodell die Suche selbst: Es plant Teilfragen, wählt Quellen, sucht parallel, prüft, ob die Evidenz reicht, und wiederholt bei Bedarf. Agentic RAG ist das übergeordnete Muster, in dem ein Agent Retrieval als eines seiner Werkzeuge nutzt. Azure AI Search bietet agentisches Retrieval als Produktfunktion an. Die allgemein verfügbare API-Version 2026-04-01 deckt minimales, extraktives Retrieval ab, LLM-Abfrageplanung und Antwortsynthese sind weiterhin Preview.
Wie viel teurer ist GraphRAG als Vektor-RAG?
Der große Unterschied liegt in der Indexierung. Laut Microsofts GraphRAG-Dokumentation entfallen rund 75 % der Indexierungskosten allein auf die LLM-gestützte Graphextraktion, und Han et al. berichten für MultiHop-RAG eine etwa 40-mal längere Aufbauzeit als für einen Vektorindex. Die Abfragekosten hängen vom Suchmodus ab: Die lokale Suche fügt moderat Kontext hinzu, die globale Suche aggregiert per Map-Reduce über Community-Zusammenfassungen und kann sehr teuer werden. Verzögerte Ansätze wie LazyGraphRAG versprechen Indexierungskosten auf Vektor-RAG-Niveau; das ist eine Herstellerangabe, die Sie mit Ihren Daten prüfen sollten.
Kann man Win-Rates aus LLM-as-a-Judge-Bewertungen bei GraphRAG trauen?
Nur mit Vorsicht. Zeng et al. ließen zwei identische LightRAG-Instanzen nach einem gängigen Bewertungsprotokoll gegeneinander antreten und erhielten ein Verhältnis von 90 % zu 10 %, verursacht durch Längen- und Positions-Bias sowie Einzeldurchläufe. Nach der Korrektur fielen die GraphRAG-Vorteile deutlich moderater aus als zuvor berichtet. Bevorzugen Sie Benchmarks mit Referenzantworten. Wenn ein LLM-Richter nötig ist, vertauschen Sie die Reihenfolge, wiederholen Sie die Bewertung mehrfach und weisen Sie Unentschieden aus.
Wie bewerten wir Retrieval-Ansätze mit unseren eigenen Dokumenten?
Bauen Sie einen Fragensatz aus echtem Nutzungsverkehr auf, markieren Sie jede Frage nach Typ (Fakt, Multi-Hop, zeitlich, korpusweit, unbeantwortbar) und hinterlegen Sie Referenzantworten oder Kernaussagen. Lassen Sie jede Pipeline auf demselben Korpus, mit demselben Antwortmodell und denselben Fragen laufen. Messen Sie Aussagen-Recall, Quellenpräzision, Kosten pro 1.000 Fragen, p95-Latenz und wie schnell ein geändertes Dokument in Antworten ankommt. Bewerten Sie in beiden Reihenfolgen mit mindestens drei Durchläufen und werten Sie nach Fragetyp aus, nicht nur als Gesamtdurchschnitt.
Quellen
Alle Quellen geprüft am 15. November 2026. Benchmark-Werte sind wie veröffentlicht wiedergegeben; wir haben keinen davon selbst nachgerechnet.
Stufe A: Primärquellen, offizielle Dokumentation und Rechtstexte
- Edge et al., „From Local to Global: A GraphRAG Approach to Query-Focused Summarization", arXiv:2404.16130 (v1 April 2024, v2 Februar 2025): https://arxiv.org/abs/2404.16130
- Han et al., „RAG vs. GraphRAG: A Systematic Evaluation and Key Insights", arXiv:2502.11371 (Tabellen aus v2; v3 März 2026): https://arxiv.org/abs/2502.11371
- Xiang et al., „When to use Graphs in RAG: A Comprehensive Analysis for Graph Retrieval-Augmented Generation" (GraphRAG-Bench), ICLR 2026, arXiv:2506.05690 (v3 Februar 2026): https://arxiv.org/abs/2506.05690
- Zeng et al., „How Significant Are the Real Performance Gains? An Unbiased Evaluation Framework for GraphRAG", arXiv:2506.06331: https://arxiv.org/abs/2506.06331
- Chen et al., „BrowseComp-Plus: A More Fair and Transparent Evaluation Benchmark of Deep-Research Agent", arXiv:2508.06600: https://arxiv.org/abs/2508.06600
- Trivedi et al., „Interleaving Retrieval with Chain-of-Thought Reasoning for Knowledge-Intensive Multi-Step Questions" (IRCoT), ACL 2023, arXiv:2212.10509: https://arxiv.org/abs/2212.10509
- Krishna et al., „Fact, Fetch, and Reason: A Unified Evaluation of Retrieval-Augmented Generation" (FRAMES), arXiv:2409.12941: https://arxiv.org/abs/2409.12941
- Gutiérrez et al., „From RAG to Memory: Non-Parametric Continual Learning for Large Language Models" (HippoRAG 2), ICML 2025, arXiv:2502.14802: https://arxiv.org/abs/2502.14802
- Microsoft GraphRAG-Dokumentation, Indexierungsmethoden: https://microsoft.github.io/graphrag/index/methods/
- Microsoft GraphRAG Releases (v3.3.0, 8. Oktober 2026): https://github.com/microsoft/graphrag/releases
- Microsoft Learn, Agentic retrieval overview, Azure AI Search (Stand September 2026): https://learn.microsoft.com/en-us/azure/search/agentic-retrieval-overview
- AWS, „Amazon Bedrock Knowledge Bases supports GraphRAG now generally available" (7. März 2025): https://aws.amazon.com/about-aws/whats-new/2025/03/amazon-bedrock-knowledge-bases-graphrag-generally-available
- Verordnung (EU) 2016/679 (DSGVO), Art. 5, 6, 15, 17 und 35: https://eur-lex.europa.eu/eli/reg/2016/679/oj/deu
- Verordnung (EU) 2024/1689 (KI-Verordnung), Artikel 50 und Anhang III: https://eur-lex.europa.eu/eli/reg/2024/1689/oj/deu
Stufe B: Benchmark-Ressourcen und Forschung
- GraphRAG-Bench-Repository: https://github.com/GraphRAG-Bench/GraphRAG-Benchmark
- MultiHop-RAG-Benchmark (Tang und Yang, 2024), arXiv:2401.15391: https://arxiv.org/abs/2401.15391
Stufe C: Herstellerforschung, richtungsweisend
- Microsoft Research, „LazyGraphRAG: Setting a new standard for quality and cost" (25. November 2024, Editor's Note Juni 2025): https://www.microsoft.com/en-us/research/blog/lazygraphrag-setting-a-new-standard-for-quality-and-cost/
- Microsoft Research, „BenchmarkQED: Automated benchmarking of RAG systems" (5. Juni 2025): https://www.microsoft.com/en-us/research/blog/benchmarkqed-automated-benchmarking-of-rag-systems/
Themen