LLM-Red-Teaming-Playbook: PyRIT, garak und promptfoo
Ein wiederholbarer Red-Teaming-Zyklus für LLM-Anwendungen mit PyRIT, garak und promptfoo: Stand 2026, OWASP-Abdeckung und Release-Gates in der CI.
Am 13. November 2026 hat Microsoft PyRIT 1.2.0 veröffentlicht, sein Open-Source-Toolkit für KI-Red-Teaming, jetzt mit Befundverwaltung in der Oberfläche. Einen Monat zuvor bekam NVIDIAs Scanner garak eine hit@k-Metrik für die Angriffserfolgsrate. Im März kündigte OpenAI an, Promptfoo zu übernehmen, dessen CLI viele Teams nutzen, um LLM-Anwendungen aus der CI heraus anzugreifen. Die drei wichtigsten Open-Source-Werkzeuge für Angriffe auf die eigenen LLM-Anwendungen haben sich 2026 deutlich verändert. Die meisten Vergleiche im Netz sind veraltet.
Sie beantworten auch die falsche Frage. „Welches Werkzeug?“ ist weniger wichtig als „welcher Zyklus?“. Ein einmaliger Scan vor dem Go-live zeigt, wie sich Ihre Anwendung an einem Tag verhalten hat, mit einer Modellversion und einem System-Prompt. Alle drei ändern sich alle paar Wochen. Dieses Playbook richtet sich an alle, die das Risiko verantworten: CISOs, Verantwortliche für KI-Plattformen, Architekten und die Engineers, die testen. Wir beschreiben einen Zyklus in sechs Stufen und zeigen, was PyRIT, garak und promptfoo im November 2026 beitragen. Und wir zeigen, wie aus Befunden ein Regressions-Gate für jedes Release wird.
TL;DR / Das Wichtigste in Kürze
- Testen Sie die Anwendung, nicht das Modell. System-Prompt, Retrieval-Daten, Tools und Guardrails bilden den Großteil der Angriffsfläche. Ein sauberer Modellscan sagt darüber wenig.
- Zwei Werkzeuge statt einem. garak ist der schnellste breite Scan und läuft vollständig in Ihrer Infrastruktur. promptfoo lässt sich am leichtesten in die CI einbauen und ist am stärksten bei Agenten- und API-Berechtigungen. PyRIT geht bei adaptiven Multi-Turn-Angriffen und von Menschen geführten Operationen am tiefsten.
- OWASP-Etiketten sind keine Abdeckung. Nach unserer Zählung taggt garak seine 193 Probe-Klassen nach der OWASP-Liste von 2023, und das 2025er-Preset von promptfoo ordnet der Lieferkette nichts zu. Nutzen Sie die Zuordnungen zur Organisation, nicht als Nachweis.
- Der Judge ist das schwächste Glied. Die Angriffserfolgsrate ist nur so gut wie die Bewertung, die festlegt, was „Erfolg“ heißt. Prüfen Sie eine Stichprobe der Urteile, bevor Sie einem Trend trauen.
- Befunde werden zu Regressionstests. Jeder bestätigte Befund wandert in eine CI-Suite mit Schwellenwert je Kategorie. So kann ein Modell-Upgrade oder eine Prompt-Änderung ihn nicht unbemerkt wieder öffnen.

Download: Editierbare draw.io-Datei · In diagrams.net öffnen · Diagrammdaten (CSV)
Warum das jetzt zählt
Die Werkzeuge sind erwachsen geworden. PyRIT erreichte im Juli 2026 die Version 1.0 mit neu gebautem Kern. Mit 1.2.0 kamen „Operations and Findings“ in die Oberfläche CoPyRIT. Das Projekt liegt jetzt unter microsoft/PyRIT, das alte Repository Azure/PyRIT ist archiviert. garak 0.17.0 (September) brachte Tags, die Probes Risikokategorien der KI-Verordnung zuordnen. promptfoo veröffentlicht alle paar Wochen ein Release. Ratschläge aus 2025 stimmen im Detail wahrscheinlich nicht mehr.
Die Eigentümer haben gewechselt. OpenAI kündigte am 9. März 2026 die Übernahme von Promptfoo an und will es in seine Enterprise-Agentenplattform Frontier integrieren. Laut README bleibt Promptfoo „open source and MIT licensed“. Europäische Unternehmen sollten trotzdem auf die Datenflüsse schauen statt auf die Lizenz.
Die Ziele haben sich verändert. Aus LLM-Anwendungen wurden Agenten mit Tools, Gedächtnis und Retrieval. Das AI Red Team von Microsoft hat über 100 generative KI-Produkte getestet und die Praxis in einem Lektionstitel zusammengefasst: „You don't have to compute gradients to break an AI system.“ Das BSI kommt in seinem Leitfaden zu Evasion-Angriffen vom November 2025 aus Verteidigersicht zum selben Schluss: Eine einzelne Gegenmaßnahme, die Evasion-Angriffe zuverlässig abwehrt, gibt es derzeit nicht. Wenn Prävention nie vollständig ist, muss das Testen kontinuierlich sein.
Die drei Werkzeuge im November 2026
Wir haben Quellcode und Dokumentation von PyRIT v1.2.0, garak v0.17.1 und promptfoo 0.125.1 am 15. November 2026 geprüft.
| PyRIT | garak | promptfoo | |
|---|---|---|---|
| Maintainer | Microsoft AI Red Team + Community | NVIDIA + Community | Promptfoo (OpenAI) + Community |
| Lizenz | MIT | Apache 2.0 | MIT |
| Laufzeit | Python ≥ 3.11 | Python | Node.js (auch brew, pip-Wrapper) |
| Denkmodell | Framework: Targets, Converter, Angriffe, Scorer, Memory | Scanner: Generatoren, Probes, Detektoren, Buffs, Harnesses | Konfigurationsgetriebene CLI: Plugins × Strategien |
| Schnittstellen | CLI pyrit_scan, Oberfläche CoPyRIT, Python-API | CLI, YAML/JSON-Konfiguration, JSONL- und HTML-Bericht | CLI, YAML-Konfiguration, Web-Viewer, GitHub Action |
| Stärke | Adaptive Multi-Turn-Angriffe, von Menschen geführte Operationen | Breite: 193 Probe-Klassen in 42 Modulen | Agenten- und API-Tests (BOLA, BFLA, RBAC, MCP), Framework-Presets |
| Achtung | Python-zentriert; Breaking Changes zwischen Minor-Versionen | OWASP-Tags nach Liste von 2023; viele Probes standardmäßig aus | Remote-only-Plugins senden Daten an die Promptfoo-API |
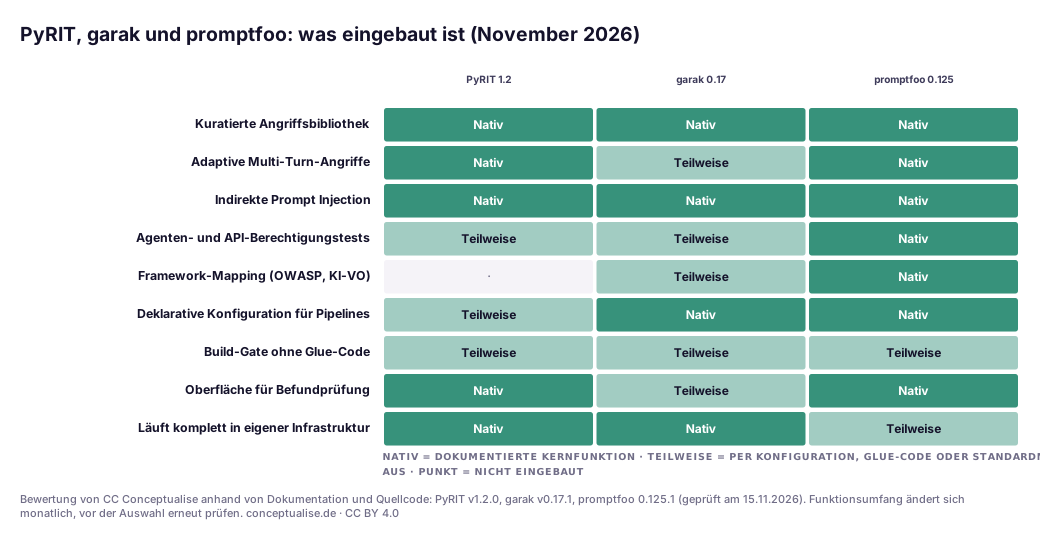
Die Matrix ist unsere Bewertung, nicht die eines Herstellers. Zwei Zeilen verdienen Aufmerksamkeit. Keines der drei Werkzeuge lässt Ihren Build ohne Glue-Code an Befunden scheitern. garak schreibt report.jsonl, promptfoo eine Ergebnisdatei, PyRIT in seinen Memory-Speicher. Sie brauchen also ein kurzes Skript, das den Exit-Code setzt. Und nur garak und PyRIT laufen standardmäßig vollständig in Ihrer Infrastruktur. Die promptfoo-Dokumentation ist da offen: Plugins für schädliche Inhalte, Bias und mehrere Sicherheitstests, darunter indirect-prompt-injection, ssrf, bola und bfla, laufen nur remote über die gehostete Inferenz von Promptfoo.
Daneben gibt es eine verwaltete Variante. Der AI Red Teaming Agent in Microsoft Foundry baut auf den Angriffsstrategien von PyRIT auf und weist die Angriffserfolgsrate (ASR) aus. Cloud-Scans laufen in wenigen Regionen, darunter France Central, Sweden Central und Switzerland West. Microsoft warnt selbst, dass die LLM-basierte Bewertung „non-deterministic“ sein kann.
Der Red-Teaming-Zyklus, Stufe für Stufe
Die Nummern entsprechen dem Diagramm oben. Den gesamten Zyklus können Sie mit zwei beliebigen der drei Werkzeuge abdecken.
① Scope und Bedrohungsmodell
Beginnen Sie bei der Anwendung, nicht beim Werkzeug. Halten Sie fest: Zweck, Nutzer, welche Daten das Modell lesen kann und welche Tools es aufrufen darf. Dazu jede Vertrauensgrenze, die nicht vertrauenswürdiger Text überquert: Nutzereingaben, abgerufene Dokumente, Webseiten, E-Mails, Tool-Ausgaben. Ordnen Sie jede den OWASP Top 10 für LLM-Anwendungen 2025 zu. Kategorien, die sich nicht per Prompt testen lassen, etwa die Lieferkette, markieren Sie als „anderweitig abgedeckt“. So verwechselt niemand eine Lücke mit einem Bestehen. Unser Bedrohungsmodell STRIDE für Agenten liefert genau die Liste der Vertrauensgrenzen, die diese Stufe braucht.
② Die Angriffsbibliothek
Bauen Sie je OWASP-Kategorie eine versionierte Bibliothek aus vier Quellen:
- garak-Probes: Encoding-Tricks, latente und indirekte Injection, halluzinierte Pakete, Markdown-Exfiltration, XSS über die Oberfläche, Extraktion des System-Prompts und Jailbreaks im DAN-Stil. In v0.17.1 sind nur 93 der 193 Probe-Klassen standardmäßig aktiv, den Rest müssen Sie explizit anfordern.
- PyRIT-Datasets und -Converter: Seed-Prompts plus rund hundert Converter-Klassen (Base64, Chiffren, verwechselbare Unicode-Zeichen, ASCII-Smuggling und mehr), die Sie auf jedes Angriffsziel verketten können.
- promptfoo-Plugins und -Strategien: Plugins erzeugen die Absicht (
bola,excessive-agency,prompt-extraction,rag-document-exfiltration). Strategien verpacken sie in eine Angriffstechnik wiejailbreak:composite,crescendooderbase64. - Eigene Fälle: jeder Vorfall, jede Bug-Bounty-Meldung, jeder Beinahe-Vorfall. Sie zählen am meisten, weil sie Ihren Geschäftskontext enthalten.
Legen Sie die Bibliothek in Git neben die Anwendung und behandeln Sie sie wie Code.
③ Der Harness
Der Harness steuert die Angriffe, protokolliert jeden Turn und begrenzt die Kosten. Richten Sie ihn auf die vollständige Anwendung in einer produktionsnahen Staging-Umgebung, nicht auf den nackten Modell-Endpunkt. Ein Modellscan findet nicht heraus, dass Ihre Retrieval-Schicht Dokumente eines anderen Mandanten zurückgibt.
Hier unterscheiden sich die Werkzeuge am stärksten. Die Multi-Turn-Angriffe von PyRIT (Crescendo, PAIR, Tree of Attacks with Pruning) passen jeden Turn mit einem gegnerischen LLM an die letzte Antwort des Ziels an. Der XPIA-Workflow platziert Anweisungen in Inhalten, die die Anwendung später abruft. Die Generatoren rest und websocket von garak erreichen die meisten Anwendungen hinter HTTP. Die HTTP-, WebSocket- und Browser-Provider von promptfoo greifen denselben Endpunkt an wie Ihre Oberfläche, inklusive Session-Handling. Legen Sie Seeds und Versuchsbudgets je Kategorie fest und begrenzen Sie die Rate.
④ Der Judge
Jeder Versuch braucht ein Urteil. garak nutzt Detektoren, überwiegend deterministische Musterprüfungen, ergänzt um Klassifikatoren und Judges. PyRIT hat Scorer, von Regex- und Tool-Call-Scorern bis zu LLM-basierten Wahr/Falsch- und Likert-Scorern. promptfoo bewertet die Ausgabe jedes Plugins mit einer LLM-Rubrik.
Ein nachsichtiger Judge verdeckt echte Schwächen, ein strenger überflutet die Triage mit Rauschen. In beiden Fällen misst Ihr ASR-Trend den Judge, nicht die Anwendung. Drei Regeln haben sich bei uns bewährt. Halten Sie Judge-Modell und Rubrik zwischen vergleichbaren Läufen fest. Bevorzugen Sie deterministische Prüfungen, wo das Fehlverhalten beobachtbar ist: ein Canary-String verlässt das System, ein verbotener Tool-Aufruf, HTML in der Ausgabe. Und lassen Sie in jedem Zyklus einen Menschen eine Stichprobe prüfen. Microsofts fünfte Lektion, „The human element of AI red teaming is crucial“, meint genau das.
⑤ Befunde und Triage
Ein Befund ist ein bestätigtes, reproduzierbares Fehlverhalten mit Schweregrad, OWASP-Kategorie, Owner und Fix. Berichten Sie die ASR je Kategorie, nie als eine einzige Zahl. Eine Anwendung mit 2 % bei toxischen Inhalten und 40 % bei indirekter Injection ist nicht „zu 21 % verwundbar“. Sie hat ein akzeptables Risiko und ein dringendes Problem. Fixes landen in der Anwendung: engerer Tool-Scope, Output-Encoding, Retrieval-Filter, menschliche Freigabe. Reine Prompt-Änderungen halten selten. Unser Leitfaden zu Prompt Injection und Tool-Missbrauch beschreibt die üblichen Kontrollen.
⑥ Die Regressionssuite in der CI
Jeder bestätigte Befund wird zum dauerhaften Testfall. Der CI-Job spielt die Suite ab, sobald sich Modell, System-Prompt, Retrieval-Konfiguration oder Tool-Set ändern. Er sperrt das Release, wenn eine Kategorie ihren Schwellenwert überschreitet oder sich verschlechtert. promptfoo passt hier am besten: promptfoo redteam run gegen eine eingecheckte Konfiguration plus ein Skript, das die Ergebnisse liest und den Exit-Code setzt. garak eignet sich als nächtlicher Breitenscan mit fester Probe-Liste. Der Zyklus schließt sich, wenn Regressionen und neue Befunde in die Bibliothek aus Stufe ② zurückfließen. Wenn Sie bereits einen Evaluations-Harness für Qualität betreiben, stellen Sie die Suite daneben. Unser Testing-Harness für KI-Agenten nutzt dasselbe CI-Gate-Muster.
Was die Zahlen sagen
Wir veröffentlichen keine Angriffserfolgsraten und würden jeder einzelnen ASR-Zahl für ein Werkzeug misstrauen. Die ASR hängt von Ziel, Judge, Versuchsbudget und Angriffsmix ab. Reproduzierbar messen lässt sich, was die Werkzeuge selbst als Abdeckung ausweisen. Also haben wir gezählt.
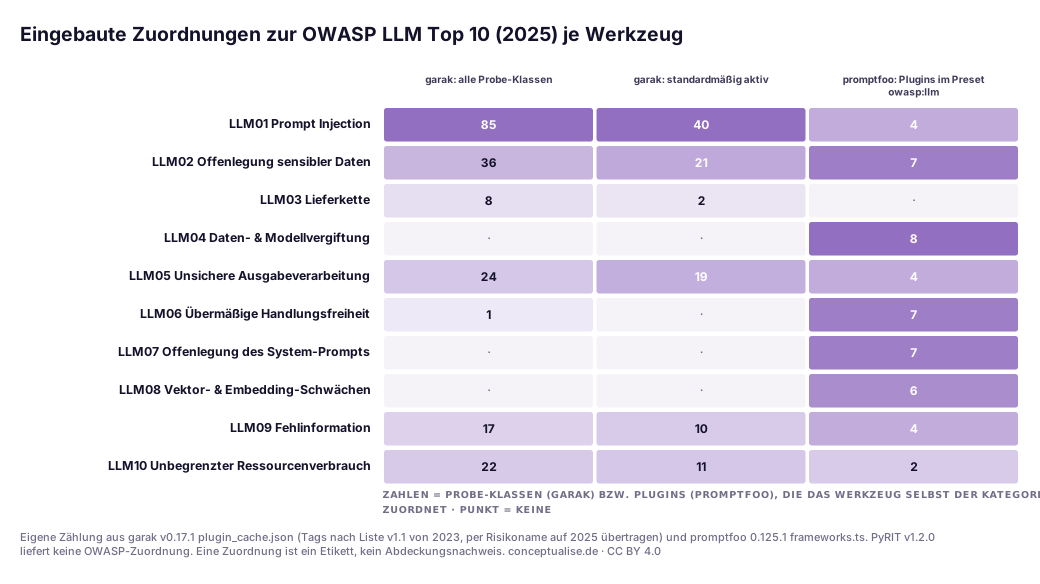
Methode. Für garak haben wir die mitgelieferte Plugin-Registry von v0.17.1 gelesen (garak/resources/plugin_cache.json). Ohne das Testmodul sind das 193 Probe-Klassen in 42 Modulen, davon 93 standardmäßig aktiv. Die OWASP-Tags von garak folgen laut eigener Tag-Datei der Liste v1.1 von 2023. Wir haben sie per Risikoname auf 2025 übertragen. So wird aus „Sensitive Information Disclosure“ (2023) die Kategorie LLM02 (2025), und „Model Theft“ landet bei LLM10, weil OWASP Modellextraktion inzwischen unter Unbounded Consumption führt. Für promptfoo haben wir die Plugins je Kategorie im Preset owasp:llm gezählt. PyRIT liefert keine OWASP-Zuordnung. Alle Zahlen und die vollständige Methode stehen in der CSV.
Vier Punkte fallen auf:
- garak ist stark auf Prompt Injection ausgerichtet. 85 von 193 Probe-Klassen tragen diesen Tag, 44 haben gar keinen OWASP-Tag. Das spiegelt die öffentliche Angriffsforschung, ist aber kein ausgewogener Testplan.
- Drei Kategorien von 2025 haben bei garak keine Zuordnung: Daten- und Modellvergiftung, Offenlegung des System-Prompts sowie Vektor- und Embedding-Schwächen. Teilweise ist das eine Etikettenfrage. garak hat eine Probe zur Extraktion des System-Prompts, getaggt ist sie aber als Prompt Injection. Genau deshalb sind Tags keine Abdeckung.
- promptfoo streut dünn, aber breit. Das Preset berührt neun von zehn Kategorien mit zwei bis acht Plugins. Die Lieferkette bleibt leer, und Plugins werden mehrfach verwendet: Die PII-Plugins tauchen unter drei Kategorien auf.
- Zahlen sagen nichts über Tiefe. Sieben Plugins für „Excessive Agency“ gegen eine getaggte garak-Probe wirkt eindeutig. Eine gut gebaute Multi-Turn-Kampagne mit PyRIT gegen Ihre echten Tools sagt mehr als beide Zahlen.
Nutzen Sie die Zuordnungen, um Bibliothek und Bericht zu ordnen. Einem Prüfer zeigen Sie besser Ihre Befunde und Ihre Regressionssuite.
Aus einem aktuellen Projekt
Ein europäisches Unternehmen bat uns vor einem breiteren Rollout, „ein Red-Teaming-Tool“ gegen seinen Kundenservice-Assistenten laufen zu lassen. Der Assistent hatte Retrieval über die Produktdokumentation und zwei Tools: Bestellabfrage und Ticketanlage. Das Team hatte den Modell-Endpunkt bereits mit garak gescannt und war zufrieden, zu Recht: Das Modell verhielt sich gut.
Die Anwendung nicht. Mit dem Harness auf dem Chat-Endpunkt kam der erste echte Befund aus einem hochgeladenen PDF. In einem Kundenanhang versteckte Anweisungen brachten den Assistenten dazu, eine Bestellung abzufragen, die dem Nutzer nicht gehörte. Kein Modellscan hätte das gefunden. Die Schwachstelle lag in der Berechtigungsprüfung des Tools, nicht im Alignment des Modells. Der zweite Befund betraf unseren eigenen Judge. Die erste Rubrik wertete mehrere höfliche Ablehnungen als Erfolg, weil sie Teile der verbotenen Anfrage wiederholten. Die menschliche Stichprobe fing das ab, bevor es in einen Bericht gelangte.
Die Fixes waren unspektakulär. Das Tool prüft die Bestellzugehörigkeit jetzt serverseitig, Anhänge gelten als nicht vertrauenswürdige Daten, und der Judge prüft deterministisch auf platzierte Canary-Daten. Alle drei Befunde liegen in der CI-Suite. Die quartalsweise PyRIT-Session danach fand in diesen Kategorien nichts Neues. So soll der Zyklus funktionieren.
Welches Werkzeug wann
| Wenn Sie … brauchen | Starten Sie mit | Warum | Später ergänzen |
|---|---|---|---|
| einen breiten Scan eines Modells oder Endpunkts noch diese Woche | garak | Hunderte Probes, kein Code, vollständig in Ihrer Infrastruktur | promptfoo für Tests auf Anwendungsebene |
| ein Red-Teaming-Gate in CI/CD | promptfoo | Deklarative Konfiguration, pipelinefreundliche CLI, Framework-Presets | garak als nächtlichen Scan |
| Tests für Agenten-, Tool- und API-Berechtigungen | promptfoo | Plugins für BOLA, BFLA, RBAC, MCP; Remote-only prüfen | PyRIT für adaptiven Missbrauch |
| adaptive Multi-Turn-Angriffe, geführte Operationen | PyRIT | Crescendo, PAIR, TAP, XPIA, Befundverwaltung | promptfoo zur Regression der Befunde |
| strikte Datenresidenz | garak oder PyRIT | Nur die von Ihnen konfigurierten Modelle werden aufgerufen | promptfoo mit eigenem Provider, Remote-Generierung aus |
| einen verwalteten Dienst in Azure | AI Red Teaming Agent in Foundry | Basiert auf PyRIT, ASR je Risikokategorie | Open-Source-PyRIT jenseits der unterstützten Ziele |
Unsere Checkliste, bevor wir ein Programm als betriebsbereit bezeichnen:
- Ein Bedrohungsmodell benennt jede Vertrauensgrenze und jedes Tool.
- Die Angriffsbibliothek ist versioniert, nach OWASP-Kategorien 2025 geordnet und enthält eigene Vorfälle.
- Tests zielen auf die vollständige Anwendung im Staging, indirekte Injection wird über jeden Eingangskanal geprüft.
- Der Judge ist fixiert, und ein Mensch prüft in jedem Zyklus eine Stichprobe.
- Die ASR wird je Kategorie mit Versuchszahlen berichtet.
- Jeder bestätigte Befund hat Owner, Fix und Regressionstest.
- Die CI sperrt Releases bei Überschreitung der Schwellen je Kategorie und bei Regressionen.
- Die Datenflüsse jedes Werkzeugs, einschließlich gehosteter Inferenz, sind dokumentiert.
Governance für europäische Unternehmen
KI-Verordnung. Nach Artikel 55 Absatz 1 Buchstabe a der Verordnung (EU) 2024/1689 müssen Anbieter von KI-Modellen mit allgemeinem Verwendungszweck mit systemischem Risiko eine Modellbewertung nach standardisierten Protokollen und Instrumenten durchführen, die dem Stand der Technik entsprechen. Dazu gehören die Durchführung und Dokumentation von Angriffstests. Die Pflicht gilt seit dem 2. August 2025. Die meisten Unternehmen sind Betreiber, nicht solche Anbieter. Unser Leitfaden zu Anbieter- und Betreiberpflichten bei GPAI hilft bei der Einordnung. Für Hochrisiko-KI-Systeme verlangt Artikel 15 Widerstandsfähigkeit gegen Datenvergiftung, Modellvergiftung, adversariale Beispiele und Angriffe auf die Vertraulichkeit. Seit der Verordnung (EU) 2026/1744 gelten diese Pflichten ab dem 2. Dezember 2027. Das verschafft Zeit, den Zyklus sauber aufzubauen, ist aber kein Grund zu warten.
DSGVO. Red-Teaming-Verkehr enthält oft personenbezogene Daten, eingespielt oder abgeflossen. Sendet ein Werkzeug Prompts und Antworten an einen gehosteten Dienst, verarbeitet dieser sie. promptfoo dokumentiert genau, was an api.promptfoo.app geht und wie PROMPTFOO_DISABLE_REMOTE_GENERATION und ein eigener Provider das ändern. Halten Sie das vor dem ersten Lauf in Ihrem Verzeichnis von Verarbeitungstätigkeiten fest und nutzen Sie, wo immer möglich, synthetische Canary-Daten.
NIS2. Artikel 21 Absatz 2 Buchstabe f der Richtlinie (EU) 2022/2555 verlangt Konzepte und Verfahren zur Bewertung der Wirksamkeit von Risikomanagementmaßnahmen im Bereich der Cybersicherheit. Für besonders wichtige und wichtige Einrichtungen mit kundennahen LLM-Anwendungen ist ein dokumentierter Red-Teaming-Zyklus mit Regressionsnachweisen eine starke Antwort.
BSI. Für deutsche Organisationen ist „Evasion Attacks on LLMs – Countermeasures in Practice“ (10. November 2025) die nationale Referenz für die Kontrollen, zu denen Ihre Befunde führen sollten.
Ein pragmatischer Einstieg
- Woche 1: Ausgangslage. Modellieren Sie die Bedrohungen einer produktiven LLM-Anwendung. Lassen Sie garak gegen ihren Endpunkt laufen und das promptfoo-Preset
owasp:llmgegen die vollständige Anwendung im Staging. Listen Sie die Remote-only-Plugins auf und entscheiden Sie, ob das akzeptabel ist. - Wochen 2–3: Judge und Triage. Fixieren Sie den Judge, ergänzen Sie Canary-Prüfungen, prüfen Sie eine Stichprobe von Hand und geben Sie den ersten Befunden Owner. Rechnen Sie damit, dass die meisten Anwendungsprobleme sind, keine Modellprobleme.
- Woche 4: CI-Gate. Checken Sie die Konfiguration ein, ergänzen Sie das Exit-Code-Skript und setzen Sie Schwellenwerte je Kategorie. Zwei Wochen nur berichten, dann durchsetzen.
- Monat 2: Tiefe. Führen Sie eine PyRIT-Session mit Multi-Turn-Angriffen und XPIA gegen die riskantesten Tool-Pfade durch und übernehmen Sie jeden bestätigten Befund in die Suite. Unser Leitfaden zum DevSecOps-Pipeline-Design zeigt, wo das Gate sitzt.
- Quartalsweise: Zyklus prüfen. Prüfen Sie die Werkzeugversionen erneut, aktualisieren Sie die Bibliothek aus Vorfällen und neuer Forschung und berichten Sie die ASR-Trends je Kategorie an den Risikoverantwortlichen.
Das Fazit
LLM-Red-Teaming ist keine Forschungsübung mehr, sondern eine Release-Disziplin. Die Werkzeuge sind gut genug und kostenlos: PyRIT für Tiefe, garak für Breite, promptfoo für die Pipeline. Meist fehlt der Zyklus drumherum: ein Bedrohungsmodell, das sie ausrichtet, ein geprüfter Judge, eine Triage mit Ownern und eine Regressionssuite, die keinen bekannten Fehler zweimal ausliefert.
Wählen Sie zwei Werkzeuge, nicht drei. Testen Sie die Anwendung, nicht das Modell. Nennen Sie nie eine ASR ohne Judge und Versuchsbudget. Messen Sie Fortschritt an bestätigten Befunden, die behoben bleiben, nicht an der Zahl gelaufener Probes.
Wenn Sie Unterstützung beim Aufbau des Zyklus wünschen, setzt unser KI-Engineering-Team ihn als kurzes Projekt mit festem Umfang für eine Ihrer produktiven Anwendungen auf, vom Bedrohungsmodell bis zum ersten CI-Gate. Angriffsbibliothek und Pipeline bleiben bei Ihnen.
FAQ
Was ist LLM-Red-Teaming?
LLM-Red-Teaming ist das gezielte Angreifen eines Systems, das auf einem großen Sprachmodell aufbaut. Sie nehmen die Rolle des Angreifers ein und versuchen, die Anwendung zum Preisgeben von Daten, zum Ignorieren ihrer Anweisungen, zum Missbrauch ihrer Tools oder zu schädlichen Ausgaben zu bringen. Anders als ein Benchmark zielt es auf Ihre Anwendung mit System-Prompt, Retrieval-Daten, Tools und Guardrails, nicht auf das Basismodell allein. Das AI Red Team von Microsoft formuliert es knapp: KI-Red-Teaming ist kein Safety-Benchmarking.
Sollten wir PyRIT, garak oder promptfoo einsetzen?
Meist zwei davon. garak ist der schnellste breite Scan eines Modells oder Endpunkts und läuft vollständig in Ihrer Infrastruktur. promptfoo lässt sich am leichtesten in eine Pipeline einbauen, hat die stärksten Plugins für Agenten- und API-Berechtigungen und bringt Framework-Presets wie owasp:llm mit. PyRIT ist das tiefste Werkzeug für adaptive Multi-Turn-Angriffe und von Menschen geführte Operationen. Ein bewährtes Muster: garak oder promptfoo in der CI, PyRIT für die quartalsweise Tiefenprüfung.
Ist promptfoo nach der Übernahme durch OpenAI noch Open Source?
Ja, Stand November 2026. OpenAI hat die Übernahme am 9. März 2026 angekündigt, und laut README bleibt Promptfoo Open Source unter MIT-Lizenz. Prüfen Sie den Datenfluss, nicht die Lizenz. Einige Red-Team-Plugins und -Strategien laufen nur remote und senden Daten zur Generierung oder Bewertung an api.promptfoo.app, sofern Sie keinen eigenen Provider konfigurieren oder die On-Premises-Enterprise-Edition nutzen.
Decken garak und promptfoo die OWASP Top 10 für LLM-Anwendungen 2025 ab?
Teilweise, und die Etiketten verlangen Sorgfalt. Das promptfoo-Preset owasp:llm ordnet Plugins der Liste von 2025 zu, lässt LLM03 Lieferkette aber leer. garak taggt Probes nach der älteren Liste v1.1 von 2023. Nach unserer Zählung für garak v0.17.1 ist nach der Übertragung auf 2025 keine Probe den Kategorien Daten- und Modellvergiftung, Offenlegung des System-Prompts sowie Vektor- und Embedding-Schwächen zugeordnet. Ein Tag ist ein Etikett, kein Abdeckungsnachweis.
Was ist die Angriffserfolgsrate und ab welchem Wert sollte ein Release gestoppt werden?
Die Angriffserfolgsrate (Attack Success Rate, ASR) ist die Zahl erfolgreicher Angriffe geteilt durch alle Versuche, meist je Risikokategorie. Einen universellen Schwellenwert gibt es nicht. Der Wert hängt vom Judge, vom Versuchsbudget und vom Angriffsmix ab und ist nur zwischen Läufen vergleichbar, die diese konstant halten. Wir setzen das Gate je Kategorie: null Toleranz für bestätigte Datenabflüsse oder unautorisierte Tool-Aktionen, für weichere Inhaltskategorien eine Trendregel wie keine Verschlechterung gegenüber dem letzten Release.
Verlangt die KI-Verordnung Red-Teaming?
Für Anbieter von KI-Modellen mit allgemeinem Verwendungszweck mit systemischem Risiko ja. Artikel 55 Absatz 1 Buchstabe a verlangt eine Modellbewertung einschließlich der Durchführung und Dokumentation von Angriffstests und gilt seit dem 2. August 2025. Für Hochrisiko-KI-Systeme verlangt Artikel 15 Widerstandsfähigkeit gegen Angriffe wie Datenvergiftung und adversariale Beispiele. Diese Pflichten gelten nach der Verordnung (EU) 2026/1744 jedoch erst ab dem 2. Dezember 2027. Die meisten Unternehmen, die LLM-Anwendungen betreiben, sind heute nicht gesetzlich zum Red-Teaming verpflichtet, aber es ist der glaubwürdigste Nachweis, dass ihre Kontrollen wirken.
Quellen
Alle Quellen am 15. November 2026 geprüft. Die Werkzeugzählungen sind unsere eigene Auswertung der getaggten Releases; die Methode steht in der CSV mit den Diagrammdaten.
Stufe A: Primärquellen, Standards und Regulierung
- PyRIT, Repository und Release Notes v1.0.0, v1.1.0, v1.2.0: https://github.com/microsoft/PyRIT/releases
- garak, Repository und Release Notes v0.17.0, v0.17.1: https://github.com/NVIDIA/garak/releases
- garak v0.17.1, Plugin-Registry (Grundlage unserer Probe-Zählung): https://github.com/NVIDIA/garak/blob/v0.17.1/garak/resources/plugin_cache.json
- promptfoo, Release 0.125.1 und OWASP-Preset (
frameworks.ts): https://github.com/promptfoo/promptfoo/blob/0.125.1/src/redteam/constants/frameworks.ts - promptfoo-Dokumentation, Datenverarbeitung und Datenschutz beim Red-Teaming: https://www.promptfoo.dev/docs/red-team/troubleshooting/data-handling/
- promptfoo-Dokumentation, CI/CD-Integration: https://www.promptfoo.dev/docs/integrations/ci-cd/
- Microsoft Learn, AI Red Teaming Agent in Microsoft Foundry: https://learn.microsoft.com/en-us/azure/foundry/concepts/ai-red-teaming-agent
- OWASP Top 10 for LLM Applications 2025: https://genai.owasp.org/llm-top-10/
- OWASP LLM10:2025 Unbounded Consumption: https://genai.owasp.org/llmrisk/llm102025-unbounded-consumption/
- Verordnung (EU) 2024/1689 (KI-Verordnung), Artikel 15 und 55: https://eur-lex.europa.eu/eli/reg/2024/1689/oj/deu
- Richtlinie (EU) 2022/2555 (NIS2), Artikel 21: https://eur-lex.europa.eu/eli/dir/2022/2555/oj/deu
- BSI, „Evasion Attacks on LLMs – Countermeasures in Practice“ (10.11.2025): https://www.bsi.bund.de/SharedDocs/Downloads/EN/BSI/KI/Evasion_Attacks_on_LLMs-Countermeasures.html
Stufe B: Forschung und Analyse
- Bullwinkel et al., „Lessons From Red Teaming 100 Generative AI Products“, Microsoft (arXiv:2501.07238, Jan. 2025): https://arxiv.org/abs/2501.07238
- Derczynski et al., „garak: A Framework for Security Probing Large Language Models“ (arXiv:2406.11036): https://arxiv.org/abs/2406.11036
- OWASP GenAI Security Project, GenAI Red Teaming Guide (Jan. 2025): https://genai.owasp.org/resource/genai-red-teaming-guide/
Stufe C: Hersteller und Presse, richtungsweisend
- OpenAI, „OpenAI to acquire Promptfoo“ (9. März 2026): https://openai.com/index/openai-to-acquire-promptfoo/
- Microsoft Security Blog, „3 takeaways from red teaming 100 generative AI products“: https://www.microsoft.com/en-us/security/blog/2025/01/13/3-takeaways-from-red-teaming-100-generative-ai-products/
- Security Boulevard, „OpenAI Acquires Security Startup Promptfoo to Fortify AI Agents“ (März 2026): https://securityboulevard.com/2026/03/openai-acquires-security-startup-promptfoo-to-fortify-ai-agents
Themen