Bedrohungsmodell für KI-Agenten: STRIDE, 14 Angriffspunkte
Bedrohungsmodell für agentische KI auf einer Seite: STRIDE für KI-Agenten, 14 Angriffspunkte vom Prompt bis zum A2A-Partner und die passenden Kontrollen.
Am 1. Mai 2026 veröffentlichten sechs nationale Cybersicherheitsbehörden, darunter CISA, NSA und das britische NCSC, die gemeinsame Leitlinie Careful Adoption of Agentic AI Services. Eine ihrer Empfehlungen: eine formale Bedrohungsmodellierung, bevor ein Agent in Produktion geht. Fünf Monate zuvor hatte OWASP die Top 10 for Agentic Applications veröffentlicht. Anfang Februar zählte Gartner die Aufsicht über agentische KI und Identitäten für maschinelle Akteure zu den wichtigsten Cybersecurity-Trends 2026. Alle sind sich einig, dass KI-Agenten ein Bedrohungsmodell brauchen. Fast niemand hat eines veröffentlicht, das man an ein Whiteboard hängen kann.
Dieser Beitrag ist dieses Whiteboard. Er richtet sich an alle, die einen Agenten für den Produktivbetrieb freigeben: CISOs, Sicherheitsarchitekten, Plattformverantwortliche und CTOs, die gefragt werden, was passiert, wenn etwas schiefgeht. Wir nehmen STRIDE, das Vokabular, mit dem die meisten Sicherheitsteams ohnehin arbeiten, und wenden es auf einen Referenzagenten mit Nutzerkanal, Orchestrator, Gedächtnis, MCP-Tools und A2A-Partnern an. Das Ergebnis: ein Diagramm mit 14 nummerierten Angriffspunkten, eine Heatmap, welche Kontrolle welchen Punkt bricht, und ein Crosswalk zur OWASP-Liste.
TL;DR / Das Wichtigste in Kürze
- STRIDE funktioniert weiter, mit einer geänderten Annahme. Behandeln Sie das Planer-LLM als berechtigten, aber nicht vertrauenswürdigen Nutzer. Alles, was es liest, kann zur Anweisung werden. Keine Sicherheitsentscheidung gehört ins Modell.
- Vierzehn Angriffspunkte, vier Vertrauensgrenzen. Von direkter Prompt-Injection bis zur Abstreitbarkeit im Audit-Trail. Jedes der zehn OWASP-Risiken für agentische Anwendungen lässt sich mindestens einem davon zuordnen.
- Policy am Tool-Aufruf leistet die meiste Arbeit. In unserer Analyse wirkt sie auf 11 von 14 Angriffspunkten und hält auch dann, wenn das Modell vollständig gekapert ist.
- Zehn von vierzehn Angriffspunkten hängen an genau einer primären Kontrolle. Erkennung wirkt auf alle vierzehn, ist aber nur für einen primär. Diese Lücke schließen Sie vor dem Go-live.
- Die Tool-Lieferkette ist schon verunreinigt. Koi Security stufte im Februar 2026 341 von 2.857 ClawHub-Skills als bösartig ein. Pinnen und prüfen Sie Agenten-Tools wie jede andere Abhängigkeit.

Download: Editierbare draw.io-Datei · In diagrams.net öffnen · Diagrammdaten (CSV)
Warum KI-Agenten jetzt ein eigenes Bedrohungsmodell brauchen
Der schlimmste Tag eines Chatbots ist eine peinliche Antwort. Ein Agent, der Ihre Mails liest, das CRM abfragt, Pull Requests öffnet und einen anderen Agenten um eine Zahlung bittet, hat die Angriffsfläche eines privilegierten Mitarbeiters, ohne dessen Urteilsvermögen. Das hat die Branche 2025 gelernt.
Im Mai 2025 zeigte Invariant Labs, dass ein bösartiges Issue in einem öffentlichen GitHub-Repository einen Agenten mit dem offiziellen GitHub-MCP-Server dazu bringen konnte, Daten aus privaten Repositories über einen öffentlichen Pull Request preiszugeben. Invariant sprach von einem Architekturproblem, nicht von einem Serverfehler. Im Juni veröffentlichte Aim Labs EchoLeak (CVE-2025-32711): Eine präparierte E-Mail im Kontext von Microsoft 365 Copilot konnte ohne Klick des Nutzers Unternehmensdaten abfließen lassen. Microsoft behob die Lücke serverseitig. Im September veröffentlichte ein inoffizielles postmark-mcp-Paket auf npm zunächst eine Reihe sauberer Versionen und fügte dann in 1.0.16 eine Zeile ein, die jede ausgehende Mail per BCC an einen Angreifer schickte. Im November meldete Anthropic, die Kampagne GTG-1002 gestoppt zu haben: Eine Gruppe, die Anthropic einem chinesischen Staatsakteur zuordnet, setzte Claude Code und MCP-Tools gegen rund dreißig Ziele ein. Anthropic schätzt, dass die KI 80–90 % der taktischen Arbeit erledigte. Externe Forschende bezweifeln die Zahl, nicht aber die Richtung.
2026 kam die Masse. Hasan et al. untersuchten 1.899 Open-Source-MCP-Server und fanden bei 5,5 % Tool Poisoning und bei 7,2 % allgemeine Schwachstellen. Li und Gao prüften 67.057 Server aus sechs Registries und stuften 833 als verwundbar ein. Koi Security analysierte 2.857 Skills auf OpenClaws Marktplatz ClawHub und stufte 341 als bösartig ein.
Auch die Standardisierung zog nach. Das NCCoE des NIST veröffentlichte im Februar 2026 ein Konzeptpapier zu Identität und Autorisierung von KI-Agenten. BSI und ANSSI hatten bereits im August 2025 gemeinsame Designprinzipien für LLM-basierte Systeme nach Zero Trust vorgelegt. Die MCP-Revision 2026-07-28 verbietet Token-Passthrough und beschreibt Confused-Deputy-, SSRF- und Scope-Risiken. A2A erreichte am 12. März 2026 Version 1.0; die Signatur von Agent Cards ist Teil der Kernspezifikation. Was fehlt, ist ein Referenzbild, das all das zusammenführt.
STRIDE, angepasst für Agenten
STRIDE stammt von Loren Kohnfelder und Praerit Garg (Microsoft, 1999). An jeder Vertrauensgrenze fragt es, ob jemand eine Identität fälschen (Spoofing), Daten manipulieren (Tampering), eine Handlung abstreiten (Repudiation), Informationen abgreifen (Information Disclosure), einen Dienst lahmlegen (Denial of Service) oder Rechte ausweiten (Elevation of Privilege) kann. Es hat überlebt, weil es langweilig und vollständig ist.
Agenten brechen eine Annahme, auf der STRIDE beruht. In einem normalen System setzt jeder Prozess seine eigene Logik durch. Ein Webserver ändert sein Routing nicht, weil ein Request-Body ihn darum bittet. Ein Sprachmodell tut genau das, weil Anweisungen und Daten über denselben Kanal kommen. Der Planer ist also kein vertrauenswürdiger Prozess. Er gleicht eher einem hilfsbereiten Mitarbeiter, der tut, was eine überzeugende E-Mail verlangt.
Daraus folgen drei Arbeitsregeln:
- Behandeln Sie den Planer als berechtigten, aber nicht vertrauenswürdigen Nutzer. Er darf Aktionen anfordern. Ob sie erlaubt sind, entscheidet er nicht.
- Legen Sie jede Sicherheitsentscheidung außerhalb des Modells fest. Autorisierung, Datenklassifizierung, Rate Limits und Freigabe-Routing liegen in deterministischen Komponenten, die das Modell nicht umschreiben kann.
- Modellieren Sie Grenzübertritte, nicht Komponenten. Die meisten Angriffe auf Agenten lauten nicht „Komponente X brechen“, sondern „den Agenten dazu bringen, etwas über eine Grenze zu tragen“.
Das MAESTRO-Framework der Cloud Security Alliance (Februar 2025) sieht Lücken in STRIDE und ergänzt eine Sicht mit sieben Schichten. Die Diagnose teilen wir. In der Praxis kommen Teams, die ohnehin mit STRIDE arbeiten, aber weiter, wenn sie die echten Grenzen ihres Agenten zeichnen, statt eine neue Taxonomie zu lernen. Nutzen Sie MAESTRO als Gegenprobe.
Die 14 Angriffspunkte, Grenze für Grenze
Die Nummern entsprechen den warmen Kreisen im Diagramm, die Kontrollbuchstaben der Heatmap weiter unten.
① Direkte Prompt-Injection
STRIDE: Tampering, Elevation. Der Nutzer oder wer dessen Kanal übernommen hat, weist den Agenten an, seine Vorgaben zu ignorieren. Die Akteure hinter GTG-1002 zerlegten ihren Angriff in „kleine, scheinbar harmlose Aufgaben“ und gaben sich als Sicherheitsfirma aus. Direkte Injection im industriellen Maßstab.
Im Modell verhindern Sie das nicht. Entscheidend ist Policy am Tool-Aufruf (D). Kann der Agent kein Tool aufrufen, für das der Nutzer nicht berechtigt ist, gewinnt der Angreifer durch einen Jailbreak nichts, was der Nutzer nicht ohnehin hatte.
② Indirekte Prompt-Injection
STRIDE: Tampering. Die Anweisung steckt in Inhalten, die der Agent liest: E-Mail, PDF, Webseite, Ticket, Tool-Ergebnis. Das ist der wichtigste Punkt der Liste, denn der Angreifer braucht keinen Zugang zu Ihren Systemen. EchoLeak und der GitHub-MCP-Fall sind beide indirekte Injection.
Primäre Kontrolle ist Isolation von Fremdinhalten (A): Kennzeichnen Sie nicht vertrauenswürdige Inhalte als Daten und leiten Sie sie durch eine eingeschränkte Komponente, die zusammenfassen, aber keine Tools aufrufen kann. Kein Isolationsansatz ist perfekt, deshalb hat dieser Punkt mehr Teilkontrollen als jeder andere. Die Mechanik beschreibt unser Beitrag zu Prompt-Injection und Tool-Missbrauch.
Das ist der „Toxic Agent Flow“, den Invariant Labs beschrieben hat: nicht vertrauenswürdig lesen, privat lesen, öffentlich schreiben. Wenn Sie jedes Tool als untrusted-read, private-read oder public-write klassifizieren, kann das Gateway den letzten Schritt brechen. Die günstigste Datenfluss-Policy, die wir kennen.
③ Identitäts-Spoofing und Missbrauch der Delegation
STRIDE: Spoofing, Elevation. Für wen handelt der Agent, und lässt sich das fälschen? Typische Fehler sind ein gemeinsames Dienstkonto für alle Nutzer, Tokens ohne Nutzerbezug und wiederverwendbare Einwilligungen. Die MCP-Sicherheitsleitlinie beschreibt einen Confused-Deputy-Angriff, bei dem ein Proxy mit statischer Client-ID einem Angreifer über ein früher gesetztes Consent-Cookie einen Autorisierungscode verschafft.
Primäre Kontrolle ist Agentenidentität mit On-Behalf-of-Delegation (B): eine eigene Identität je Agent, Token Exchange, damit jedes nachgelagerte Token Agent und Nutzer trägt, und kurze Laufzeiten. Das NIST-Konzeptpapier fordert genau das: Agenten als identifizierbare Entitäten statt anonymer Automatisierung auf geteilten Zugangsdaten. Unser Leitfaden zu Agentenidentität und Token Exchange zeigt die Abläufe.
④ Manipulation der Freigabe
STRIDE: Spoofing, Tampering. OWASP nennt das Human-Agent Trust Exploitation (ASI09). Die freigebende Person sieht die Zusammenfassung des Agenten. Ein gekaperter Agent schreibt eine beruhigende Zusammenfassung. Den Rest erledigt die Freigabemüdigkeit.
Menschliche Freigabe (E) wirkt nur, wenn die Person den tatsächlichen Tool-Aufruf sieht, vom Gateway aus den echten Parametern dargestellt. Halten Sie Freigaben selten, damit sie Gewicht behalten. Muster dafür finden Sie in unserem Beitrag zu Human-in-the-Loop-Freigaben.
⑤ Vergiftung des Gedächtnisses
STRIDE: Tampering. Langzeitgedächtnis macht aus einer einmaligen Injection eine dauerhafte. Was heute ins Gedächtnis geschrieben wird, kommt nächsten Monat als vertrauenswürdiger Kontext zurück, für eine andere Aufgabe und manchmal für einen anderen Nutzer.
Primäre Kontrolle ist Gedächtnis-Governance (G): Herkunft jedes Schreibvorgangs festhalten, Schreibvorgänge aus nicht vertrauenswürdigen Quellen validieren, Partitionen je Nutzer, Ablaufdaten. Eine Erinnerung aus einer E-Mail darf nie mit der Autorität einer Systemanweisung zurückkommen.
⑥ Abfluss aus Kontext und Gedächtnis
STRIDE: Information Disclosure. Die Suche liefert etwas, das der aktuelle Nutzer nicht sehen darf, weil der Index mit einem allsehenden Dienstkonto gebaut wurde oder Gedächtnis sitzungsübergreifend geteilt wird. Das meiste Copilot-Oversharing ist dieser Punkt, nur ohne Angreifer.
Zwei primäre Kontrollen: Agentenidentität (B), damit die Suche mit den Rechten des Nutzers läuft, und Gedächtnis-Governance (G), damit Partitionen halten.
⑦ Lieferkette für Tools und Skills
STRIDE: Tampering. Agenten laden MCP-Server aus npm oder PyPI, Skills aus Marktplätzen und Tool-Beschreibungen von entfernten Servern. Der postmark-mcp-Rug-Pull, die ClawHub-Kampagne und CVE-2025-6514 in mcp-remote (CVSS 9,6, behoben in 0.1.16) gehören hierher. Ebenso Tool Poisoning, bei dem die bösartige Anweisung in der Tool-Beschreibung steckt.
Primäre Kontrolle ist eine gepinnte, geprüfte Registry (C): freigegebene Server und Skills, gepinnt auf Version und Hash, Tool-Beschreibungen bei der Freigabe erfasst und bei jedem Laden verglichen. Eine geänderte Beschreibung ist eine geänderte Abhängigkeit.
⑧ Tool-Missbrauch und übermäßige Handlungsmacht
STRIDE: Elevation. Der Agent nutzt ein legitimes Tool mit legitimen Rechten für einen illegitimen Zweck: löschen statt archivieren, die ganze Kundenliste anschreiben. Das ist ASI02, und genau das beschreiben die meisten Vorfallberichte, wenn man das Wie der Überredung weglässt.
Zwei primäre Kontrollen: Policy am Tool-Aufruf (D) prüft Parameter, Mengen und Datenklassen vor der Ausführung, menschliche Freigabe (E) deckt die wenigen unumkehrbaren Aktionen ab.
⑨ Confused Deputy und Token-Passthrough
STRIDE: Elevation, Spoofing. Ein MCP-Server reicht das Token des Aufrufers nach unten durch oder hält ein mächtiges statisches Credential für alle Aufrufer. Wer den Server erreicht, erbt dessen Autorität. Die MCP-Spezifikation ist deutlich: Server „MUST NOT accept any tokens that were not explicitly issued for the MCP server“.
Primäre Kontrolle ist wieder Agentenidentität und Token Exchange (B): Audience-gebundene Tokens über Resource Indicators, ein eng begrenztes Token je nachgelagertem Aufruf, schrittweise Scopes und kein Passthrough. Details in unserem Deep Dive zur MCP-Autorisierung.
⑩ Unerwartete Codeausführung
STRIDE: Elevation. Agenten führen Code aus: Interpreter, Shell-Tools, lokale MCP-Server, die per stdio aus einer Konfigurationsdatei gestartet werden. CVE-2025-49596 im MCP Inspector (CVSS 9,4) und die von OX Security im April 2026 veröffentlichte stdio-Schwachstelle, bei der Konfiguration direkt in Befehlsausführung mündet, zeigen: Das Tooling selbst ist Angriffsfläche.
Primäre Kontrolle ist eine Sandbox mit Egress-Kontrolle (F): kurzlebige Container oder MicroVMs, keine impliziten Zugangsdaten, Netzwerk-Allow-List.
⑪ Exfiltration über Ausgaben
STRIDE: Information Disclosure. Daten verlassen das Haus über die Ausgaben des Agenten: ein Markdown-Bild, dessen URL ein Geheimnis kodiert, ein vom Client vorab geladener Link, eine Zusammenfassung in einem öffentlichen Kanal, ein HTTP-Aufruf aus der Sandbox. EchoLeak nutzte den Ausgabekanal.
Zwei primäre Kontrollen: Ausgabefilter (J) neutralisieren externe Bilder und nicht vertrauenswürdige Links, Sandbox und Egress-Kontrolle (F) verhindern Aufrufe beliebiger Hosts.
⑫ Spoofing und Manipulation von A2A-Partnern
STRIDE: Spoofing, Tampering. Wer delegiert, vertraut der Identität des Partners, seiner Agent Card und seinen Antworten. Ein gefälschter oder kompromittierter Partner liefert vergiftete Ergebnisse oder fordert Aufgaben an, die Ihr Agent ausführt. OWASP nennt das Insecure Inter-Agent Communication (ASI07).
Zwei primäre Kontrollen: Agentenidentität (B) für gegenseitige Authentisierung nach den Verfahren, die die Agent Card ausweist, und eine gepinnte Registry (C) mit Partnern, deren Card-Signatur Sie geprüft haben. Signaturen für Agent Cards stehen seit Version 0.3 (Juli 2025) in der A2A-Spezifikation, eine Ausrede gibt es also nicht. Behandeln Sie alles, was ein Partner liefert, als Fremdinhalt. Damit sind Sie wieder bei ②.
⑬ Endlosschleifen und Denial of Wallet
STRIDE: Denial of Service. Ein Agent, der ein fehlerhaftes Tool endlos wiederholt, zwei Agenten, die sich gegenseitig Aufgaben zuschieben, oder ein Angreifer, der möglichst tokenintensive Arbeit schickt. Ergebnis: eine hohe Rechnung oder ein erschöpftes Kontingent für alle anderen. OWASP ordnet das den Cascading Failures (ASI08) zu.
Primäre Kontrolle sind Budgets und Circuit Breaker (H): Grenzen für Schritte, Tokens, Tool-Aufrufe und Kosten je Aufgabe und Nutzer, dazu eine Notabschaltung, die der Betrieb ohne Deployment auslösen kann.
⑭ Abstreitbarkeit und abtrünnige Agenten
STRIDE: Repudiation. Können Sie nach einem Vorfall belegen, welcher Agent was für wen mit welcher Tool-Version getan hat und wer es freigegeben hat? Ohne diesen Nachweis können Sie weder sauber untersuchen noch melden. Auch Rogue Agents (ASI10) gehören hierher: Ein Abdriften aus dem vorgesehenen Rahmen sehen Sie nur, wenn Sie den Rahmen festhalten und überwachen.
Primäre Kontrolle ist manipulationssicheres Tracing mit Erkennung (I): ein unveränderliches Log jedes Tool-Aufrufs mit Identitätskette, Parametern und Tool-Version, Traces über Agenten hinweg und Erkennungsregeln im SIEM. Erkennung wirkt auf alle 14 Punkte, primär ist sie nur für diesen.
Was die Zahlen sagen
Wir haben zehn Kontrollen gegen die 14 Angriffspunkte bewertet: primär (verhindert oder bricht den Angriff), teilweise (begrenzt oder erkennt) oder ohne wesentlichen Effekt. Das ist unsere Analyse der Referenzarchitektur, keine externe Datenquelle. Laden Sie die CSV herunter und bewerten Sie Ihren eigenen Agenten.
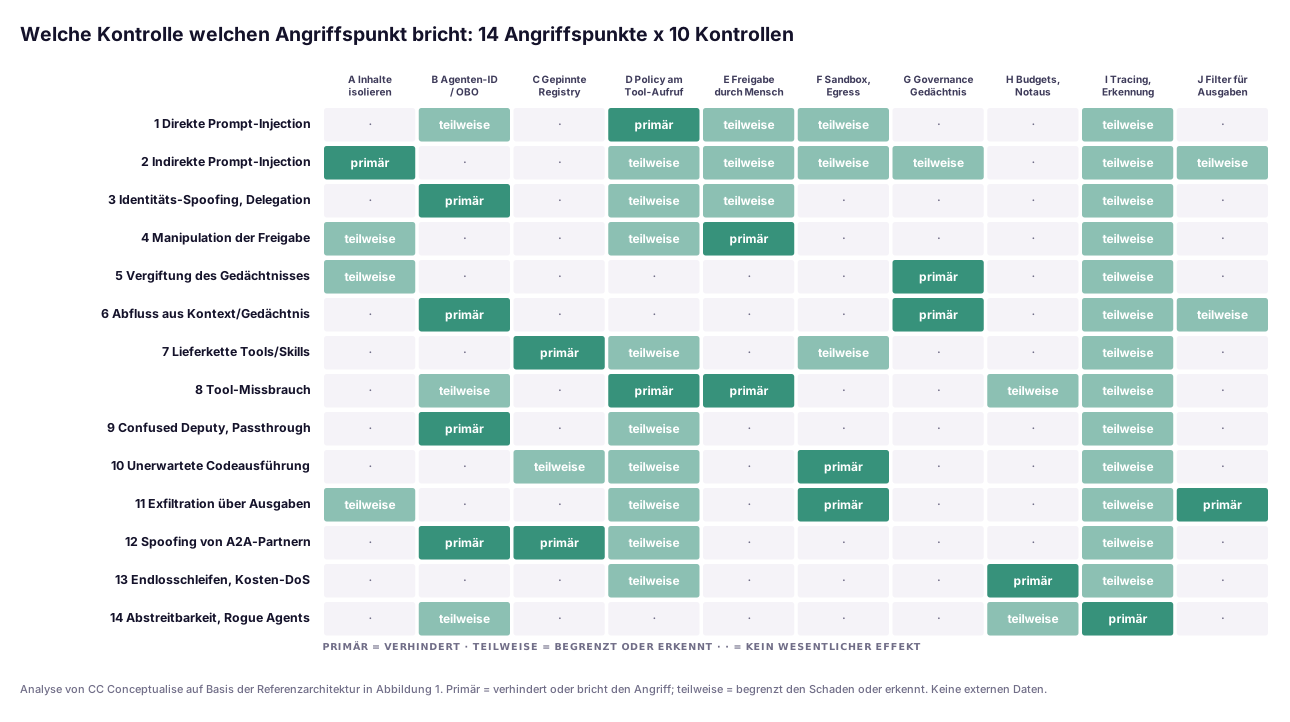
Drei Lesarten zählen. Erstens: Zehn der vierzehn Angriffspunkte hängen an genau einer primären Kontrolle. Fehlt sie, bleiben Teilkontrollen und Erkennung. Für einen Pilot vertretbar, für einen Agenten mit Schreibrechten auf Wichtiges nicht.
Zweitens: Policy am Tool-Aufruf ist das Arbeitspferd. Sie wirkt auf 11 von 14 Punkten und hält auch bei vollständig kompromittiertem Modell, weil sie nicht fragt, warum das Modell etwas wollte. Wenn Sie vor dem Go-live nur eines bauen, bauen Sie das Gateway.
Drittens: Erkennung ist überall und nirgends entscheidend. Tracing berührt alle 14 Punkte und ist für einen primär. Teams, die eine Observability-Plattform kaufen und das Agentensicherheit nennen, merken das meist beim ersten Vorfall.
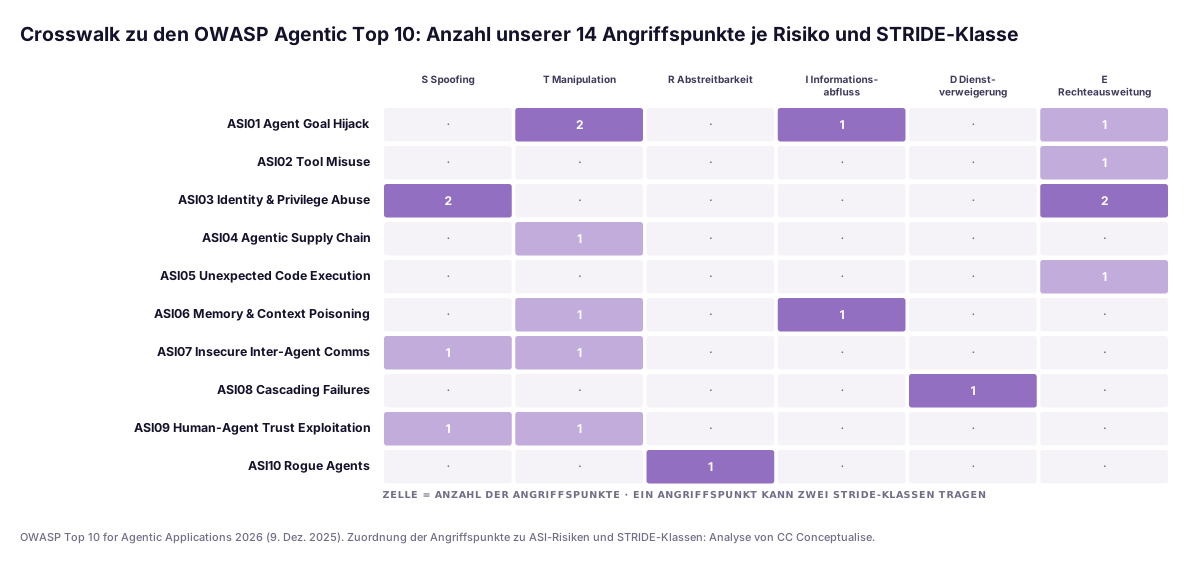
Beide Vokabulare decken dasselbe Feld ab. Tampering (sechs Punkte) und Elevation of Privilege (fünf) dominieren, wie zu erwarten, wenn die Kernschwäche eine Komponente ist, die ihrer Eingabe gehorcht. Repudiation und Denial of Service haben je einen Punkt. Sie sind selten der Einstieg, entscheiden aber, ob ein Vorfall aufklärbar ist und was er kostet.
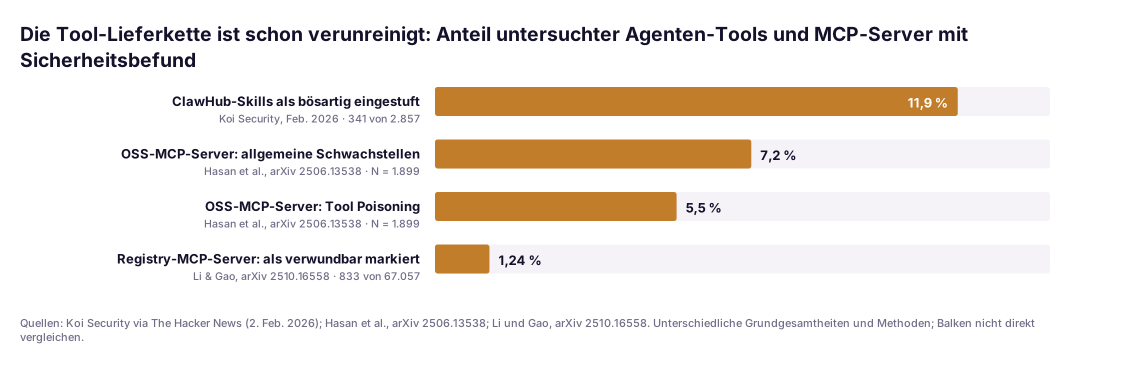
Das letzte Diagramm nutzt veröffentlichte Daten, je Balken eine benannte Quelle. Grundgesamtheiten und Methoden unterscheiden sich, vergleichen Sie die Balken also nicht miteinander. Die Aussage ist schlichter: In jeder veröffentlichten Stichprobe ist ein messbarer Anteil der Agenten-Tools verwundbar oder bösartig. Angriffspunkt ⑦ ist nicht hypothetisch.
| OWASP-Risiko (2026) | Unsere Angriffspunkte | STRIDE | Erste Kontrolle |
|---|---|---|---|
| ASI01 Agent Goal Hijack | ① ② ⑪ | T, E, I | Isolation von Fremdinhalten plus Ausgabefilter |
| ASI02 Tool Misuse | ⑧ | E | Policy am Tool-Aufruf |
| ASI03 Identity & Privilege Abuse | ③ ⑨ | S, E | Agentenidentität mit Token Exchange |
| ASI04 Agentic Supply Chain | ⑦ | T | Gepinnte, geprüfte Tool-Registry |
| ASI05 Unexpected Code Execution | ⑩ | E | Sandbox mit Egress-Allow-List |
| ASI06 Memory & Context Poisoning | ⑤ ⑥ | T, I | Herkunftsnachweis und Partitionen im Gedächtnis |
| ASI07 Insecure Inter-Agent Communication | ⑫ | S, T | Gegenseitige Authentisierung, signierte Agent Cards |
| ASI08 Cascading Failures | ⑬ | D | Budgets und Circuit Breaker |
| ASI09 Human-Agent Trust Exploitation | ④ | S, T | Vom Gateway dargestellte Freigaben |
| ASI10 Rogue Agents | ⑭ | R | Manipulationssicheres Tool-Call-Log |
Die Zuordnung stammt von uns. Manche Angriffspunkte berühren mehrere OWASP-Risiken; wir haben jeden dort eingeordnet, wo er am besten passt.
Aus einem aktuellen Projekt
In diesem Jahr haben wir die Übung für einen europäischen Finanzdienstleister durchgeführt, der einen Agenten für die Schadenbearbeitung in Produktion bringen wollte. Der Agent las Kunden-E-Mails, schlug Verträge nach, entwarf Antworten und konnte kleine Kulanzzahlungen auslösen. Der Pilot lief gut. Die Vertrauensgrenzen hatte niemand gezeichnet.
Das Zeichnen dauerte eine Arbeitssitzung und änderte den Plan. Kunden-E-Mails, per Definition vom Angreifer steuerbar, gingen direkt in den Planer und ins Langzeitgedächtnis (② und ⑤). Alle Tools liefen unter einem Dienstkonto, das sämtliche Verträge lesen konnte (⑥ und ⑨). Zahlungen brauchten eine Freigabe, aber die freigebende Person sah die Ein-Satz-Zusammenfassung des Agenten, nicht die Parameter (④). Und das Tool-Call-Log lag in der Debug-Ausgabe, die nach wenigen Tagen rotiert wurde (⑭).
Keine der Korrekturen war exotisch. Eingehende Mails liefen über einen Zusammenfasser ohne Tool-Zugriff. Die Suche wechselte auf On-Behalf-of-Tokens, begrenzt auf den Kunden im Gespräch. Die Freigabemaske zeigte Zahlungsempfänger, Betrag und Vertragsnummer aus dem Gateway. Tool-Aufrufe landeten in einem unveränderlichen Speicher. Der Go-live verschob sich um einige Wochen. Am längsten dauerte die Einigung, wem die Policy-Regeln des Gateways gehören, wenn das Projektteam weiterzieht.
Die Checkliste für das Design-Review
Das ist der Teil für den Screenshot. Nutzen Sie ihn, bevor ein Agent produktive Zugangsdaten erhält. Jede Zeile braucht eine verantwortliche Person und einen Nachweis, kein „ja“.
| # | Frage im Design-Review | Mindestkontrolle vor Produktion | Aufzubewahrender Nachweis |
|---|---|---|---|
| ① | Wenn das Modell dem Nutzer vollständig gehorcht: Was ist der schlimmste mögliche Tool-Aufruf? | Gateway-Allow-List je Nutzerrolle | Red-Team-Ergebnisse je Release |
| ② | Welche Eingaben steuert ein Angreifer, und erreichen sie den Planer? | Fremdinhalte markiert und isoliert | Datenflussdiagramm |
| ③ | Trägt jedes nachgelagerte Token Agent und Nutzer? | Identität je Agent, OBO Token Exchange | IdP-Konfiguration, Token-Stichproben |
| ④ | Was genau sieht die freigebende Person, und wer stellt es dar? | Vom Gateway dargestellte Parameter | Freigabeprotokoll |
| ⑤ | Können Fremdinhalte ins Langzeitgedächtnis geschrieben werden? | Herkunft und Validierung bei Schreibvorgängen | Audit der Schreibvorgänge |
| ⑥ | Mit wessen Rechten läuft die Suche? | Nutzerbezogene Suche, Partitionen | Zugriffstest mit zwei Nutzern |
| ⑦ | Wer hat welchen MCP-Server und Skill in welcher Version freigegeben? | Gepinnte Registry, Hashes der Beschreibungen | Registry-Export |
| ⑧ | Welche Tools sind unumkehrbar oder massenwirksam? | Parameter- und Mengenregeln, Freigaben | Policy-as-Code-Repository |
| ⑨ | Reicht ein MCP-Server Tokens durch oder hält er einen statischen Superuser-Schlüssel? | Audience-gebundene Tokens, kein Passthrough | Tests der Token-Validierung |
| ⑩ | Wo läuft generierter Code, mit welchen Zugangsdaten? | Kurzlebige Sandbox ohne implizite Zugangsdaten | Sandbox-Konfiguration |
| ⑪ | Können Ausgaben externe Bilder laden oder beliebige Hosts aufrufen? | Bereinigte Ausgaben, Egress-Allow-List | Egress-Logs |
| ⑫ | Wie prüfen wir einen Partneragenten, und was akzeptieren wir von ihm? | Gegenseitige Authentisierung, signierte Agent Cards | Partner-Registry |
| ⑬ | Was stoppt eine Aufgabe beim Hundertfachen der normalen Kosten? | Budgets und Notabschaltung | Budget-Alarme |
| ⑭ | Können wir jede Aktion in einem Jahr noch rekonstruieren? | Unveränderliches Log mit Identitätskette | Aufbewahrungsrichtlinie, Beispiel-Trace |
Zwei Warnungen. Eine Allow-List, die das Agententeam ohne Review ändern kann, ist keine Kontrolle. Stellen Sie die Gateway-Policy unter dieselbe Änderungskontrolle wie Firewall-Regeln. Und ein Red-Team-Test zum Start ist eine Momentaufnahme. Lassen Sie die Injection-Suite bei jeder Modell- oder Prompt-Änderung laufen, wie in unserem Playbook für LLM-Red-Teaming beschrieben.
Governance für europäische Unternehmen
Ein eigenes EU-„Agentengesetz“ gibt es nicht. Je nachdem, was der Agent tut und wer ihn betreibt, greifen mehrere Regelwerke.
DSGVO. Die meisten Unternehmensagenten verarbeiten personenbezogene Daten. Damit gelten Art. 32 (Sicherheit der Verarbeitung) und Art. 25 (Datenschutz durch Technikgestaltung). Die Angriffspunkte ⑥ und ⑪ sind Datenschutzverletzungen mit Ansage, samt 72-Stunden-Meldefrist nach Art. 33.
NIS2. Art. 21 Abs. 2 der Richtlinie (EU) 2022/2555 verlangt unter anderem Risikoanalyse und Sicherheitskonzepte (Buchst. a), Sicherheit der Lieferkette (d), Zugriffskontrolle und Management von Anlagen (i) sowie Multi-Faktor-Authentisierung (j). Agenten berühren alle vier. In Deutschland gilt das NIS2UmsuCG seit dem 6. Dezember 2025 ohne Übergangsfrist. Ein Agent mit produktiven Zugangsdaten gehört in Ihre Risikoanalyse, und dieses Bedrohungsmodell ist ein guter Weg, ihn dort abzubilden.
DORA. Für Finanzunternehmen ist eine gehostete Modell-API oder Agentenplattform ein IKT-Drittdienst und gehört ins Informationsregister. Ein Agentenvorfall, der eine kritische Funktion stört, kann ein schwerwiegender IKT-bezogener Vorfall sein.
KI-Verordnung. Die meisten Unternehmensagenten sind keine Hochrisiko-KI-Systeme. Ist Ihrer eines, etwa bei Kreditwürdigkeitsprüfung oder Personalauswahl nach Anhang III, verlangt Art. 15 Genauigkeit, Robustheit und Cybersicherheit, und Art. 15 Abs. 5 nennt Datenvergiftung, Modellvergiftung, gegnerische Beispiele und Angriffe auf die Vertraulichkeit ausdrücklich. Die Verordnung (EU) 2026/1744 hat diese Pflichten auf den 2. Dezember 2027 verschoben. Das ist eine Frist, kein Aufschub ohne Folgen. Die menschliche Aufsicht nach Art. 14 entspricht Angriffspunkt ④.
Cyber Resilience Act. Wer einen Agenten als Produkt mit digitalen Elementen oder als Teil eines solchen vertreibt, unterliegt seit dem 11. September 2026 der Meldepflicht nach Art. 14 für aktiv ausgenutzte Schwachstellen und schwerwiegende Sicherheitsvorfälle.
Für Unternehmen in der DACH-Region kommen die Designprinzipien von BSI und ANSSI für LLM-basierte Systeme einer nationalen Basis am nächsten. Ihre sechs Prinzipien (Authentisierung und Autorisierung, Ein- und Ausgabebeschränkungen, Sandboxing, Monitoring, Threat Intelligence und Sensibilisierung) decken sich mit den Kontrollen A, B, F, I und J unserer Heatmap. Verweisen Sie in Ihrer Designdokumentation darauf.
Ein pragmatischer Einführungspfad
- Woche 1: Agenten einzeichnen. Nehmen Sie die draw.io-Datei, löschen Sie, was Sie nicht haben, ergänzen Sie, was Sie haben, und markieren Sie jede Eingabe als vertrauenswürdig oder nicht. Die meisten Teams finden hier ihre ersten zwei Probleme.
- Wochen 2–3: Gateway vor neuen Tools. Leiten Sie jeden MCP- und A2A-Aufruf über einen Policy Enforcement Point mit Allow-List, Parameterregeln und unveränderlichem Log. Das deckt ①, ⑧ und ⑭ ab und liefert eine Nachweiskette.
- Wochen 3–4: Identität reparieren. Eine Identität je Agent, On-Behalf-of Token Exchange mit Audience-Bindung, kein Passthrough und keine statischen Superuser-Schlüssel auf MCP-Servern. Das schließt ③, ⑥ und ⑨.
- Monat 2: Fremdes isolieren. Leiten Sie angreiferkontrollierbare Inhalte über eine eingeschränkte Komponente, protokollieren Sie die Herkunft von Gedächtnis-Schreibvorgängen, bereinigen Sie Ausgaben, sandboxen Sie Codeausführung und pinnen Sie Ihre Tool-Registry.
- Monat 3: Testen und üben. Ein Red-Team-Testfall je Angriffspunkt, Budgets und Notabschaltung setzen, das Incident-Runbook für Agenten mit dem Security Operations Center einmal durchspielen. Wiederholen Sie das Bedrohungsmodell, sobald der Agent ein Tool, einen Gedächtnisspeicher oder einen Partner dazubekommt.
Das Fazit
Sicherheit für KI-Agenten ist keine neue Disziplin. Sie besteht aus Zugriffskontrolle, Lieferkettenhygiene, Sandboxing und Protokollierung, angewendet auf eine Komponente, die ihrer Eingabe gehorcht. Der häufigste Fehler, den wir sehen, ist nicht, das Modell zu unterschätzen. Es ist, das Modell zu überschätzen und Sicherheitsentscheidungen in die eine Komponente zu legen, die sie nicht halten kann.
Unsere Empfehlung ist einfach. Zeichnen Sie die Vertrauensgrenzen, gehen Sie davon aus, dass der Planer gekapert ist, und geben Sie jedem Angriffspunkt eine primäre Kontrolle, die nicht vom Wohlverhalten des Modells abhängt. Wenn Sie in diesem Quartal nur eines finanzieren, finanzieren Sie das Gateway mit Policy am Tool-Aufruf. Danach die Identität. Alles andere macht den nächsten Vorfall kleiner und leichter aufzuklären.
Wenn Sie eine zweite Meinung möchten: Unser KI-Engineering-Team führt dieses Bedrohungsmodell als Workshop mit festem Umfang für einen Agenten durch. Sie gehen mit dem ausgefüllten Diagramm für Ihre Architektur, der für Ihre Kontrollen bewerteten Heatmap und einer verantwortlichen Person für jede Lücke heraus.
FAQ
Was ist ein Bedrohungsmodell für agentische KI?
Eine strukturierte Liste der Wege, auf denen ein KI-Agent angegriffen werden kann, eingezeichnet in ein Bild seiner Komponenten und Vertrauensgrenzen: Nutzerkanal, Orchestrator mit Modell, Gedächtnis, aufgerufene Tools (meist über MCP) und Partneragenten (etwa über A2A). An jedem Grenzübertritt fragen Sie, was sich fälschen, manipulieren, abstreiten, abgreifen, überlasten oder ausweiten lässt, und benennen die Kontrolle, die den Angriff bricht. Unser Referenzmodell hat 14 Angriffspunkte an vier Vertrauensgrenzen.
Funktioniert STRIDE noch für KI-Agenten?
Ja, wenn Sie eine Annahme ändern. Klassisches STRIDE geht davon aus, dass jeder Prozess seine eigene Logik durchsetzt. Ein LLM-Planer kann das nicht: Alles, was er liest, kann zur Anweisung werden. Behandeln Sie den Planer daher als berechtigten, aber nicht vertrauenswürdigen Nutzer, wenden Sie STRIDE an jeder Grenze an, die er überschreitet, und halten Sie jede Sicherheitsentscheidung aus dem Modell heraus. MAESTRO der CSA ergänzt agentenspezifische Schichten und eignet sich als Gegenprobe.
Wie passt das zu den OWASP Top 10 for Agentic Applications?
Jedes der zehn OWASP-Risiken, von ASI01 Agent Goal Hijack bis ASI10 Rogue Agents, lässt sich mindestens einem unserer 14 Angriffspunkte zuordnen. Goal Hijack umfasst drei davon, Identity and Privilege Abuse zwei, Memory and Context Poisoning zwei. Die Crosswalk-Tabelle oben zeigt die Zuordnung und die erste Kontrolle je Risiko.
Welche Kontrolle ist für KI-Agenten am wichtigsten?
Wenn wir eine wählen müssten: Policy-Durchsetzung am Tool-Aufruf, also ein Gateway, das jeden Tool-Aufruf vor der Ausführung gegen Allow-List, Identität des Aufrufers und Parameterregeln prüft. In unserer Heatmap wirkt es auf 11 der 14 Angriffspunkte und greift auch dann noch, wenn das Modell vollständig gekapert ist. Genau für diesen Fall müssen Sie bauen.
Welche EU-Vorgaben gelten für die Sicherheit von KI-Agenten?
Art. 25 und 32 DSGVO gelten, sobald ein Agent personenbezogene Daten verarbeitet. Art. 21 NIS2 gilt für wesentliche und wichtige Einrichtungen, in Deutschland über das NIS2UmsuCG seit dem 6. Dezember 2025. DORA gilt für Finanzunternehmen. Für Hochrisiko-KI-Systeme gilt Art. 15 KI-Verordnung ab dem 2. Dezember 2027, nachdem die Verordnung (EU) 2026/1744 die Frist für Anhang III verschoben hat. Wer den Agenten als Produkt vertreibt, unterliegt seit dem 11. September 2026 den Meldepflichten des Cyber Resilience Act.
Wie lange dauert eine Bedrohungsmodellierung für einen Agenten?
Für einen Agenten mit klarem Umfang planen wir einen halbtägigen Workshop mit Product Owner, einer Entwicklerin oder einem Entwickler, die die Tool-Integrationen kennen, und jemandem aus Identity und Security Operations, danach einen Tag Ausarbeitung. Ergebnis: das ausgefüllte Diagramm für Ihren Agenten, eine priorisierte Liste der Angriffspunkte und eine verantwortliche Person je Kontrolle. Wiederholen Sie die Übung, sobald der Agent ein neues Tool, einen Gedächtnisspeicher oder einen Partner erhält.
Quellen
Alle Quellen geprüft am 15. November 2026. Stammt eine Zahl aus einem Sekundärbericht, nennen wir den Berichtenden.
Stufe A: Primärquellen, Standards und Regulierung
- CISA, ASD's ACSC, NSA, Canadian Centre for Cyber Security, NCSC-NZ, NCSC-UK, „Careful Adoption of Agentic AI Services“ (1. Mai 2026): https://www.cisa.gov/resources-tools/resources/careful-adoption-agentic-ai-services
- OWASP GenAI Security Project, „OWASP Top 10 for Agentic Applications“ (9. Dez. 2025): https://genai.owasp.org/2025/12/09/owasp-top-10-for-agentic-applications-the-benchmark-for-agentic-security-in-the-age-of-autonomous-ai/
- Model Context Protocol, Security Best Practices (2026-07-28): https://modelcontextprotocol.io/specification/2026-07-28/basic/security_best_practices
- Model Context Protocol, Authorization (2026-07-28): https://modelcontextprotocol.io/specification/2026-07-28/basic/authorization
- A2A-Protokoll, Spezifikation (Release v1.0.0, 12. März 2026): https://a2a-protocol.org/latest/specification/
- NIST NCCoE, „Accelerating the Adoption of Software and AI Agent Identity and Authorization“, Konzeptpapier (Feb. 2026): https://www.nccoe.nist.gov/publications/other/accelerating-adoption-software-and-ai-agent-identity-and-authorization-concept
- BSI und ANSSI, „Design Principles for LLM-based Systems with Zero Trust“ (11. Aug. 2025): https://www.bsi.bund.de/SharedDocs/Downloads/EN/BSI/Publications/ANSSI-BSI-joint-releases/LLM-based_Systems_Zero_Trust.html
- JFrog Security Advisory, CVE-2025-6514 (mcp-remote): https://research.jfrog.com/vulnerabilities/mcp-remote-command-injection-rce-jfsa-2025-001290844/
- Verordnung (EU) 2024/1689 (KI-Verordnung), Art. 14 und 15: https://eur-lex.europa.eu/eli/reg/2024/1689/oj/deu
- Richtlinie (EU) 2022/2555 (NIS2), Art. 21: https://eur-lex.europa.eu/eli/dir/2022/2555/oj/deu
- Verordnung (EU) 2022/2554 (DORA): https://eur-lex.europa.eu/eli/reg/2022/2554/oj/deu
- Verordnung (EU) 2024/2847 (Cyber Resilience Act), Art. 14: https://eur-lex.europa.eu/eli/reg/2024/2847/oj/deu
- Verordnung (EU) 2016/679 (DSGVO), Art. 25, 32 und 33: https://eur-lex.europa.eu/eli/reg/2016/679/oj/deu
Stufe B: Forschung und Analyse
- Anthropic, „Disrupting the first reported AI-orchestrated cyber espionage campaign“ (Nov. 2025): https://www.anthropic.com/news/disrupting-AI-espionage
- Hasan et al., „Model Context Protocol (MCP) at First Glance“, arXiv 2506.13538 (v5, Apr. 2026): https://arxiv.org/abs/2506.13538
- Li und Gao, „A First Look at the Security Issues in the Model Context Protocol Ecosystem“, arXiv 2510.16558 (v2, Apr. 2026): https://arxiv.org/abs/2510.16558
- Invariant Labs, Offenlegung des Toxic Agent Flow im GitHub-MCP-Server (26. Mai 2025): https://invariantlabs.ai/blog/mcp-github-vulnerability
- OX Security, „The Mother of All AI Supply Chains“ (Apr. 2026): https://www.ox.security/research-news/the-mother-of-all-ai-supply-chains-critical-systemic-vulnerability-at-the-core-of-the-mcp/
- Cloud Security Alliance, „MCP Security: Tool Poisoning and the Confused Deputy Problem“ (16. Mai 2026, KI-gestützte Kurzstudie): https://labs.cloudsecurityalliance.org/wp-content/uploads/2026/05/CSA_whitepaper_mcp_security_agentic_attack_surface_20260516-csa-styled.pdf
- Cloud Security Alliance, „Agentic AI Threat Modeling Framework: MAESTRO“ (Feb. 2025): https://cloudsecurityalliance.org/articles/agentic-ai-threat-modeling-framework-maestro
- Gartner, „Gartner Identifies the Top Cybersecurity Trends for 2026“ (Feb. 2026): https://www.gartner.com/en/newsroom/press-releases/2026-02-05-gartner-identifies-the-top-cybersecurity-trends-for-2026
Stufe C: Anbieter und Nachrichten, richtungsweisend
- The Hacker News, EchoLeak in Microsoft 365 Copilot (Juni 2025): https://thehackernews.com/2025/06/zero-click-ai-vulnerability-exposes.html
- The Hacker News, erster bösartiger MCP-Server (postmark-mcp, Sept. 2025): https://thehackernews.com/2025/09/first-malicious-mcp-server-found.html
- The Hacker News, 341 bösartige ClawHub-Skills (Koi Security, 2. Feb. 2026): https://thehackernews.com/2026/02/researchers-find-341-malicious-clawhub.html
- SecurityBrief UK, Zusammenfassung der Gartner-Cybersecurity-Trends 2026: https://securitybrief.co.uk/story/ai-regulation-quantum-top-gartner-cyber-trends-for-2026
Themen