KI-Entwicklerproduktivität ehrlich messen: DORA & SPACE
Entwickler fühlen sich mit KI schneller, Studien widersprechen. So messen Sie KI-Produktivität ehrlich: mit Telemetrie, DORA, SPACE und Experimenten.
Im Juli 2025 veröffentlichte METR die unbequemste Grafik unserer Branche. Sechzehn erfahrene Open-Source-Entwickler bearbeiteten 246 echte Issues in Repositories, die sie gut kannten. Jedes Issue wurde zufällig „KI erlaubt" oder „KI nicht erlaubt" zugeordnet. Vorab erwarteten die Entwickler, dass KI ihre Bearbeitungszeit um 24 % senkt. Hinterher glaubten sie an 20 %. Die Stoppuhr sagte das Gegenteil: Mit KI dauerten die Aufgaben 19 % länger. Ökonomen und Machine-Learning-Fachleute, die das Ergebnis vorhersagen sollten, hatten 38 bis 39 % Beschleunigung prognostiziert.
Sechzehn Monate später haben die meisten Unternehmen KI-Coding-Assistenten und -Agenten trotzdem ausgerollt. Die Budgets für 2027 entstehen jetzt, und jemand muss die Frage des CFO beantworten: Was haben wir dafür bekommen? Dieser Artikel richtet sich an alle, die diese Frage ehrlich beantworten müssen: CTOs, Engineering-Leitungen, Plattformverantwortliche und Architekten, die „mal eben ein Dashboard bauen" sollen. Wir zeigen einen vierschichtigen Mess-Stack, ordnen die veröffentlichte Evidenz ein und erklären, wie Sie die Messung in einem deutschen Unternehmen aufsetzen, ohne mit dem Betriebsverfassungsrecht zu kollidieren.
TL;DR / Das Wichtigste in Kürze
- Gefühlt schneller ist nicht gemessen schneller. In METRs Studie von 2025 hielten sich Entwickler für 20 % schneller und waren 19 % langsamer. In GitHubs Studie von 2022 unterschätzten sie einen Gewinn von 55,8 %. Selbstauskunft ist ein Signal, keine Stoppuhr.
- Die Evidenz ist wirklich gemischt. Kontrollierte Studien reichen von 19 % langsamer bis 55,8 % schneller. Den Ausschlag geben Aufgabentyp, Codebasis, Vertrautheit und Tool-Generation.
- Nutzungstelemetrie ist keine Produktivität. Akzeptanzraten, Tokens und KI-erstellte PRs zeigen, dass die Tools genutzt werden, nicht, ob Kundennutzen früher ankommt.
- Vier Schichten messen, dann experimentieren. Telemetrie, DORA-Metriken, SPACE-Erfahrungsmetriken und Geschäftsergebnisse, verbunden durch einen gestaffelten Rollout mit Kontrollgruppe.
- In Deutschland ist Messung mitbestimmungspflichtig. Telemetrie, die individuelle Leistung zeigen kann, fällt unter § 87 Abs. 1 Nr. 6 BetrVG. Planen Sie die Aggregation auf Teamebene vom ersten Tag an ein.

Download: Editierbare draw.io-Datei · In diagrams.net öffnen · Diagrammdaten (CSV)
Warum diese Debatte jetzt zählt
Ob KI genutzt wird, ist keine Frage mehr. Googles DORA-Report 2025, basierend auf knapp 5.000 Fachleuten, beziffert die KI-Nutzung auf 90 %, ein Plus von 14 % gegenüber dem Vorjahr, bei einer täglichen Nutzung von im Median zwei Stunden. In der Stack-Overflow-Umfrage 2026 nutzen 73 % täglich Coding-Assistenten und -Agenten. Die Tools sind da, die Lizenzen verlängern sich.
Was fehlt, ist der Nachweis, dass die Organisation besser dasteht. Laut DORA 2025 sagen über 80 % der Befragten, KI habe ihre Produktivität erhöht. KI-Nutzung geht inzwischen mit höherem Delivery-Durchsatz einher, eine Umkehr gegenüber 2024, aber weiterhin auch mit höherer Instabilität. Ein Jahr zuvor hatte DORA geschätzt, dass mit steigender KI-Nutzung der Durchsatz um 1,5 % und die Stabilität um 7,2 % sank. Beide Reports erzählen dieselbe Geschichte: Einzelne fühlen sich schneller, das System liefert nicht automatisch bessere Software.
Gleichzeitig hat sich die Art der Nutzung verändert. 2025 dominierten Autovervollständigung und Chat; Ende 2026 betreiben viele Teams Coding-Agenten, die selbstständig Pull Requests öffnen. Das bricht die alten Metriken doppelt. Aktivitätsmetriken explodieren, weil ein Agent an einem Nachmittag mehr Commits erzeugt als früher ein Team in einer Woche. Und Zeiterfassung funktioniert nicht mehr: METR berichtete im Februar 2026, dass sich die Zeit von Entwicklern, die mehrere Agenten parallel laufen ließen, nicht mehr verlässlich erfassen ließ. Wer noch Codezeilen zählt oder „gesparte Stunden" per Umfrage erhebt, misst an der Realität vorbei.
Es gibt einen weiteren Grund, 2027 sauber zu messen: Produktivitätszahlen fließen in Personalentscheidungen. Stammt die Zahl hinter einem Einstellungsstopp aus einem Hersteller-Dashboard oder einer Selbstauskunft, trifft die Organisation eine teure Entscheidung auf schlechter Grundlage. Wir haben bereits argumentiert, dass der Entwicklermangel in Deutschland nicht allein durch KI gelöst wird.
Der Mess-Stack, Schicht für Schicht
Das Hero-Diagramm liest sich von unten nach oben. Jede Schicht beantwortet eine andere Frage, und jede hat ihre typische Art, Sie in die Irre zu führen. Die Nummern in den Überschriften entsprechen den Markierungen im Diagramm.
① Telemetrie der KI-Tools: Nutzung, nicht Produktivität
Die unterste Schicht liefern die Hersteller gratis: aktive Nutzer, Nutzungstage, Akzeptanzrate der Vorschläge, Chat- und Agenten-Sessions, KI-erstellte Pull Requests, Tokens und Kosten. Alle großen Assistenten stellen das in irgendeiner Form über Admin-Dashboards oder APIs bereit.
Diese Schicht beantwortet eine Frage gut: Wird genutzt, was wir gekauft haben? Eine ungenutzte Lizenz ist reiner Kostenblock, und ein Team, das ein Tool ausprobiert und wieder aufgegeben hat, sagt etwas über die Passung.
Über Produktivität sagt sie nichts. Die Akzeptanzrate ist die klassische Falle: Ein Vorschlag, der übernommen und dann umgeschrieben wird oder nächsten Monat einen Bug verursacht, zählt trotzdem als Erfolg. Token-Verbrauch ist noch schlechter. Er misst Maschinenaufwand und steigt, wenn Agenten in Schleifen laufen, wiederholen oder abschweifen. DORA hat dazu sogar einen Beitrag mit dem Titel „Finding balance in the era of tokenmaxxing" veröffentlicht. Unsere Regel: Telemetrie gehört auf ein Nutzungs-Dashboard, als solches beschriftet, und nie auf eine Folie mit dem Titel „Produktivität".
Eine wichtige Aufgabe hat die Telemetrie trotzdem: Sie zeigt, wer die Behandlung erhalten hat. Ohne sie können Sie Intensivnutzer nicht von Lizenzinhabern unterscheiden, die das Tool nie öffnen, und jeder Vergleich in den oberen Schichten verschwimmt.
② Software-Delivery: die fünf DORA-Metriken
Die zweite Schicht fragt, ob mehr Änderungen in Produktion kommen, und ob das sicher geschieht. DORA definiert aktuell fünf Delivery-Metriken in zwei Gruppen:
- Durchsatz: Change Lead Time (vom Commit bis zum Betrieb in Produktion), Deployment-Häufigkeit und Recovery-Zeit nach fehlgeschlagenem Deployment.
- Instabilität: Change-Fehlerrate (Deployments, die dringende Nacharbeit wie Rollback oder Hotfix erfordern) und Deployment-Nacharbeitsquote (ungeplante Deployments infolge eines Produktionsvorfalls).
Für die KI-Messung eignen sie sich aus drei Gründen. Sie messen auf Systemebene und erfassen damit die Review- und Integrationsengpässe, in die individuelle Beschleunigung die Arbeit verschiebt. Sie enthalten ein Qualitätsgegengewicht, sodass „schneller" nicht durch mehr Fehler gewinnen kann. Und jede Organisation mit CI/CD-Pipeline kann sie aus vorhandenen Daten berechnen.
Sie haben Grenzen. Sie sind nachlaufend und verrauscht, ein vierwöchiger Pilot bewegt sie selten überzeugend. Sie übersehen Arbeit, die nie zu einem Deployment führt, und lassen sich leicht manipulieren, sobald sie zu Zielvorgaben werden. Nutzen Sie sie als Trend im Gruppenvergleich, nicht als Anzeigetafel. DORA selbst hat 2025 ein KI-Fähigkeitenmodell mit sieben Praktiken vorgelegt, darunter kleine Batches, starke Versionskontrolle und hochwertige interne Plattformen. Liegen Ihre Delivery-Daten in einem Dutzend Tools, zahlt sich hier eine interne Entwicklerplattform aus: eine Pipeline, ein Ereignisstrom, eine Definition.
③ Developer Experience: SPACE und die Umfrage, die Sie brauchen
Die dritte Schicht fragt, wie sich die Arbeit anfühlt und wo sie fließt. Das SPACE-Framework, 2021 von Nicole Forsgren, Margaret-Anne Storey und Kollegen in ACM Queue veröffentlicht, benennt fünf Dimensionen: Satisfaction and well-being (Zufriedenheit und Wohlbefinden), Performance (Ergebnisqualität), Activity (Aktivität), Communication and collaboration (Zusammenarbeit) sowie Efficiency and flow (Effizienz und Flow). Kernaussage: Produktivität lässt sich nicht mit einer Metrik erfassen. Messen Sie über mehrere Dimensionen und kombinieren Sie Systemdaten mit dem, was Menschen berichten.
Für KI fängt diese Schicht die Effekte, die Delivery-Metriken verbergen. Ertrinken Reviewer in größeren Pull Requests? Verstehen Entwickler den Code, den sie jetzt verantworten? Steigt die Unterbrechungszeit, weil Agenten Aufsicht brauchen? Atlassians Developer-Experience-Umfrage 2025 unter 3.500 Entwicklern und Führungskräften ergab: 68 % sparen mit KI mehr als 10 Stunden pro Woche, aber 50 % verlieren 10 Stunden oder mehr an Reibung außerhalb des Codings. Ein typischer SPACE-Befund: Die gesparte Zeit versickert anderswo.
Führen Sie eine kurze Umfrage durch, höchstens quartalsweise, immer mit denselben Fragen, und stellen Sie eine Frage zur gefühlten Geschwindigkeit. Sie misst keine Geschwindigkeit, aber die Lücke zwischen gefühlter und gemessener Geschwindigkeit gehört zu den aufschlussreichsten Zahlen, die Sie erzeugen können. Wie wir unten zeigen, kann sie in beide Richtungen groß sein.
④ Geschäftsergebnisse: wofür die Organisation tatsächlich zahlt
Die oberste Schicht interessiert den Vorstand und fehlt in Engineering-Dashboards meistens: Durchlaufzeit von der Idee bis zum Kundennutzen, Kosten pro ausgelieferter Änderung, kundenwirksame Störungen, umgesetzte Roadmap-Punkte pro Quartal. Diese Größen sind träge und von viel mehr als KI beeinflusst. Genau deshalb zählen sie: Wenn zwei Quartale schnelleres Coding die Time-to-Value nicht verändern, liegt der Engpass nicht im Code.
Die Telemetriestudie von Faros AI aus 2025 mit über 10.000 Entwicklern in 1.255 Teams zeigt das deutlich. Teams mit hoher KI-Nutzung erledigten 21 % mehr Aufgaben und mergten 98 % mehr Pull Requests, doch auf Unternehmensebene fand die Studie keinen signifikanten Zusammenhang zwischen KI-Nutzung und Verbesserungen. Die Gewinne waren lokal real und verpufften in der Summe. Wer bei Schicht ② oder darunter aufhört, sieht das nie.
Verknüpfen Sie diese Schicht mit Geld. Unser Ansatz, technische Schulden in Euro zu beziffern, funktioniert auch hier: Drücken Sie das Ergebnis als Kosten pro Änderung oder vermiedene Verzögerungskosten aus, nicht als „gesparte Entwicklerstunden".
⑤ Die Kausalschicht: Experimente statt Dashboards
Ein Dashboard kann zeigen, dass KI-nutzende Teams schneller liefern. Es kann nicht zeigen, dass KI der Grund ist. Starke Teams führen neue Werkzeuge zuerst ein, Greenfield-Teams sehen größere Gewinne. Ohne Vergleichsgruppe messen Sie Begeisterung und Kontext, keinen Effekt.
Jede belastbare Zahl in diesem Artikel stammt aus einem randomisierten Design. METR randomisierte einzelne Aufgaben, GitHub randomisierte Entwickler, Microsoft, Accenture und ein anonymes Fortune-100-Unternehmen randomisierten den Zugang. Das geht im Unternehmen mit überschaubarem Aufwand:
- Gestaffelter Rollout. Schalten Sie Teams in zufällig zugeteilten Wellen frei. Bis ein Team Zugang hat, ist es Kontrollgruppe. Niemand verliert ein Werkzeug, und nach 12 bis 16 Wochen haben Sie einen sauberen Vergleich.
- Kontrollgruppe beim Upgrade. Lassen Sie eine kleine, zufällig gewählte Gruppe von Teams ein Quartal lang auf der bisherigen Tool-Generation, etwa beim Wechsel vom Assistenten zum Agenten.
- Vorab-Registrierung. Halten Sie Metriken, Vergleich und Entscheidungsregel vor dem Start schriftlich fest. Das ist der billigste Schutz vor Selbsttäuschung.
Die METR-Folgestudie zeigt, wie fragil das ist. In der zweiten Studie, gestartet im August 2025 mit 57 Entwicklern, wurde die Rekrutierung schwieriger, weil immer mehr Entwickler nicht ohne KI arbeiten wollten; 30 bis 50 % der Befragten gaben an, manche Aufgaben aus diesem Grund gar nicht erst eingereicht zu haben. METR nennt die neuen Daten „an unreliable signal". Im Unternehmen haben Sie den Vorteil eines laufenden Rollouts: Sie verlangen von niemandem, auf KI zu verzichten, nur auf die eigene Welle zu warten.
⑥ Die Leitplanke: pro Team aggregieren, niemals Personen ranken
Die gestrichelte grüne Grenze im Diagramm ist keine Dekoration. Jede Schicht lässt sich pro Person berechnen. Sobald das passiert, optimieren Menschen die Metrik statt der Arbeit, die Daten werden zur Leistungsüberwachung, und Sie brauchen die Zustimmung des Betriebsrats für etwas, das bereits gebaut ist.
DORA-Metriken beschreiben Teams und die Services, die sie liefern, nicht Einzelpersonen, und das EU-Recht weist in dieselbe Richtung (siehe Governance-Abschnitt). Unser Standarddesign aggregiert auf Teamebene mit Mindestgruppengröße, hält Klar-Identitäten aus dem Analysespeicher heraus und verankert den Zweck im Datenmodell. Das kostet vorab fast nichts. Nachrüsten kostet Monate.
Was die Zahlen sagen
Wir haben die veröffentlichten Studien zusammengetragen, die den Effekt von KI auf die Entwicklungsgeschwindigkeit gegen eine Kontrollgruppe gemessen haben, und die eigenen Schätzungen der Entwickler ergänzt, wo eine Studie sie erfasst hat. Die Grafik nutzt ausschließlich diese Veröffentlichungen. Einen eigenen Benchmark haben wir nicht durchgeführt; unser Beitrag ist der Vergleich und die Methode.
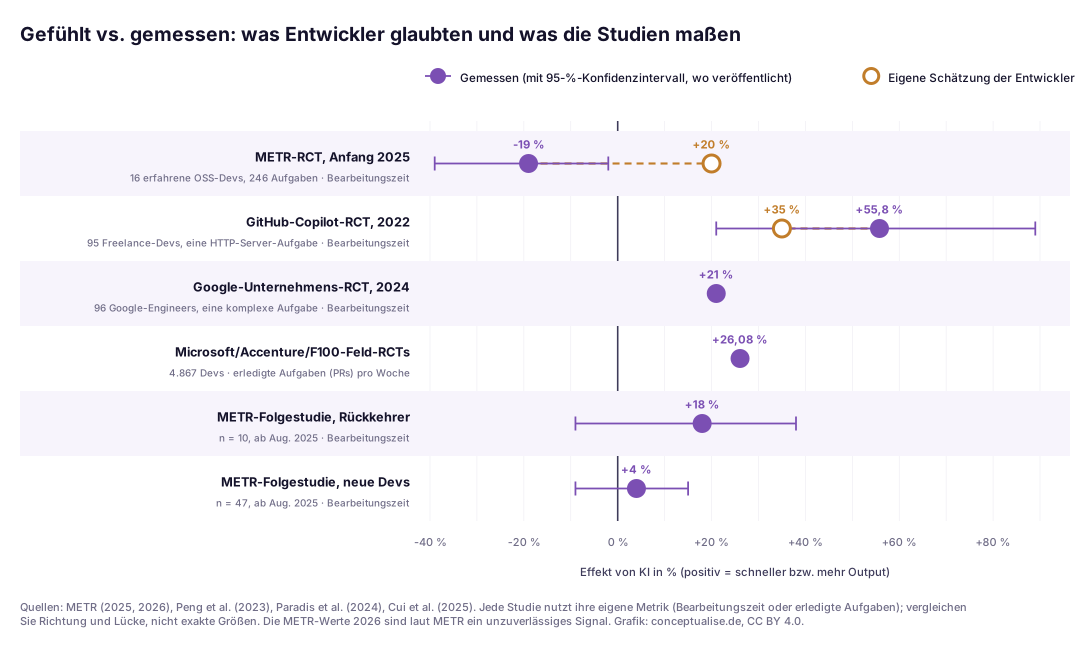
Drei Befunde stechen heraus.
Erstens: Die Streuung ist enorm, und sie ist kein Rauschen. Die 55,8 % stammen von 95 Freelance-Entwicklern, die 2022 einen HTTP-Server in JavaScript von Grund auf bauten. Die minus 19 % stammen von 16 Entwicklern mit jahrelanger Mitarbeit an Repositories mit im Schnitt über 22.000 Sternen und mehr als einer Million Codezeilen, die Anfang 2025 Cursor Pro mit Claude 3.5 und 3.7 Sonnet nutzten. Googles interne Studie mit 96 Engineers an einer komplexen Unternehmensaufgabe landete bei rund 21 %, mit breitem Intervall. Die Feldexperimente mit 4.867 Entwicklern bei Microsoft, Accenture und einem Fortune-100-Unternehmen fanden 26,08 % mehr erledigte Aufgaben pro Woche, mit größeren Gewinnen für weniger erfahrene Entwickler. Greenfield, klein und unbekannt begünstigt KI. Groß, gewachsen und bestens vertraut tat es nicht, zumindest mit den Tools von Anfang 2025.
Zweitens: Die Wahrnehmungslücke verläuft in beide Richtungen. METRs Entwickler überschätzten ihre Geschwindigkeit um rund 40 Prozentpunkte, GitHubs Teilnehmende unterschätzten ihre um etwa 20. Menschen beurteilen ihre eigene Geschwindigkeit mit einem neuen Werkzeug schlecht, in beide Richtungen. Eine Umfrage „Wie viel Zeit spart Ihnen KI?" liefert ein Gefühl, und auf ein Gefühl sollte niemand eine Personalplanung bauen.
Drittens: Die neuesten Daten sind die unsichersten. METRs Folgestudie von 2026 schätzt 18 % weniger Bearbeitungszeit für die zehn zurückgekehrten Entwickler und 4 % für die 47 neuen. Beide Konfidenzintervalle schließen null ein, und METR selbst nennt die Schätzung wegen Selektionseffekten einen schlechten Indikator. Zugleich hält METR es für wahrscheinlich, dass Entwickler heute stärker beschleunigt werden als Anfang 2025, und das sehen wir auch so. Genau deshalb brauchen Sie eigene Messungen statt geliehener Zahlen.
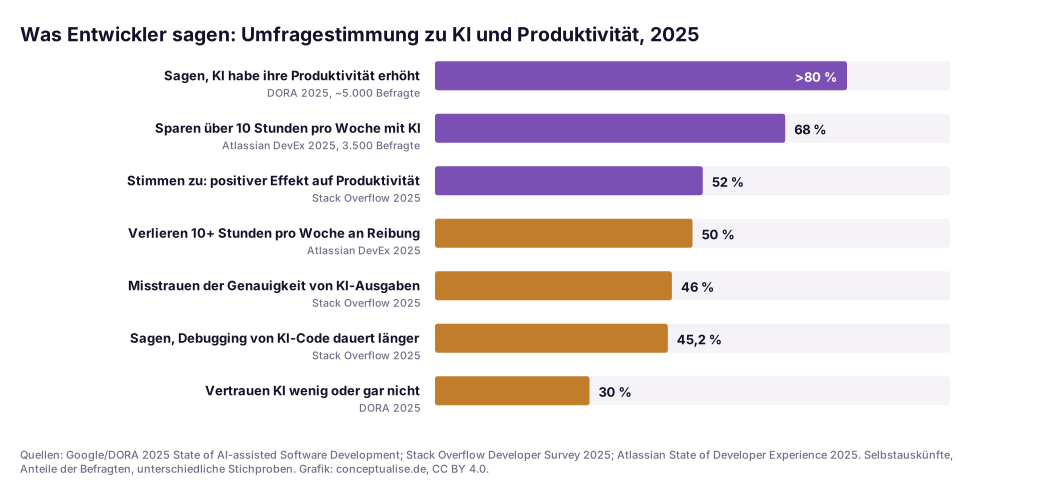
Die Umfragen erzählen konsistent von hoher Nutzung, hohem gefühltem Nutzen und geringem Vertrauen. Über 80 % der DORA-Befragten sagen, KI habe ihre Produktivität erhöht. In der Stack-Overflow-Umfrage 2025 berichten 52 % einen positiven Produktivitätseffekt, doch 46 % misstrauen der Genauigkeit von KI-Ausgaben, 66 % ärgern sich über Lösungen, die „fast richtig, aber eben nicht ganz" sind, und 45,2 % sagen, das Debugging von KI-Code dauere länger. Die positive Grundstimmung sank auf 60 %, nach über 70 % in den Jahren 2023 und 2024. Nichts davon misst Geschwindigkeit. Es beschreibt eine Belegschaft, die die Tools mag und ihnen nicht ganz traut, und genau dort klaffen Wahrnehmung und Messung auseinander.
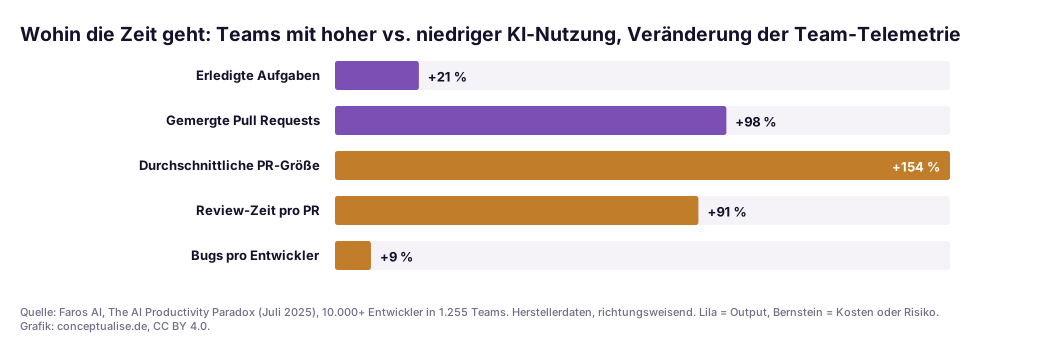
Die dritte Grafik zeigt, wohin die Zeit geht. In der Telemetrie von Faros AI stieg der Output: 21 % mehr erledigte Aufgaben, 98 % mehr gemergte Pull Requests. Gleichzeitig wuchs die durchschnittliche PR-Größe um 154 %, die Review-Zeit pro PR um 91 % und die Zahl der Bugs pro Entwickler um 9 %. Das sind Herstellerdaten eines Anbieters von Engineering-Analytics, also richtungsweisend. Das Muster deckt sich mit unserer Praxis: KI verlagert den Engpass vom Schreiben zum Review. GitClears Analyse von 211 Millionen geänderten Codezeilen zeigt Ähnliches von der Codeseite: Zwischen 2021 und 2024 stieg der Anteil geklonter Zeilen von 8,3 % auf 12,3 %, während der Anteil der Zeilen aus Refactoring von 25 % auf unter 10 % fiel.
Ein weiterer Befund betrifft gar nicht die Geschwindigkeit. Im Januar 2026 veröffentlichte Anthropic eine randomisierte Studie mit 52 überwiegend jungen Engineers, die eine unbekannte Python-Bibliothek (Trio) lernten. Die KI-Gruppe war rund zwei Minuten schneller, statistisch nicht signifikant, erzielte im anschließenden Quiz aber 50 % gegenüber 67 % bei der Gruppe, die von Hand programmierte. Ohne eine Kompetenzdimension in Ihrer Messung sehen Sie diese Kosten erst nach Jahren.
Aus einem aktuellen Projekt
In diesem Jahr haben wir ein mittelgroßes europäisches Softwareunternehmen bei der Budgetplanung 2027 für KI-Entwicklungstools begleitet. Die Engineering-Leitung hatte ein Dashboard ihres Assistenten-Anbieters: hohe wöchentliche Nutzung, ordentliche Akzeptanzrate und eine Schätzung „gesparter Stunden", abgeleitet aus übernommenen Vorschlägen. Das Controlling kannte die Stundenzahl und wollte wissen, warum sich der Einstellungsplan nicht verändert hatte.
Wir haben dem Dashboard nicht widersprochen, sondern die Schichten darüber ergänzt. Die Pipeline-Daten zeigten eine praktisch unveränderte Change Lead Time in den zwei Quartalen seit dem Rollout, bei spürbar größeren Pull Requests. Eine kurze SPACE-Umfrage zeigte: Entwickler fühlten sich schneller, Reviewer überlastet. Senior Engineers verbrachten einen wachsenden Teil ihrer Woche mit dem Review von Änderungen, die sie nicht geschrieben hatten und denen sie nicht ganz trauten. Der Engpass war vom Schreiben ins Review gewandert, und die Review-Kapazität war gleich geblieben.
Die Lösung war vor allem organisatorisch. Das Unternehmen führte eine Größengrenze und eine strukturierte Beschreibung für KI-gestützte Pull Requests ein, automatisierte Routineprüfungen, die bei den Senior-Reviewern gelandet waren, und plante das nächste Upgrade vom Assistenten zum Agenten als gestaffelten Rollout in drei Wellen. Die „gesparten Stunden" verschwanden aus der Vorstandsvorlage. An ihre Stelle traten Lead Time, Change-Fehlerrate und Review-Last im Vergleich freigeschalteter und noch nicht freigeschalteter Teams. Der Betriebsrat stimmte dem Design zügig zu, vor allem, weil die Aggregation auf Teamebene von Anfang an eingebaut war.
Die Entscheidungstabelle: welche Frage, welche Metrik
Das ist der Teil für den Screenshot. Beginnen Sie bei der Frage, die tatsächlich gestellt wird, und wählen Sie die Schicht, die sie beantworten kann.
| Gestellte Frage | Schicht | Metriken, die antworten | Metriken, die nicht antworten | Typische Falle |
|---|---|---|---|---|
| Wird genutzt, was wir gekauft haben? | ① Telemetrie | Aktive Nutzer, Nutzungstage, Sessions pro Nutzer, Lizenzauslastung | Akzeptanzrate als „Beschleunigung" | Nutzung mit Wert verwechseln |
| Kommt mehr Änderung in Produktion? | ② DORA-Durchsatz | Change Lead Time, Deployment-Häufigkeit, Recovery-Zeit | Commits, PR-Anzahl, Codezeilen | Agenten blähen Aktivität auf |
| Liefern wir mehr Fehler aus? | ② DORA-Instabilität | Change-Fehlerrate, Deployment-Nacharbeitsquote, entkommene Fehler | „Von KI-Review gefundene Bugs" | Tempo, bezahlt mit Nacharbeit |
| Wohin ist der Engpass gewandert? | ② + ③ | Review-Zeit pro PR, PR-Größe, Wartezeit im Review, Unterbrechungen | Individuelle Zykluszeit | Seniors tragen die Review-Last |
| Wie fühlt sich die Arbeit an? | ③ SPACE | Quartalsumfrage: Zufriedenheit, Flow, kognitive Last, gefühltes Tempo | Einmalige „Stunden gespart"-Umfrage | Wahrnehmung für Messung halten |
| Lernen Entwickler noch? | ③ SPACE | Einarbeitungszeit, Sicherheit im eigenen Code, Kompetenzchecks für Juniors | Output von Juniors allein | Kurzfristig Tempo, langfristig Kompetenzschulden |
| Hat das Geschäft mehr bekommen? | ④ Ergebnisse | Time-to-Value, Kosten pro Änderung, Roadmap-Erfüllung, Störungen | Gesparte Stunden × Stundensatz | Lokale Gewinne verpuffen in der Summe |
| Hat KI die Veränderung verursacht? | ⑤ Experiment | Gestaffelter Rollout oder Kontrollgruppe, vorab registrierte Metriken | Vorher-nachher über alle Teams | Early Adopter sind die stärkeren Teams |
Zwei Regeln gelten für die gesamte Tabelle. Erstens: Berichten Sie jede Metrik pro Team und als Gruppenvergleich, nie pro Person. Zweitens: Veröffentlichen Sie die Wahrnehmungslücke, also die Schätzung der Entwickler neben den Delivery-Daten. Das kalibriert die Erwartungen der Führung am schnellsten, und Entwickler finden es eher spannend als bedrohlich.
Governance für europäische Unternehmen
In der EU berührt die Messung von Entwicklerproduktivität Arbeitsrecht, Datenschutz und ab Ende 2027 die KI-Regulierung.
Betriebsverfassungsgesetz. Nach § 87 Abs. 1 Nr. 6 BetrVG bestimmt der Betriebsrat mit bei der Einführung und Anwendung technischer Einrichtungen, die dazu bestimmt sind, das Verhalten oder die Leistung der Arbeitnehmer zu überwachen. Die Arbeitsgerichte legen „bestimmt" seit Langem als „objektiv geeignet" aus. Entscheidend ist also nicht, was Sie mit den Daten vorhaben, sondern was das System könnte. Admin-Telemetrie von KI-Assistenten, Git-Analytics, IDE-Plug-ins und Engineering-Intelligence-Plattformen fallen fast immer darunter. Praktische Folge ist eine Betriebsvereinbarung, die Zweck, Daten, Aggregationsebene, Speicherfristen und Zugriffe festlegt und individuelle Leistungsbewertung ausschließt. In Österreich enthält das Arbeitsverfassungsgesetz vergleichbare Zustimmungsregeln für Kontrollmaßnahmen. Planen Sie vier bis acht Wochen ein und binden Sie den Betriebsrat vor dem Pilot ein, nicht nachdem das Dashboard existiert.
DSGVO. Telemetrie, die an das Konto eines Entwicklers gebunden ist, ist personenbezogen. Sie brauchen eine Rechtsgrundlage, Zweckbindung und Datenminimierung. Beschäftigtendaten laufen in Deutschland über § 26 BDSG und sehr häufig über eine Betriebsvereinbarung, die Art. 88 DSGVO als spezifischere Vorschrift zulässt, sofern sie dessen Schutzanforderungen erfüllt. Eine systematische, umfangreiche Überwachung von Beschäftigten ist ein typischer Auslöser für eine Datenschutz-Folgenabschätzung nach Art. 35 DSGVO. Aggregation auf Teamebene, pseudonymisierte Kennungen und kurze Speicherfristen vereinfachen all das erheblich.
KI-Verordnung. Anhang III Nr. 4 Buchstabe b stuft KI-Systeme als hochriskant ein, die bestimmungsgemäß Leistung und Verhalten von Personen in Arbeitsverhältnissen überwachen und bewerten oder Entscheidungen über Beförderung oder Kündigung treffen sollen. Ein Coding-Assistent ist kein solches System. Ein KI-gestütztes Analysetool, das die Produktivität einzelner Entwickler bewertet, könnte es sein. Die Pflichten für Anhang-III-Systeme wurden durch die Verordnung (EU) 2026/1744 auf den 2. Dezember 2027 verschoben, akut ist also noch nichts. Wer 2027 eine „Engineering-Intelligence"-Plattform einkauft, sollte trotzdem prüfen, was sie auf Personenebene tut: Art. 26 Abs. 7 verpflichtet Arbeitgeber dann, Arbeitnehmervertretungen und betroffene Beschäftigte vor dem Einsatz zu informieren. Die Pflicht zur KI-Kompetenz nach Art. 4 gilt bereits seit Februar 2025.
Der rote Faden ist Markierung ⑥: Teams messen, nicht Personen. Wenn Ihr Betriebsmodell für KI noch Form annimmt, klärt unser Beitrag zum KI-Betriebsmodell: CoE, föderiert oder Plattformteam, wem diese Messung gehören sollte.
Ein pragmatischer Einführungspfad
- Woche 1–2: Dashboards trennen. Verschieben Sie Hersteller-Telemetrie auf ein Nutzungs-Dashboard und streichen Sie „gesparte Stunden" und Akzeptanzrate aus jedem Produktivitätsbericht. Halten Sie schriftlich fest, welche Frage welche Schicht beantwortet.
- Woche 2–8: Baseline und Betriebsvereinbarung. Berechnen Sie die fünf DORA-Metriken pro Team aus Ihren Pipelines, dazu Review-Zeit und PR-Größe. Führen Sie die erste SPACE-Umfrage durch, inklusive Frage zum gefühlten Tempo. Stimmen Sie parallel das Messdesign mit Betriebsrat und Datenschutzbeauftragten ab: Teamebene, Mindestgruppengröße, Zweck und Speicherfristen.
- Woche 8–20: gestaffelter Rollout. Verteilen Sie Teams beim nächsten Tool-Wechsel, etwa vom Assistenten zum Agenten, zufällig auf drei Wellen. Registrieren Sie Metriken und Entscheidungsregel vorab. Vergleichen Sie an jeder Wellengrenze freigeschaltete und noch nicht freigeschaltete Teams. Unser Leitfaden zum Absichern von KI-Coding-Agenten im SDLC beschreibt die Leitplanken, die jede Welle braucht, bevor Agenten Pull Requests öffnen dürfen.
- Woche 20: den verlagerten Engpass beheben. Rechnen Sie mit dem Review als Engpass. Führen Sie Größengrenzen für KI-gestützte PRs ein, automatisieren Sie Routineprüfungen und messen Sie Review-Last als eigene Metrik. Verfolgen Sie Einarbeitung und Kompetenzaufbau von Juniors ausdrücklich.
- Quartalsweise: den Stack berichten, nicht eine Zahl. Eine Seite: Nutzung, Delivery-Trend im Gruppenvergleich, Erfahrungsumfrage mit Wahrnehmungslücke, ein bis zwei Geschäftsergebnisse. Entscheiden Sie über Skalieren, Anpassen oder Stoppen nach der Regel aus Schritt 3.
Das Fazit
Die ehrliche Antwort auf „Wie viel produktiver hat KI unsere Entwickler gemacht?" lautet: Von außen kann Ihnen das niemand sagen, und die meisten internen Dashboards auch nicht. Die veröffentlichte Evidenz reicht von 19 % langsamer bis 55,8 % schneller, und die neuesten Zahlen sind die unsichersten. Wer eine einzelne Zahl mit Überzeugung zitiert, verkauft etwas.
Hören Sie auf, Nutzung als Produktivität zu berichten. Messen Sie vier Schichten, mit DORA in der Mitte und Geschäftsergebnissen oben. Behandeln Sie Selbstauskünfte als Erfahrungssignal und veröffentlichen Sie die Lücke zu den Delivery-Daten. Beantworten Sie die Kausalfrage mit einem gestaffelten Rollout, der fast nichts kostet, wenn Sie ohnehin ausrollen. Und bauen Sie in Europa die Aggregation auf Teamebene vom ersten Tag an ein. Das erwartet das Recht, und es macht die Zahlen glaubwürdig.
KI macht viele Ihrer Entwickler Ende 2026 vermutlich schneller beim Schreiben von Code. Ob sie Ihre Organisation schneller beim Liefern von Wert macht, ist eine andere, beantwortbare Frage, und an ihr hängt Ihr Budget.
Wenn Sie Unterstützung beim Aufbau des Mess-Stacks, beim gestaffelten Rollout oder bei der Betriebsvereinbarung wünschen, setzt unser KI-Beratungsteam das als Projekt mit festem Umfang um. Sie erhalten eine Baseline, ein Experimentdesign und einen einseitigen Quartalsbericht, dem Ihr Vorstand glaubt.
FAQ
Macht KI Entwickler tatsächlich produktiver?
Das hängt davon ab, wer an welcher Aufgabe arbeitet und wie Sie messen. Kontrollierte Studien reichen von 55,8 % schnellerer Bearbeitung einer Greenfield-Aufgabe in JavaScript (GitHub, 2022) bis zu 19 % längerer Bearbeitungszeit für erfahrene Open-Source-Entwickler in ihren eigenen großen Repositories (METR, Anfang 2025). Feldexperimente bei Microsoft, Accenture und einem Fortune-100-Unternehmen fanden 26 % mehr erledigte Aufgaben. Belastbar ist für Ihr Unternehmen nur die Zahl, die Sie selbst messen, mit Kontrollgruppe.
Was ist die Wahrnehmungslücke bei KI-Produktivität?
Die Differenz zwischen der Beschleunigung, die Entwickler empfinden, und der gemessenen. In METRs randomisierter Studie von 2025 hielten sich erfahrene Entwickler mit KI für 20 % schneller, waren aber 19 % langsamer. Die Lücke verläuft in beide Richtungen: In GitHubs Copilot-Studie von 2022 schätzten die Teilnehmenden 35 % Gewinn, gemessen wurden 55,8 %. Selbstauskünfte beschreiben Erfahrung, sie messen keine Geschwindigkeit.
Reichen DORA-Metriken, um den Effekt von KI zu messen?
Nein, aber sie sind die richtige zweite Schicht. Die fünf DORA-Metriken (Change Lead Time, Deployment-Häufigkeit, Recovery-Zeit nach fehlgeschlagenem Deployment, Change-Fehlerrate und Deployment-Nacharbeitsquote) zeigen, ob mehr Änderungen sicher in Produktion kommen. Überlastung, Review-Engpässe und Geschäftsnutzen zeigen sie nicht. Kombinieren Sie sie deshalb mit SPACE-Erfahrungsmetriken und Geschäftsergebnissen.
Welche KI-Coding-Metriken sollten wir nicht mehr berichten?
Codezeilen, Akzeptanzrate von Vorschlägen, Token-Verbrauch und die Zahl KI-erstellter Pull Requests. Sie messen Nutzung und Aktivität, lassen sich leicht aufblähen und belohnen große Änderungen: Faros AI fand bei Teams mit hoher KI-Nutzung 154 % größere Pull Requests und 91 % mehr Review-Zeit. Diese Kennzahlen gehören aufs Nutzungs-Dashboard und niemals in ein Ranking von Personen.
Braucht die Messung von KI-Entwicklerproduktivität die Zustimmung des Betriebsrats?
Fast immer, sobald Telemetrie erhoben wird. Nach § 87 Abs. 1 Nr. 6 BetrVG bestimmt der Betriebsrat bei technischen Einrichtungen mit, die zur Überwachung von Verhalten oder Leistung geeignet sind; die Arbeitsgerichte legen das weit aus. Telemetrie von KI-Tools, Git-Analytics und IDE-Plug-ins fällt in aller Regel darunter. Üblich ist eine Betriebsvereinbarung, die Auswertungen auf Teamebene begrenzt, Zweck und Speicherfristen festlegt und individuelle Leistungsbewertung ausschließt. DSGVO und § 26 BDSG gelten parallel.
Wie lange sollte ein Pilot zur KI-Produktivität laufen?
Mindestens ein volles Quartal, nach vier bis acht Wochen Baseline. Delivery-Metriken schwanken stark, Entwickler brauchen Einarbeitungszeit, und die ersten Wochen überzeichnen Neuheitseffekte. Ein gestaffelter Rollout, bei dem die noch nicht freigeschalteten Teams als Kontrollgruppe dienen, liefert in 12 bis 16 Wochen einen belastbaren Vergleich, ohne jemandem ein Werkzeug wegzunehmen.
Quellen
Alle Quellen geprüft am 15. November 2026. Jede Studie berichtet ihren Effekt in ihrer eigenen Metrik; die CSV-Datei nennt die Metrik neben jeder Zahl.
Tier A: Primärstudien, Standards und Rechtstexte
- Becker, Rush, Barnes, Rein (METR), „Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity", arXiv:2507.09089: https://arxiv.org/abs/2507.09089
- METR, Studienankündigung und Zusammenfassung (10. Juli 2025): https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
- METR, „We are Changing our Developer Productivity Experiment Design" (24. Februar 2026): https://metr.org/blog/2026-02-24-uplift-update/
- Peng, Kalliamvakou, Cihon, Demirer, „The Impact of AI on Developer Productivity: Evidence from GitHub Copilot", arXiv:2302.06590: https://arxiv.org/abs/2302.06590
- Paradis et al., „How much does AI impact development speed? An enterprise-based randomized controlled trial", arXiv:2410.12944: https://arxiv.org/abs/2410.12944
- Cui, Demirer, Jaffe, Musolff, Peng, Salz, „The Effects of Generative AI on High-Skilled Work" (Februar 2025): https://economics.mit.edu/sites/default/files/inline-files/draft_copilot_experiments.pdf
- DORA, Software-Delivery-Metriken: https://dora.dev/guides/dora-metrics/
- Forsgren, Storey, Maddila, Zimmermann, Houck, Butler, „The SPACE of Developer Productivity", ACM Queue 19(1), 2021: https://www.microsoft.com/en-us/research/publication/the-space-of-developer-productivity-theres-more-to-it-than-you-think/
- Betriebsverfassungsgesetz, § 87: https://www.gesetze-im-internet.de/betrvg/__87.html
- Verordnung (EU) 2024/1689 (KI-Verordnung), Anhang III sowie Art. 4 und 26: https://eur-lex.europa.eu/eli/reg/2024/1689/oj/deu
- Verordnung (EU) 2016/679 (DSGVO), Art. 35 und 88: https://eur-lex.europa.eu/eli/reg/2016/679/oj/deu
Tier B: Forschung und große Umfragen
- Google, „How are developers using AI? Inside Google's 2025 DORA report" (23. September 2025): https://blog.google/innovation-and-ai/technology/developers-tools/dora-report-2025/
- Google Cloud, „Introducing DORA's inaugural AI Capabilities Model" (23. September 2025): https://cloud.google.com/blog/products/ai-machine-learning/introducing-doras-inaugural-ai-capabilities-model
- Google Cloud, „Announcing the 2024 DORA report": https://cloud.google.com/blog/products/devops-sre/announcing-the-2024-dora-report
- Anthropic, „How AI assistance impacts the formation of coding skills" (29. Januar 2026): https://www.anthropic.com/research/AI-assistance-coding-skills
- Stack Overflow Developer Survey 2025, KI-Teil: https://survey.stackoverflow.co/2025/ai
- Stack Overflow Developer Survey 2026, KI-Teil: https://survey.stackoverflow.co/2026/ai
Tier C: Hersteller, richtungsweisend
- Faros AI, „The AI Productivity Paradox" (23. Juli 2025): https://www.faros.ai/blog/ai-software-engineering
- Atlassian, „State of Developer Experience 2025" (9. Juli 2025): https://www.atlassian.com/blog/developer/developer-experience-report-2025
- GitClear, „AI Copilot Code Quality: 2025 research": https://www.gitclear.com/ai_assistant_code_quality_2025_research
Themen