Workflow oder KI-Agent? Wann sich Autonomie wirklich lohnt
Leitfaden für CTOs: Vier Fragen zu Determinismus, Risiko und Variabilität bestimmen die Autonomiestufe 0 bis 4, mit Daten zu Kosten und Zuverlässigkeit.
Am 25. Juni 2025 prognostizierte Gartner, dass bis Ende 2027 mehr als 40 % der Projekte mit agentischer KI eingestellt werden: wegen steigender Kosten, unklaren Geschäftsnutzens oder unzureichender Risikokontrollen. Siebzehn Monate später sehen wir: Agentenprojekte, die ins Straucheln geraten, scheitern selten an schwachen Modellen. Sie scheitern, weil ein fester, prüfbarer Prozess einem System übergeben wurde, das seinen nächsten Schritt selbst wählt, und danach niemand mehr Rechnung, Streuung oder Audit-Trail erklären kann.
Dieser Beitrag richtet sich an die Menschen, die diese Entscheidung verantworten: CTOs, Leitungen von KI-Plattformen, Enterprise-Architekten und die Risikoverantwortlichen an ihrer Seite. Sie erhalten einen Entscheidungsbaum mit vier Fragen, der eine Autonomiestufe von 0 bis 4 festlegt, die Zahlen hinter den Kosten von Autonomie und den Blick auf die europäische Regulierung. Wir sind nicht gegen Agenten. Aber Autonomie ist ein Preis, den Sie bei jedem Lauf zahlen. Sie muss sich also rechnen.
TL;DR / Das Wichtigste in Kürze
- Workflow und Agent unterscheiden sich darin, wer den Kontrollfluss steuert. Kosten, Streuung und Prüfbarkeit folgen aus dieser einen Wahl.
- Autonomie ist ein Regler, kein Schalter. Fünf Stufen: L0 deterministischer Code, L1 ein LLM in einem festen Schritt, L2 ein gerouteter Workflow, L3 ein begrenzter Agent, L4 ein offener Agent.
- Vier Fragen legen die Stufe fest, in dieser Reihenfolge: Lässt sich der Ablauf festschreiben (Determinismus), ist ein Fehlschritt teuer (Risiko), lassen sich die Pfade aufzählen (Variabilität), und ist offene Exploration die Rechnung wert (Autonomie)?
- Die Rechnung ist real. Laut Anthropic verbrauchen Agenten etwa 4× so viele Tokens wie ein Chat, Multi-Agenten-Systeme etwa 15×. Die Zuverlässigkeit sinkt mit jedem Schritt: Bei 95 % je Schritt gelingt eine Kette aus 20 Schritten nur in 36 % der Fälle.
- Meist gewinnt das Hybridmuster: ein Workflow als Rückgrat mit einer kleinen, begrenzten Agenten-Insel für den Long Tail, abgesichert durch Evals, Tracing, Budgets und Freigaben.

Download: Editierbare draw.io-Datei · In diagrams.net öffnen · Diagrammdaten (CSV)
Warum das jetzt zählt
- Der Hype traf auf das Budget. Gartners Prognose vom Juni 2025 kam mit einer Warnung vor „Agent Washing“: Nur etwa 130 der Tausenden Anbieter agentischer KI seien echt. In einer Gartner-Umfrage unter 360 IT-Anwendungsverantwortlichen, veröffentlicht am 30. September 2025, pilotierte oder betrieb rund drei Viertel bereits eine Form von KI-Agenten. Nur 15 % zogen vollständig autonome Agenten in Betracht, pilotierten oder betrieben sie, und 74 % sahen in Agenten einen neuen Angriffsvektor. Die meisten Unternehmen wollen also längst begrenzte Autonomie. Es fehlt ihnen nur ein Verfahren, um zu entscheiden, wie viel.
- Die Anbieter geben inzwischen denselben Rat. Anthropics „Building effective agents“ (Dezember 2024) trennt Workflows, die über vordefinierte Codepfade orchestriert werden, von Agenten, die ihre Abläufe und Tool-Nutzung dynamisch selbst steuern, und empfiehlt die einfachste mögliche Lösung. OpenAIs Leitfaden zum Bau von Agenten (2025) warnt, dass andernfalls eine deterministische Lösung genügen kann. Microsofts Dokumentation zum Agent Framework (aktualisiert im Oktober 2026) wird am deutlichsten: Wenn Sie für die Aufgabe eine Funktion schreiben können, tun Sie das, statt einen KI-Agenten einzusetzen. Wenn die Anbieter der Modelle zu weniger Agenten raten, sollten Sie zuhören.
- Die Zuverlässigkeitsdaten haben die Demos eingeholt. Das τ-bench-Paper (Yao et al., 2024) führte pass^k ein: die Wahrscheinlichkeit, dass ein Agent dieselbe Aufgabe in allen k Versuchen löst. GPT-4o löste im Retail-Szenario etwa 61 % der Aufgaben im ersten Versuch, aber weniger als 25 % zuverlässig über acht Versuche. Demos zeigen die erste Zahl, der Betrieb lebt von der zweiten.
Die Autonomieleiter: fünf Stufen, ein Regler
„Agentisch“ heißt heute alles, von der Prompt-Kette bis zum selbststeuernden Schwarm. Wir definieren fünf Stufen über eine Frage: Wer entscheidet über den nächsten Schritt?
| Stufe | Name | Wer entscheidet den nächsten Schritt | Typisches Beispiel | Rolle des Menschen |
|---|---|---|---|---|
| L0 | Deterministische Automatisierung | Ihr Code und Ihre Regeln | Dreifachabgleich von Rechnungen auf ERP-Daten | Verantwortet die Regeln |
| L1 | LLM in einem festen Schritt | Ihr Code; das Modell füllt einen Schritt | Felder aus einem gescannten Schadenfall extrahieren, im Code validieren | Prüft Ausnahmen |
| L2 | Gerouteter Workflow | Das Modell wählt einen von wenigen festen Pfaden | Ticket einer von sechs Queues mit festen Handlern zuordnen | Gibt Schreibzugriffe frei |
| L3 | Begrenzter Agent | Das Modell, innerhalb von Allowlist, Schrittgrenze und Budget | Fehlgeschlagene Zahlung mit Lese-Tools untersuchen, Lösung vorschlagen | Gibt Aktionen frei |
| L4 | Offener Agent | Das Modell, inklusive Planung, Delegation und Tool-Wahl | Multi-Agenten-Recherche über viele Quellen | Überwacht und prüft |
L0 bis L2 sind Workflows: Der Kontrollfluss liegt in Ihrem Code, auch wenn ein Modell darin arbeitet. L3 und L4 sind Agenten: Der Kontrollfluss liegt zur Laufzeit im Schlussfolgern des Modells. Diese Grenze entscheidet, wie Sie testen, wie Sie einer Prüferin eine Entscheidung erklären und wie Sie die Kosten planen.
Anthropics Workflow-Muster (Prompt Chaining, Routing, Parallelisierung, Orchestrator-Worker, Evaluator-Optimizer) liegen auf L1 und L2. „Levels of Autonomy for AI Agents“ von Feng, McDonald und Zhang (2025) stuft die Rolle der Nutzer ab, vom Operator bis zum Beobachter. Wir beschreiben die Architektur, denn die bauen, bezahlen und regulieren Sie.
Der Entscheidungsbaum, Frage für Frage
Stellen Sie die vier Fragen der Reihe nach und stoppen Sie bei der ersten Antwort, die die Stufe festlegt. Die Nummern entsprechen der Abbildung.
① Determinismus: Lässt sich der Ablauf vorab festschreiben?
Wenn eine kompetente Fachkraft den Prozess als Flussdiagramm zeichnen kann, haben Sie einen Workflow. Offen ist nur, ob ein Schritt sprachliches Urteilsvermögen braucht. Bestimmen Regeln und strukturierte Daten das Ergebnis, bleiben Sie bei L0: kein Modell, also günstiger, schneller und leichter zu testen. Muss ein Schritt einen Vertrag lesen oder Freitext klassifizieren, setzen Sie das Modell in genau diesen Schritt und behalten den Kontrollfluss im Code: L1.
Der häufigste Fehler, den wir sehen: unstrukturierte Eingaben mit einem unstrukturierten Prozess zu verwechseln. Ein Schadenfall kommt als unordentliches PDF, aber der Prozess dahinter (Deckung prüfen, Betrugsindikatoren prüfen, berechnen, freigeben oder weiterleiten) ist klar definiert. Unordentliche Eingaben verlangen ein Modell im Schritt, keinen Agenten am Steuer.
② Risiko: Was kostet ein Fehlschritt?
Stellen Sie diese Frage pro Aktion, nicht pro Anwendungsfall. Eine Wissensdatenbank zu lesen ist harmlos. Eine Erstattung auszulösen, eine Firewall-Regel zu ändern, einen Kundenbrief zu verschicken oder Daten zu löschen ist es nicht.
Ist ein Fehlschritt teuer oder irreversibel (Geld fließt, Rechte oder personenbezogene Daten sind betroffen, Kunden sehen das Ergebnis), deckeln Sie die Autonomie bei L2. Das Modell wählt zwischen geprüften Pfaden, und vor jedem Schreibzugriff steht eine menschliche Freigabe. Ein begrenzter Agent kann trotzdem die lesende Seite übernehmen, also untersuchen und Entwürfe schreiben, solange die Aktion selbst durch ein Freigabe-Gate läuft; die Muster beschreibt unser Leitfaden zu Human-in-the-Loop-Freigaben. Risiko heißt auch Angriffsfläche: Ein Agent, der nicht vertrauenswürdige Inhalte liest und Schreib-Tools hält, ist der klassische Aufbau für indirekte Prompt Injection.
③ Variabilität: Lassen sich die Pfade aufzählen?
Ist das Risiko begrenzt, zählen Sie die Pfade. Fallen die Fälle in eine Handvoll Muster, etwa weniger als zehn, jeweils mit bekanntem Handler, brauchen Sie noch immer keinen Agenten. Ein Router (L2) klassifiziert den Fall und übergibt ihn an einen festen Teil-Workflow. Jeder Zweig ist einzeln testbar, und der Router lässt sich wie ein Klassifikator mit Konfusionsmatrix bewerten. Das verstehen auch Prüfer.
Modellgesteuerter Kontrollfluss lohnt sich erst, wenn die Pfade einen Long Tail bilden. Jeder Fall ist etwas anders, und der nächste sinnvolle Schritt hängt davon ab, was das letzte Tool geliefert hat. Das ist das ehrliche Terrain für Agenten: Untersuchung, Fehlersuche, Recherche, Programmierung und Abgleich über Systeme hinweg, bei dem die Daten überraschen.
④ Autonomie: Ist Offenheit die Rechnung wert?
Wer bis hierher kommt, braucht einen Agenten. Offen ist nur, wie frei er sein soll. Ein begrenzter Agent (L3) plant Tool-Aufrufe innerhalb einer Allowlist, mit Schrittgrenze, Tokenbudget, Timeout und Freigabe bei Schreibzugriffen. Das ist der richtige Standard im Unternehmen.
Ein offener Agent (L4) plant, delegiert an Sub-Agenten und wählt seine Tools selbst. Er rechnet sich nur, wenn die Aufgabe offen und langlaufend ist und eine bessere Antwort ein Vielfaches der Tokenkosten wert ist. Anthropics Multi-Agenten-Recherchesystem ist der Referenzfall: Auf Anthropics interner Recherche-Evaluation übertraf es einen einzelnen Agenten um 90,2 %, braucht laut Anthropic aber Aufgaben, deren Wert hoch genug ist, um die höhere Leistung zu bezahlen. Die meisten Unternehmensprozesse sind keine offene Recherche.
In beiden Fällen gilt die Hürde aus der Abbildung: Evals an echten Fällen, durchgängiges Tracing, Token- und Schrittbudgets, Not-Aus und Freigabe bei Schreibzugriffen. Ohne alle fünf sind Sie nicht reif für L3. Für den ersten Punkt hilft unser Evaluations-Harness für Agenten.
Das Hybridmuster, das meist gewinnt
Für einen ganzen Prozess lautet die Antwort selten „Workflow“ oder „Agent“. Meist ist es ein Workflow als Rückgrat mit ein oder zwei begrenzten Agenten-Inseln, wo der Long Tail liegt.
Der Workflow verantwortet die Grenzen: was hereinkommt, was geschrieben wird, wer freigibt. Der Agent verantwortet nur den Teil, den Sie nicht spezifizieren können, und sein Ergebnis ist ein Vorschlag, der in den deterministischen Pfad zurückkehrt. So bleibt die teure, schwankende Komponente klein, messbar und austauschbar. Läuft die Agenten-Insel stundenlang oder wartet auf Menschen, geben Sie dem Rückgrat Durable Execution, damit ein Absturz die Untersuchung nicht neu startet.
Was die Zahlen sagen
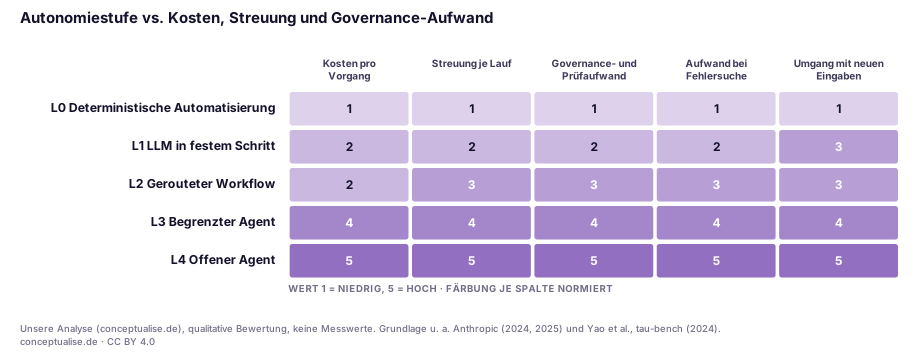
Die Heatmap ist unsere qualitative Analyse, keine Messung. Ihre Aussage: Alle Spalten steigen gemeinsam. Der Umgang mit neuen Eingaben, die einzige Spalte, die Sie eigentlich wollen, wird mit Kosten, Streuung, Governance- und Debugging-Aufwand bezahlt. Der große Sprung liegt zwischen L2 und L3: Dort wandert der Kontrollfluss von Ihrem Code ins Modell, und aus „jeden Zweig prüfen“ wird „viele Läufe ziehen und die Verteilung messen“.
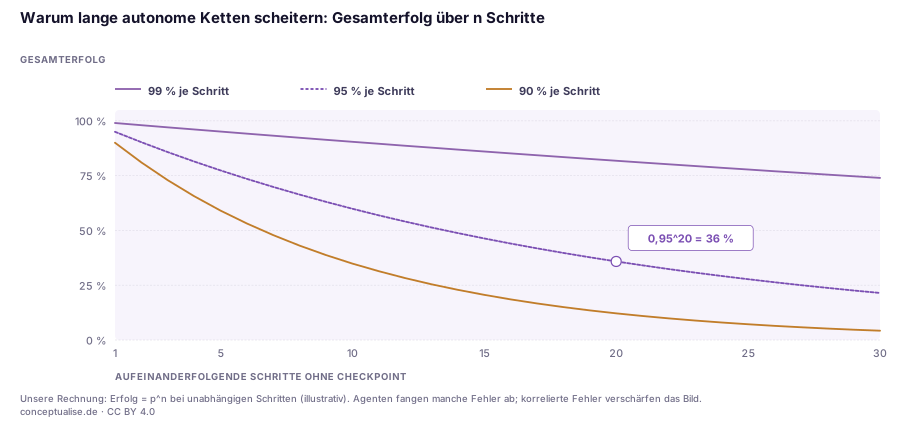
Dieses Diagramm ist reine Arithmetik und unterstellt unabhängige Schritte. Gelingt jeder autonome Schritt zu 95 % und prüft niemand das Zwischenergebnis, endet eine Kette aus 20 Schritten nur in 36 % der Fälle korrekt (0,95^20). Bei 90 % je Schritt landen Sie schon nach zehn Schritten bei 35 %. Echte Agenten schneiden mal besser ab, weil sie Fehler bemerken und wiederholen, mal schlechter, weil Fehler korrelieren und ein falsch gelesener Fakt jeden späteren Schritt vergiftet. Die Lehre: Bauen Sie Checkpoints in lange Ketten ein, validieren Sie zwischen den Schritten im Code und halten Sie die modellgesteuerte Strecke kurz.
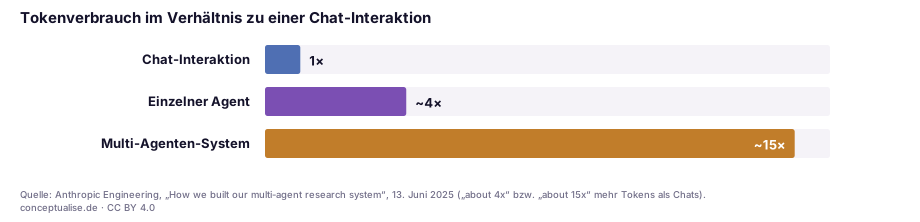
Anthropics Verhältniszahlen machen die Kostenseite greifbar: etwa 4× die Tokens eines Chats für seine Agenten, etwa 15× für das Multi-Agenten-System. Auf der Evaluation BrowseComp erklärte der Tokenverbrauch allein 80 % der Leistungsvarianz: Mehr Autonomie kauft bessere Antworten vor allem über mehr Tokens. Für eine wertvolle Recherchefrage ist das ein guter Tausch, für das Routing von Rechnungen ein schlechter. Wie Sie das budgetieren, zeigt unser Leitfaden zur Kosten-Governance von Agenten.
Aus einem aktuellen Projekt
In einem Architektur-Review in diesem Jahr zeigte uns ein europäischer Finanzdienstleister einen „Agenten“ für Kundenkorrespondenz. Er las eingehende Briefe, suchte den Kunden heraus, entwarf eine Antwort und legte den Vorgang ab. Die Demo beeindruckte, der Pilot nicht: Dieselbe Art von Brief nahm an verschiedenen Tagen verschiedene Tool-Pfade, die Tokenkosten waren kaum planbar, und bei einer falschen Antwort konnte niemand sagen, welcher Schritt versagt hatte. Binnen Wochen verlor das Operations-Team das Vertrauen.
Wir sind die vier Fragen mit dem Team durchgegangen. Nicht für jeden Brief ließ sich der Ablauf festschreiben (① nein), und falsche Antworten an Kunden sind teuer, also deckelte ② die ausgehende Aktion bei L2 mit Freigabe. Aufschlussreich war Frage ③: Als wir eine Stichprobe früherer Briefe clusterten, fiel der Großteil in wenige wiederkehrende Typen mit bekanntem Vorgehen. Nur eine Minderheit war wirklich neu.
Das Redesign war unspektakulär. Ein Modell extrahiert Felder und klassifiziert den Brief (L1 und L2). Wiederkehrende Typen gehen an feste Handler, die aus von Compliance freigegebenen Vorlagen entwerfen. Der neuartige Rest geht an einen begrenzten, nur lesenden Agenten, der eine Antwort zur menschlichen Freigabe vorschlägt. Das Team fürchtete, „die KI aufzugeben“. Stattdessen wurde die Agenten-Insel klein genug, um sie sauber zu evaluieren, und Operations vertraute ihr wieder.
Die Entscheidungs-Checkliste
Der Teil für den Screenshot. Bewerten Sie jeden Anwendungsfall, bevor jemand einen Prompt schreibt.
| # | Frage | Wenn ja | Wenn nein | Nachweis |
|---|---|---|---|---|
| 1 | Lässt sich der Ablauf als Flussdiagramm zeichnen? | L0 (Regeln genügen) oder L1 (ein Schritt liest Sprache) | Weiter zu 2 | Das Flussdiagramm |
| 2 | Ist eine Aktion teuer, irreversibel, für Kunden sichtbar oder rechtlich relevant? | Deckel bei L2, Freigabe bei jedem Schreibzugriff; L3 nur lesend | Weiter zu 3 | Tool-Inventar mit Schadenspotenzial |
| 3 | Fällt die Mehrheit der Fälle in wenige Pfade mit bekannten Handlern? | L2: Router plus feste Teil-Workflows | Weiter zu 4 | Geclusterte Stichprobe echter Fälle |
| 4 | Ist die Aufgabe offen und langlaufend, und ist eine bessere Antwort ~15× die Tokens wert? | L4 mit Budgets | L3, begrenzter Agent | Wert pro Vorgang vs. Kosten pro Lauf |
| 5 | Hürde für L3/L4: Evals, Tracing, Budgets, Not-Aus, Freigabe bei Schreibzugriffen? | Weiter | Bei L2 bleiben | Eval-Bericht, Trace-Stichprobe, Budgetkonfiguration |
| 6 | Können Sie ein Fehlergebnis allein aus den Logs einer Prüferin erklären? | Weiter | Erst Entscheidungs-Logs ergänzen | Ein nachgespielter Fehlerfall |
Zwei Warnungen. Stufen gelten pro Aktion, nicht pro Produkt: Derselbe Assistent kann beim Lesen L3 und beim Schreiben L2 sein. Und bewerten Sie regelmäßig neu, denn neue Modelle verschieben, was ein einzelner Klassifikationsschritt leisten kann.
Governance für europäische Unternehmen
Die KI-Verordnung regelt Verwendungszwecke und Rollen, keine „Agenten“: Agent und Workflow mit derselben Aufgabe haben dieselben Pflichten. Autonomie verändert, wie schwer sie nachzuweisen sind.
KI-Verordnung (Verordnung (EU) 2024/1689). Die Pflicht zur KI-Kompetenz nach Art. 4 gilt seit 2. Februar 2025. Art. 50 Abs. 1 gilt seit 2. August 2026: Systeme, die direkt mit Menschen interagieren, müssen diese darüber informieren, dass sie mit einer KI zu tun haben, sofern das nicht offensichtlich ist. Das gilt für Agent und Workflow gleichermaßen. Für Hochrisiko-KI-Systeme nach Anhang III, etwa Kreditwürdigkeitsprüfung oder Personalauswahl, hat die Verordnung (EU) 2026/1744 die Pflichten einschließlich der menschlichen Aufsicht nach Art. 14 auf den 2. Dezember 2027 verschoben. Wirksame Aufsicht ist bei einem L2-Workflow mit Freigabe-Gate weit leichter nachzuweisen als bei einem L4-Agenten; deshalb deckelt Frage ② solche Entscheidungen bei L2.
DSGVO Art. 22. Ausschließlich automatisierte Entscheidungen im Einzelfall mit rechtlicher oder ähnlich erheblicher Wirkung sind eingeschränkt. Im Urteil SCHUFA (C-634/21, 7. Dezember 2023) stellte der EuGH fest, dass schon ein automatisiert ermittelter Score eine solche Entscheidung sein kann, wenn ein Dritter maßgeblich darauf abstellt. Ein Agent, der ohne echte menschliche Beteiligung über Kredit, Schadenfall oder Bewerbung entscheidet, bewegt sich im Anwendungsbereich von Art. 22, gleich welche Architektur er hat. Freigabe-Gates bauen das Eingreifen einer Person ein, das die Ausnahmen verlangen.
DORA. Für Finanzunternehmen gilt die Verordnung (EU) 2022/2554 seit 17. Januar 2025. Ein Agent in einem Prozess, der kritische oder wichtige Funktionen unterstützt, fällt unter Ihren Rahmen für das IKT-Risikomanagement, einschließlich Änderungsmanagement, Tests und Klassifizierung von Vorfällen. Versionieren Sie Prompts, Tools und Modelle, und behandeln Sie ein Modell-Upgrade als Änderung.
Pragmatischer Einführungspfad
- Inventar und Bewertung (Woche 1–2). Bewerten Sie jeden laufenden KI-Anwendungsfall mit der Checkliste und benennen Sie je einen Owner. Rechnen Sie mit L4-Ambitionen für L1-Probleme.
- Erst herunterstufen (Woche 3–6). Bauen Sie die häufigen Pfade überbewerteter Fälle als L1/L2-Workflow-Schritte neu, den ursprünglichen Agenten im Schattenbetrieb zum Vergleich.
- Die Hürde bauen (Woche 4–8). Stellen Sie die fünf Voraussetzungen der Hürde als gemeinsame Plattformdienste bereit. Wo sie hingehören, zeigt unsere Referenzarchitektur für Enterprise-Agentenplattformen.
- Eine Agenten-Insel öffnen (Monat 3). Wählen Sie den Fall mit dem klarsten Long Tail und dem geringsten Aktionsrisiko. Lassen Sie einen nur lesenden L3-Agenten auf den Restfällen laufen und messen Sie pass^k über wiederholte Läufe.
- Quartalsweise neu bewerten. Stufen Sie einen Fall nur hoch, wenn Evals und Traces Stabilität zeigen, und herunter, wenn Kosten oder Streuung abdriften. Führen Sie die Stufen in Ihrem KI-Inventar, damit Risiko, Revision und Engineering über dieselbe Tabelle sprechen.
Das Fazit
Agenten sind keine Reifestufe, die jeder Prozess erreichen sollte. Sie sind ein Werkzeug für Probleme, deren Ablauf sich nicht festschreiben und deren Pfade sich nicht aufzählen lassen. Dort sind sie hervorragend. Anderswo verbrauchen sie Tokens und Prüfaufwand, um ein Flussdiagramm wiederzuentdecken, das Sie hätten zeichnen können.
Wählen Sie standardmäßig die niedrigste Stufe, die das Problem löst, steigen Sie Stufe für Stufe mit Belegen auf, und überlassen Sie dem Modell so wenig Kontrollfluss, wie das Problem erlaubt. Wir erwarten den größten Unternehmensnutzen 2027 aus L1- und L2-Workflows mit exzellenten Modellaufrufen, ergänzt um wenige gut begrenzte Agenten dort, wo der Long Tail wirklich lang ist. Wer so arbeitet, landet kaum in Gartners 40 %.
Sie wünschen eine zweite Meinung dazu, wo Ihre Anwendungsfälle stehen? Unser KI-Architektur-Team führt diese Bewertung als kurzes Portfolio-Review mit festem Umfang durch: jeder Fall auf seiner Stufe, die fehlenden Hürden-Punkte und eine Liste von Agenten, die besser Workflows wären.
FAQ
Was unterscheidet einen agentischen Workflow von einem KI-Agenten?
Wer den Kontrollfluss steuert. Im Workflow legt Ihr Code die Reihenfolge der Schritte fest, und das Modell arbeitet innerhalb dieser Schritte. Beim Agenten entscheidet das Modell zur Laufzeit, welches Tool es als Nächstes aufruft und wann es fertig ist. Anthropic zieht dieselbe Grenze.
Wann sollten wir einen KI-Agenten statt eines Workflows einsetzen?
Wenn sich der Ablauf nicht festschreiben lässt, die Pfade nicht aufzählbar sind und ein Fehlschritt billig ist oder abgefangen wird, bevor er wirkt. Offene Multi-Agenten-Aufbauten brauchen zudem Aufgaben, die ein Vielfaches der Tokenkosten eines Chats wert sind. Fehlt eine Bedingung, ist ein Workflow mit Modellaufrufen meist günstiger und zuverlässiger.
Welche Autonomiestufen unterscheidet das Framework?
L0 ist deterministische Automatisierung ohne Modell, L1 setzt ein LLM in einen festen Schritt, L2 ist ein gerouteter Workflow, in dem das Modell einen von wenigen festen Pfaden wählt. Das sind Workflows. L3 ist ein begrenzter Agent mit Allowlist, Budgets und Freigaben, L4 ein offener Agent, der plant, delegiert und Tools wählt, während Menschen überwachen.
Sind KI-Agenten teurer als Workflows?
In der Regel ja. Anthropic berichtete im Juni 2025, dass seine Agenten etwa viermal so viele Tokens verbrauchen wie Chat-Interaktionen, Multi-Agenten-Systeme etwa fünfzehnmal so viele. Hinzu kommen höhere Kosten für Tests, Tracing, Governance und Fehlersuche, weil sich der Pfad von Lauf zu Lauf ändert.
Behandelt die KI-Verordnung Agenten anders als Workflows?
Nein. Die KI-Verordnung regelt Anwendungsfälle und Rollen, nicht Architekturen. Die Transparenzpflicht nach Art. 50 Abs. 1 gilt seit 2. August 2026; die Pflichten für Hochrisiko-KI-Systeme nach Anhang III, einschließlich menschlicher Aufsicht nach Art. 14, gelten nach der Verordnung (EU) 2026/1744 ab 2. Dezember 2027. Mehr Autonomie erschwert lediglich den Nachweis wirksamer Aufsicht.
Können wir mit einem Agenten starten und ihn später zum Workflow härten?
Ja, und oft ist das der beste Weg, den echten Prozess zu entdecken. Lassen Sie einen begrenzten Agenten im Schattenbetrieb laufen, tracen Sie jeden Lauf und gießen Sie die wiederkehrenden Pfade in feste Workflow-Schritte. Dem Agenten bleibt nur der Long Tail, und der ist meist kleiner als erwartet.
Quellen
Geprüft am 15. November 2026. Dieser Artikel ist keine Rechtsberatung.
Tier A: Primärquellen und Regulierung
- Verordnung (EU) 2024/1689 (KI-Verordnung), EUR-Lex: Art. 4, 14, 50; Anhang III. Geltungsbeginn für Anhang III geändert durch Verordnung (EU) 2026/1744
- Verordnung (EU) 2016/679 (DSGVO), EUR-Lex: Art. 22
- EuGH, Urteil vom 7. Dezember 2023, C-634/21 (SCHUFA Holding, Scoring)
- Verordnung (EU) 2022/2554 (DORA), EUR-Lex
Tier B: Forschung und Analyse
- Yao, Shinn, Razavi, Narasimhan: τ-bench, a benchmark for tool-agent-user interaction in real-world domains (arXiv 2406.12045, Juni 2024)
- Feng, McDonald, Zhang: Levels of Autonomy for AI Agents (arXiv 2506.12469, 2025)
- Reuters via The Star: Over 40% of agentic AI projects will be scrapped by 2027, Gartner says (25. Juni 2025)
- Gartner-Pressemitteilung: Survey finds just 15% of IT application leaders are considering, piloting or deploying fully autonomous AI agents (30. September 2025), Zahlen laut The Register (1. Oktober 2025)
Tier C: Anbieter, richtungsweisend
Themen