Können LLMs SAST-Findings triagieren? Die Evidenz
Was Studien zur KI-Triage von SAST-Findings wirklich zeigen, was sie an übersehenen Bugs kostet und wie Sie es mit einem Harness am eigenen Code messen.
Am 26. Januar 2026 veröffentlichte ein Forschungsteam in Zusammenarbeit mit Tencent etwas, das AppSec-Teams selten bekommen: eine gemessene Antwort aus der Produktion. Grundlage waren 433 Alarme des hauseigenen statischen Analysewerkzeugs auf echtem C/C++-Code, jeder einzelne im regulären zweistufigen Review des Unternehmens gelabelt. Die manuelle Prüfung hatte pro Alarm 10 bis 20 Minuten gekostet. Das beste LLM-basierte Verfahren entfernte 94–98 % der False Positives. Dasselbe Paper hält allerdings fest, dass der Recall unter den 90 % blieb, die das Unternehmen erwartet. Kurz gesagt: Die Werkzeuge, die das Rauschen beseitigten, verloren auch echte Bugs.
Dieser Zielkonflikt ist der Kern der LLM-Triage für statische Analyse, und die meisten Herstellerseiten erzählen nur die erste Hälfte. Dieser Beitrag richtet sich an alle, die entscheiden müssen, ob ein Modell Findings schließen darf: AppSec-Verantwortliche, CISOs, Platform Engineering und KI-Teams, die „einfach einen Richter dazuschalten“ sollen. Wir zeigen, was die veröffentlichten Studien tatsächlich gemessen haben und was nicht. Wir beziffern, was Schlagzeilenwerte an übersehenen Bugs verschweigen. Und wir geben Ihnen ein reproduzierbares Harness, mit dem Sie das am eigenen Code messen, bevor Sie irgendetwas einschalten.
TL;DR / Das Wichtigste in Kürze
- Das Rauschen ist real, und LLMs können es senken. In Tencents Industriestudie entfernten hybride Verfahren mit präzisem Code-Kontext 84–98 % der False Positives. Einfaches Prompting nach dem Muster „Ist das ein False Positive?“ schaffte im selben Industrieumfeld nur 26–52 %.
- Jeder veröffentlichte Gewinn kostet Recall. Die besten Verfahren bei Tencent behielten 75–88 % der echten Bugs. QASecClaw verlor auf dem OWASP Benchmark 40 True Positives. Schließt ein Modell Findings automatisch, werden diese Verluste unsichtbar.
- Benchmarks schmeicheln den Modellen. Im OWASP Benchmark sind rund 70 % der Alerts echt, in Tencents Produktionsdaten waren es 24 %, vor der Vorfilterung unter 10 %. Ihre Basisrate entscheidet, was die Zahlen bedeuten.
- Erst messen, dann vertrauen. Sie brauchen blinde menschliche Labels, Recall mit Konfidenzintervall und mindestens 100 bestätigte echte Bugs. Bei 45 kann ein gemessener Recall von 85 % in Wahrheit irgendwo zwischen 72 % und 93 % liegen.
- Das LLM soll priorisieren, nicht löschen. Starten Sie mit beratenden Urteilen und Begründungen. Unterdrückung folgt erst für risikoarme Schwachstellenklassen mit gemessenem Recall, und von allem, was das Modell schließt, wird eine Stichprobe geprüft.

Download: Editierbare draw.io-Datei · In diagrams.net öffnen · Diagrammdaten (CSV)
Warum das jetzt wichtig ist
Statische Analyse hatte schon immer ein Präzisionsproblem, und 2026 wurde es teurer. Die Tencent-Studie beziffert die False-Positive-Rate ihrer statischen Warnungen auf über 90 %, wenn man die vor dem Labeling verworfenen Alarme mitzählt. Selbst nach dieser Vorfilterung waren 328 der 433 gelabelten Alarme falsch. Das deckt sich mit dem, was wir in Unternehmens-Pipelines sehen. Entwickler lernen schnell, dass die meisten SAST-Kommentare falsch sind, und lesen dann keinen mehr, auch nicht die richtigen.
Gleichzeitig laufen nach unserer Erfahrung durch KI-Coding-Assistenten mehr Code-Änderungen durch die Scanner. Die Scanner selbst bringen inzwischen LLM-Triage mit. Die Semgrep-Dokumentation beschreibt eine KI-„Autotriage“, die vorschlägt, welche Findings ignoriert werden können. Dazu kommt eine Rauschfilterung im Beta-Stadium, die wahrscheinliche False Positives in Pull-Request-Kommentaren unterdrückt. Laut Dokumentation ist sie „over 95% accurate“ bei der Einstufung von Semgrep-Code-Findings als False Positive, ohne Angabe, wie das gemessen wurde. Datadog stellte im Oktober 2025 einen Bits-AI-Filter für False Positives in seiner statischen Analyse vor, evaluiert auf dem OWASP Benchmark, ohne Zahlen zu veröffentlichen. Und das GitHub Security Lab beschrieb im Januar 2026, wie es CodeQL-Alerts mit LLM-„Taskflows“ triagiert und seit dem vorangegangenen August rund 30 echte Schwachstellen gefunden hat.
Die Frage ist also nicht mehr, ob ein LLM auf SAST-Ergebnisse angewendet wird. Ihr Hersteller schaltet es ohnehin ein. Die Frage ist, was Sie es entscheiden lassen und woran Sie merken würden, dass es falsch liegt. Seit die Meldepflichten des Cyber Resilience Act am 11. September 2026 greifen, ist ein unterdrücktes True Positive genau die Art Entscheidung, nach der ein Prüfer fragt.
Was die veröffentlichte Evidenz zeigt
Wir haben die Studien mit Primärdaten zur LLM-Triage von Findings statischer Analyse von Ende 2023 bis November 2026 gelesen. Wichtig vorab: Triage ist nicht Detektion. Das Modell beurteilt einen konkreten Alert samt umgebendem Code. Und die Papers definieren die positive Klasse unterschiedlich. Wir berichten deshalb einheitlich „Anteil entfernter False Positives“ und „Anteil behaltener echter Bugs“.
Die Industriestudie (Tencent, 2026). Du et al. testeten sechs Techniken mit vier Modellen (GPT-4o, Claude-Opus-4, Qwen-3-Coder und DeepSeek-R1). Die Alarme betrafen Null-Pointer-Dereferenzierung, Out-of-Bounds-Zugriffe und Division durch null aus Tencents Analysewerkzeug BkCheck. Die Ground Truth stammte aus dem regulären Review-Prozess: Entwickler labelten zuerst, dedizierte Reviewer prüften nach, Senior-Reviewer lösten Konflikte. Einfaches Prompting entfernte 26–52 % der False Positives und behielt 62–84 % der echten Bugs. Die hybriden Verfahren LLM4SA und LLM4PFA, die dem Modell präzisen Code-Kontext und Pfadbedingungen liefern, entfernten 84–98 % der False Positives, der Recall blieb aber zwischen 65 % und 88 %. Die Kosten waren kein Hindernis: Das Paper nennt 2,1 bis 109,5 Sekunden und 0,0011 bis 0,12 US-Dollar pro Alarm. Außerdem verkürzten die Erklärungen des Modells die menschliche Prüfung von etwa zehn auf etwa drei Minuten.
ZeroFalse (2025). Iranmanesh et al. gaben CodeQL-Alerts, Datenflusspfade und CWE-spezifische Hinweise an zehn Modelle. Die besten F1-Werte lagen bei 0,912 auf dem OWASP Java Benchmark (1.974 CodeQL-Alerts) und 0,955 auf dem kleineren OpenVuln-Datensatz (58 Alerts). Das Paper zeigt auch, wie stark Ergebnisse zwischen Modellen und Datensätzen schwanken. Gemini 2.5 Pro erreichte dort F1 0,910 auf OWASP, aber nur 0,372 auf OpenVuln, weil der Recall auf dem realen Datensatz einbrach. Laut den Autoren schlagen CWE-spezifische Prompts generische, auch wenn sich einzelne Kombinationen aus Modell und Datensatz verschlechterten.
QASecClaw (2026). Ameen et al. setzten einen Multi-Agenten-LLM-Filter auf Basis von Qwen 3.5 Plus hinter Semgrep Community Edition, getestet auf OWASP Benchmark v1.2 (2.740 Java-Testfälle). Die False Positives sanken von 560 auf 64, ein Minus von 88,6 %. Die Präzision stieg von 0,695 auf 0,951, der Recall fiel von 0,900 auf 0,871. Das sind 40 echte Schwachstellen, die Semgrep gefunden und der Filter verworfen hat. Bei einer Klasse, Trust Boundary Violation (CWE-501), verschlechterte der Filter den F1-Wert sogar: 0,593 gegenüber 0,768 bei Semgrep allein.
LLM4PFA (2025) ist das Verfahren zur Pfadmachbarkeitsanalyse, das später in der Tencent-Studie am besten abschnitt. Das eigene Paper meldet 72–96 % gefilterte False Positives bei 3 übersehenen von 45 echten Bugs.
SAST-Genius (2025). Agrawal und Ahi kombinierten Semgrep mit einem feinabgestimmten Llama 3 8B. Sie berichten einen Rückgang der False Positives von 225 auf 20 und eine Präzision von 89,5 % statt 35,7 % über 25 Open-Source-Projekte. Es handelt sich um Eigenangaben auf einem selbst erstellten Datensatz.
Die skeptische Evidenz. Ullah et al. (IEEE S&P 2024) testeten acht LLMs auf 228 Code-Szenarien und fanden nicht-deterministische Antworten und unzuverlässige Begründungen. Schon kleine Änderungen wie umbenannte Funktionen oder Variablen oder zusätzliche Bibliotheksfunktionen führten bei GPT-4 in 17 % und bei PaLM 2 in 26 % der Fälle zu falschen Antworten. Ding et al. (ICSE 2025) zeigten, dass ein Modell mit 68,26 % F1 auf dem älteren BigVul-Benchmark auf ihrem bereinigten PrimeVul-Datensatz auf 3,09 % fiel, und GPT-3.5 und GPT-4 waren nicht besser. Beide Arbeiten testen Detektion, nicht Triage. Sie erklären aber, warum alle funktionierenden Triage-Verfahren Struktur hinzufügen: Pfade, Bedingungen und CWE-Wissen.
Unsere Lesart in einem Satz: Mit der richtigen Evidenz ist ein LLM ein sehr guter Filter, aber keine veröffentlichte Konfiguration ist gut genug, um Findings unbeaufsichtigt zu schließen, ohne den Recall am eigenen Code zu messen.
Das Harness, Schritt für Schritt
Diesen Teil können Sie direkt übernehmen. Das Hauptdiagramm zeigt ein Triage-Harness mit zwei Schleifen. Die Produktionsschleife führt Findings über ein Evidenzpaket und einen LLM-Richter zur Routing-Regel. Die Auswertungsschleife läuft offline mit blinden menschlichen Labels und legt fest, was die Routing-Regel darf. Die Nummern entsprechen den Markierungen im Diagramm.
① SAST-Scan: Findings sammeln und normalisieren
Starten Sie mit SARIF, das Semgrep, CodeQL und die meisten kommerziellen Scanner ausgeben. Deduplizieren Sie über den Fingerprint des Scanners, denn dasselbe Finding taucht auf jedem Branch und bei jedem Lauf wieder auf. Sie wollen einen Datensatz pro Finding, nicht pro Scan. Halten Sie Regel-ID, CWE, Datei, Zeile und Commit fest. Ohne stabile Kennungen lassen sich LLM-Urteile später nicht mit menschlichen Labels verknüpfen. Und filtern Sie hier nicht nach Schweregrad: Ein Harness, das nur „High“-Findings sieht, sagt nichts über die Medium-Findings, die Sie eigentlich unterdrücken wollen.
② Evidenzpaket: dem Richter zeigen, was ein Mensch ansehen würde
Die klarste Lehre aus der Literatur: Kontext schlägt Raffinesse. Die hybriden Verfahren, die bei Tencent funktionierten, lieferten dem Modell den richtigen Code-Ausschnitt und die Pfadbedingungen. Die Prompting-Tricks (Chain-of-Thought, Few-Shot, Bugtyp-Hinweise) brachten meist wenig. Bei ZeroFalse kamen die Gewinne aus Datenflusspfaden und CWE-spezifischen Hinweisen. Bauen Sie das Evidenzpaket so, wie ein erfahrener Reviewer prüfen würde:
- den Code rund um den Sink und die Funktion mit der Source;
- den Source-to-Sink-Pfad des Scanners, falls vorhanden (CodeQL liefert ihn bei Path Queries);
- die CWE-Beschreibung und was sie typischerweise ausnutzbar macht, je Schwachstellenklasse formuliert;
- bekannte Sanitizer, Framework-Defaults und Projektkonventionen (etwa „jedes SQL läuft über diese Repository-Schicht“).
Halten Sie den Builder deterministisch und versioniert, sonst sind Läufe nicht vergleichbar.
③ LLM-Richter: ein strukturiertes, fixiertes Urteil
Fordern Sie Struktur statt Prosa. Ein Urteilsschema, das wir verwenden:
{
  "finding_id": "sarif-fingerprint",
  "verdict": "real | false_positive | unsure",
  "confidence": "high | medium | low",
  "rationale": "zwei bis fünf Sätze",
  "evidence_lines": ["src/api/orders.py:118", "src/db/repo.py:42"],
  "exploit_precondition": "was ein Angreifer bräuchte, oder null"
}
Drei Regeln machen den Richter prüfbar. Fixieren Sie Modellversion, Prompt-Hash und Temperatur und protokollieren Sie sie mit jedem Urteil. Machen Sie „unsure“ zu einer vollwertigen Antwort und routen Sie es wie „real“. Und verlangen Sie, dass die Begründung Zeilennummern zitiert, die im Evidenzpaket existieren. Eine Begründung, die Zeilen zitiert, die das Modell nie gesehen hat, ist ein billiger und wirksamer Halluzinationstest. Wenn Sie mehrfach pro Finding abfragen, speichern Sie jede Antwort; Uneinigkeit ist ein nützliches Signal für geringe Konfidenz.
④ Blinde menschliche Labels: die Ground Truth, die Sie nicht überspringen können
Das ist der teure Schritt, und der, den Teams am häufigsten abkürzen. Wer labelt, darf das LLM-Urteil nicht sehen. Sonst messen Sie Übereinstimmung mit dem Modell, nicht Korrektheit. Setzen Sie zwei Prüfer pro Finding ein und lassen Sie Abweichungen entscheiden, wie es auch Tencents Prozess vorsieht. Labeln Sie „echt“ nur, wenn ein Prüfer die Ausnutzungsvoraussetzung benennen kann. Führen Sie „nicht entscheidbar“ als eigenes Label und lassen Sie es aus den Metriken heraus, statt zu raten.
Teilen Sie den gelabelten Datensatz. Ein Trainings-Split liefert Few-Shot-Beispiele oder „Memories“ für das Evidenzpaket (der gestrichelte Pfeil im Diagramm). Ein Test-Split bleibt für den Prompt unsichtbar. Die Vermischung beider ist der häufigste Weg, auf dem Teams 99 % Genauigkeit melden.
⑤ Auswertung: zählen, was zählt, mit ehrlicher Unsicherheit
Werten Sie den Richter gegen die menschlichen Labels mit einer Konfusionsmatrix aus und berichten Sie je Schwachstellenklasse vier Werte: Anteil entfernter False Positives, Anteil behaltener echter Bugs (Recall), Präzision der verbleibenden Queue sowie Kosten und Latenz pro Finding. Den Recall immer mit Konfidenzintervall, denn die Stichprobe echter Bugs ist stets kleiner als gedacht. Ein minimaler Scorer:
import csv, math

def wilson(k, n, z=1.96):
    if n == 0:
        return (0.0, 1.0)
    p, d = k / n, 1 + z * z / n
    c = (p + z * z / (2 * n)) / d
    h = z * math.sqrt(p * (1 - p) / n + z * z / (4 * n * n)) / d
    return (c - h, c + h)

rows = list(csv.DictReader(open("labelled_findings.csv")))   # finding_id, cwe, llm_verdict, human_label
real = [r for r in rows if r["human_label"] == "real"]
false = [r for r in rows if r["human_label"] == "false_positive"]
kept = sum(r["llm_verdict"] != "false_positive" for r in real)      # "unsure" zählt als behalten
removed = sum(r["llm_verdict"] == "false_positive" for r in false)

lo, hi = wilson(kept, len(real))
print(f"Recall {kept}/{len(real)} = {kept/len(real):.1%} (95-%-KI {lo:.1%}-{hi:.1%})")
print(f"Entfernte False Positives {removed}/{len(false)} = {removed/len(false):.1%}")
print(f"Präzision der Queue {kept/(kept + len(false) - removed):.1%}")
Lassen Sie ihn je CWE und insgesamt laufen. Das CWE-501-Ergebnis von QASecClaw zeigt, dass ein Filter den Durchschnitt verbessern und gleichzeitig eine Klasse verschlechtern kann.
⑥ Routing-Regel: das Recht zum Unterdrücken muss man sich verdienen
Die Routing-Regel macht aus Urteilen Aktionen; die Auswertung legt fest, was sie darf:
Die Nie-unterdrücken-Liste umfasst die Schwachstellenklassen, bei denen ein einziger Fehlgriff für Ihr Produkt inakzeptabel ist: Injection in Interpreter, Umgehung der Authentifizierung, Deserialisierung und alles, was aus dem Internet erreichbar ist. Alles andere kommt infrage, aber erst, wenn die Auswertung für diese Klasse einen Recall über Ihrem Zielwert zeigt. Eine Audit-Stichprobe von 5–10 % der unterdrückten Findings geht laufend zurück ins blinde Labeling. So bemerken Sie Drift, wenn sich Modell, Prompt oder Codebasis ändern.
Was die Zahlen sagen
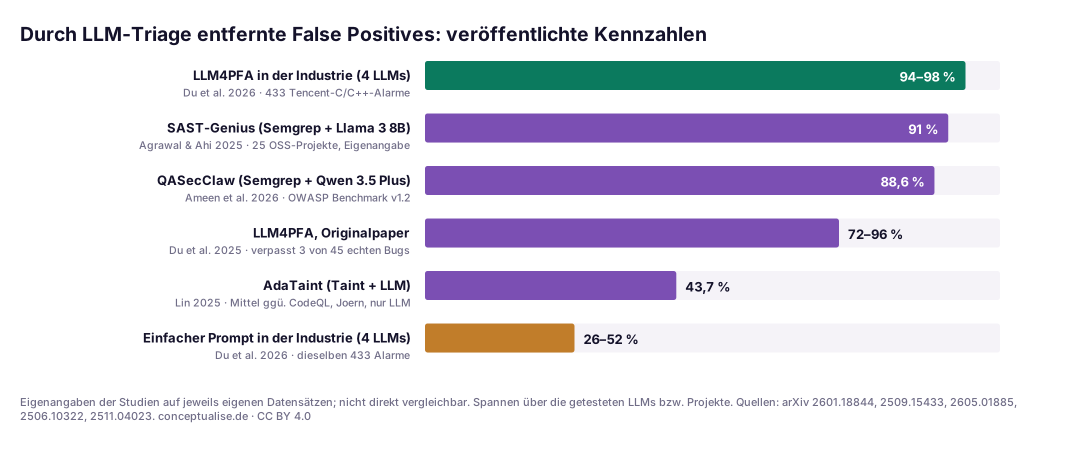
Das ist das Diagramm, das Hersteller zeigen würden, und es stimmt: Jede Studie meldet einen deutlichen Rückgang, die hybriden Verfahren liegen um 90 %. Merken sollten Sie sich den orangefarbenen Balken. Auf demselben Industriedatensatz, auf dem LLM4PFA 94–98 % entfernte, schaffte einfaches Prompting 26–52 %. Wie Sie die Evidenz aufbereiten, zählt mehr als die Wahl des Modells.
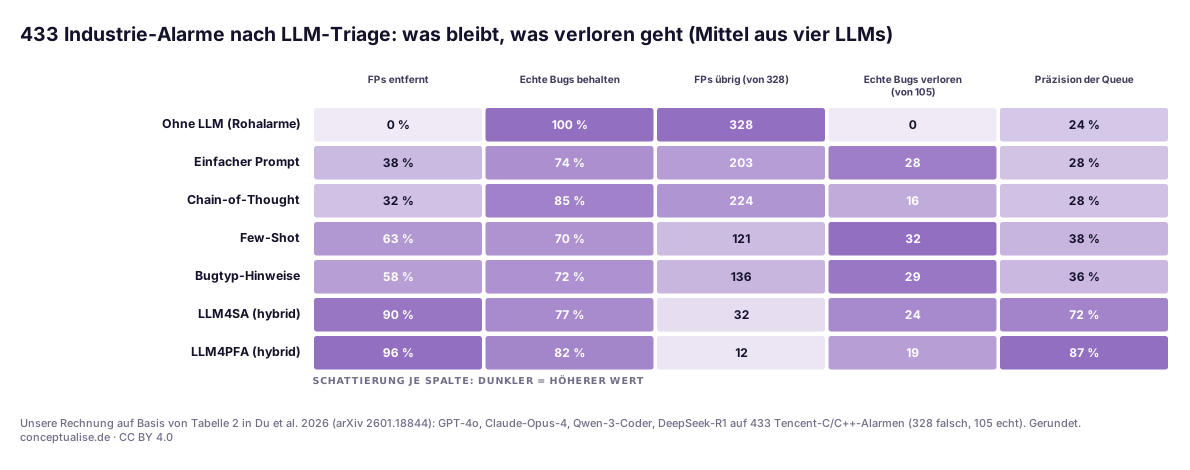
Das ist unsere Rechnung auf Basis von Tabelle 2 der Tencent-Studie, gemittelt über die vier Modelle und gerundet. Neue Daten sind es nicht, aber die veröffentlichten Werte werden so zu der Queue, die Ihre Entwickler tatsächlich sähen. Ohne LLM prüfen sie 433 Alarme, um 105 echte Bugs zu finden: 24 % Präzision. Einfaches Prompting verkleinert die Queue auf etwa 281, hebt die Präzision aber nur auf 28 % und verliert dabei rund 28 echte Bugs. Das ist ungefähr das Schlechteste aus beiden Welten. LLM4PFA verkleinert die Queue auf etwa 98 Alarme bei 87 % Präzision, ein enormer Gewinn für die Arbeitslast. Es verliert aber immer noch rund 19 echte Bugs, fast jeden fünften. Bei 10–20 Minuten pro Alarm spart der Schritt von 433 auf 98 grob 55 bis 110 Prüfstunden. Ob das 19 ungeprüfte echte Bugs wert ist, hängt ganz davon ab, welche Bugs das sind. Deshalb arbeitet die Routing-Regel je Schwachstellenklasse.
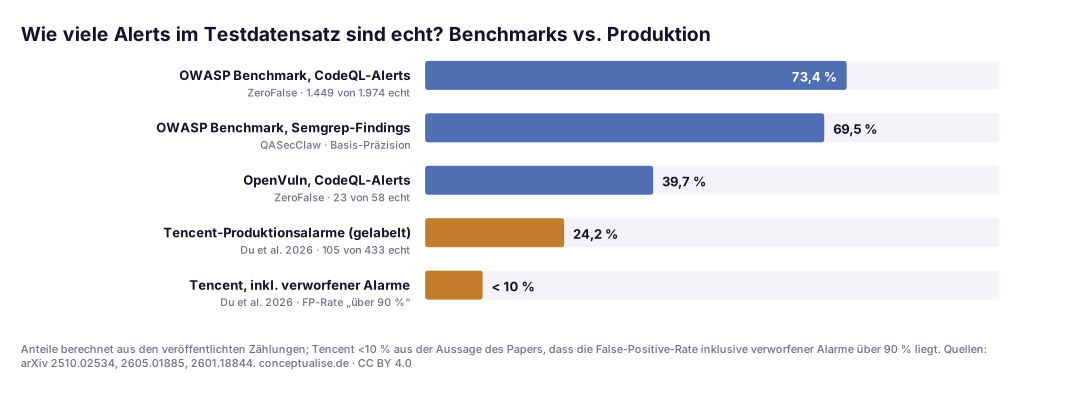
Dieses Diagramm fehlt in den meisten Vergleichen. Präzision und False-Positive-Raten hängen von der Basisrate ab, also davon, wie viele Alerts überhaupt echt sind. Im OWASP Benchmark sind es rund 70 %, weil er zum Testen von Scannern gebaut wurde. In Tencents gelabelten Produktionsdaten waren es 24 %, mit den verworfenen Alarmen unter 10 %. Ein Richter, der auf einem Benchmark mit 70 % echten Alerts glänzt, kann eine Queue liefern, die immer noch überwiegend Rauschen ist, wenn 90 % der Eingaben falsch sind. Deshalb muss das Harness auf Ihren Findings laufen, nicht auf einem Benchmark.
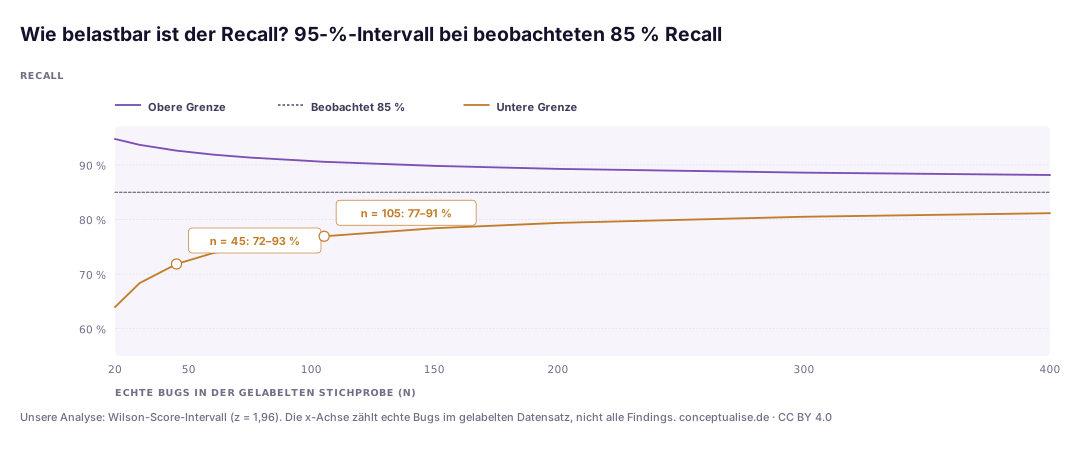
Das letzte Diagramm ist reine Statistik und der Grund, warum Schritt ④ ein Budget braucht. Der Recall wird nur aus Findings geschätzt, die Menschen als echt bestätigen. Bei 45 bestätigten echten Bugs, der Größe des LLM4PFA-Datensatzes, hat ein beobachteter Recall von 85 % ein 95-%-Intervall von etwa 72–93 %. Bei 105, der Größe des Tencent-Datensatzes, sind es etwa 77–91 %. Für ±4 Prozentpunkte brauchen Sie rund 300 bestätigte echte Bugs. Pro Schwachstellenklasse werden Sie selten so viele haben. Die ehrliche Regel ist daher konservativ: Unterdrücken Sie nur in Klassen, in denen selbst die untere Intervallgrenze akzeptabel ist.
Aus einem aktuellen Projekt
Vor Kurzem haben wir für ein europäisches Softwareunternehmen mit großem Java- und TypeScript-Bestand ein Pilotprojekt zur LLM-Triage begutachtet. Das AppSec-Team hatte ein Allzweckmodell mit einem kurzen Prompt an die SAST-Pipeline angeschlossen: „Ist dieses Finding ein False Positive? Antworte mit ja oder nein.“ Das Dashboard zeigte einen kräftigen Rückgang offener Findings, und die Entwickler waren begeistert. Auf dem Tisch lag der Vorschlag, das Modell Findings flächendeckend automatisch schließen zu lassen.
Wir fragten, wie viele der geschlossenen Findings ein Mensch angesehen hatte. Keines, denn genau das Hinsehen sollte ja entfallen. Also labelten zwei ihrer Engineers eine Stichprobe der automatisch geschlossenen Findings blind. Die meisten Schließungen waren korrekt, das Lob der Entwickler war verdient. Die Stichprobe enthielt aber auch echte Injection-Findings, die das Modell mit einer selbstsicheren, plausiblen Begründung geschlossen hatte: Es verwies auf einen Sanitizer, der den betreffenden Sink gar nicht abdeckte. Das Modell hatte keinen Code halluziniert. Es hatte eine wahre Tatsache auf den falschen Pfad angewendet.
Die Lösung war kein anderes Modell. Wir behielten das LLM, ließen es aber beraten statt entscheiden. Aus dem Prompt wurde ein Evidenzpaket mit dem Datenflusspfad des Scanners und CWE-spezifischen Hinweisen. Injection- und Authentifizierungsklassen kamen auf die Nie-unterdrücken-Liste. Unterdrückung gab es nur noch für zwei verrauschte, wenig kritische Regelfamilien, jeweils mit gemessenem Recall und monatlicher Audit-Stichprobe. Die Zufriedenheit der Entwickler blieb hoch, denn Zeit gespart hatte ihnen von Anfang an vor allem die Begründung neben jedem Finding. Das Dashboard hatte offene Findings gemessen, nicht übersehene.
Entscheidungstabelle: was das LLM tun darf
Das ist der Teil für den Screenshot. Beginnen Sie in der obersten Zeile und gehen Sie nur weiter, wenn die Evidenzspalte für die jeweilige Schwachstellenklasse erfüllt ist.
| Modus | Was das LLM tut | Nötige Evidenz | Typischer Einsatz | Hauptrisiko |
|---|---|---|---|---|
| Erklären | Ergänzt jedes Finding um Begründung und Belegzeilen; Menschen entscheiden | Nur eine Plausibilitätsprüfung | Alle Findings, ab Tag eins | Prüfer verlassen sich auf eine falsche Begründung |
| Priorisieren | Sortiert die Queue nach Urteil und Konfidenz; nichts wird ausgeblendet | Recall und Präzision auf gelabelter Stichprobe gemessen | Große Rückstände, verrauschte Regelsätze | Niedrig eingestufte echte Bugs werden nie erreicht |
| Im PR ausblenden, im Backlog behalten | Blendet wahrscheinliche False Positives in PR-Kommentaren aus; AppSec sieht sie weiter | Recall über Ziel für die CWE, untere Intervallgrenze akzeptabel | Klassen mit mittlerem/niedrigem Schweregrad und viel Rauschen | Drift nach Modell- oder Codeänderungen |
| Automatisch schließen | Schließt Findings mit gespeicherter, umkehrbarer Begründung | Alles oben genannte plus laufende Audit-Stichproben und eine verantwortliche Person | Nur enge, gut verstandene Regelfamilien | Stille False Negatives im ausgelieferten Code |
| Nie | Nur beratend, unabhängig von den Werten | entfällt | Injection, Auth-Umgehung, Deserialisierung, Krypto-Fehlgebrauch, internetexponierte Pfade | entfällt |
Und die Checkliste, die wir abarbeiten, bevor ein Modus jenseits von „Erklären“ live geht:
- Findings sind dedupliziert und tragen stabile IDs, die Urteile und Labels verknüpfen.
- Der gelabelte Datensatz hat einen zurückgehaltenen Test-Split, den Prompt und Beispiele nie berührt haben.
- Labels entstehen blind zum LLM-Urteil, mit zwei Prüfern und Konfliktentscheidung.
- Der Recall wird je CWE mit 95-%-Intervall berichtet, auf Basis von insgesamt mindestens 100 bestätigten echten Bugs.
- Modellversion, Prompt-Hash, Temperatur und Version des Evidenzpakets werden mit jedem Urteil protokolliert.
- „Unsure“ geht an Menschen, und Begründungen werden auf existierende Zeilennummern geprüft.
- Es gibt eine Nie-unterdrücken-Liste, die AppSec verantwortet und quartalsweise überprüft.
- Monatlich wird eine Audit-Stichprobe von 5–10 % der unterdrückten Findings gelabelt und der Recall darauf neu berechnet.
- Jede Unterdrückung ist umkehrbar und durchsuchbar, damit sich ein späterer Vorfall auf die Entscheidung zurückführen lässt.
- An das Modell gesendeter Quellcode bleibt innerhalb Ihrer vertraglichen und Datenresidenz-Grenzen.
Governance für europäische Unternehmen
LLM-Triage schafft kein neues Regulierungsregime. Sie verändert, wie Sie bestehende Pflichten nachweisen.
Cyber Resilience Act. Die Verordnung (EU) 2024/2847 verlangt, dass Produkte mit digitalen Elementen ohne bekannte ausnutzbare Schwachstellen auf dem Markt bereitgestellt werden (Anhang I Teil I). Hersteller müssen Schwachstellen ermitteln, dokumentieren und unverzüglich beheben (Anhang I Teil II). Die Pflichten gelten vollständig ab dem 11. Dezember 2027; die Meldepflicht nach Artikel 14 für aktiv ausgenutzte Schwachstellen und schwerwiegende Vorfälle gilt bereits seit dem 11. September 2026. Ein SAST-Finding, das Ihr Scanner erkannt und ein LLM unterdrückt hat, ist im Nachhinein eine Schwachstelle, von der Sie wussten. Wird sie später ausgenutzt, wollen Sie die Begründung der Unterdrückung, die Regel, die sie erlaubt hat, und die Recall-Messung dahinter vorlegen können. Unser CRA-Meldeleitfaden für 24/72 Stunden beschreibt, was danach passiert.
NIS-2. Artikel 21 Absatz 2 Buchstabe e der Richtlinie (EU) 2022/2555 verlangt von wesentlichen und wichtigen Einrichtungen Sicherheitsmaßnahmen bei Erwerb, Entwicklung und Wartung von Netz- und Informationssystemen, einschließlich Management und Offenlegung von Schwachstellen. Prüfer akzeptieren Automatisierung. Sie akzeptieren keine Kontrolle, die niemand misst. Die Ausgabe des Harness, Recall je Klasse mit Prüfpfad, ist der Nachweis.
KI-Verordnung. Ein Werkzeug, das Ihre eigenen SAST-Findings triagiert, ist kein Hochrisiko-KI-System: Schwachstellen-Triage gehört nicht zu den Anwendungsfällen in Anhang III. Die Pflichten für KI-Modelle mit allgemeinem Verwendungszweck liegen beim Modellanbieter, nicht bei Ihnen als Nutzer. Für Sie zählt praktisch die KI-Kompetenz nach Artikel 4, die seit dem 2. Februar 2025 gilt: Wer sich auf die Urteile verlässt, muss deren Grenzen kennen.
DSGVO und Vertraulichkeit. Repositories enthalten Zugangsdaten, Testdaten und Kommentare mit Namen. Evidenzpakete an ein externes Modell zu senden, ist eine Verarbeitungs- und Vertraulichkeitsentscheidung: Prüfen Sie Auftragsverarbeitungsbedingungen und Aufbewahrung des Anbieters, nutzen Sie EU-gehostete Endpunkte, wo Ihre Richtlinien es verlangen, und entfernen Sie Secrets vorher.
Ein pragmatischer Einführungspfad
- Wochen 1–2: „Erklären“ einschalten und mit dem Labeln beginnen. Ergänzen Sie Findings um LLM-Begründungen, ohne einen Ablauf zu ändern. Parallel labeln zwei AppSec-Engineers blind eine geschichtete Stichprobe aktueller Findings. Ziel: mindestens 100 bestätigte echte Bugs über Ihre wichtigsten Schwachstellenklassen.
- Wochen 3–4: Evidenzpaket und Auswertung bauen. Geben Sie Datenflusspfade des Scanners und CWE-spezifische Hinweise in den Prompt. Lassen Sie das Harness auf dem zurückgehaltenen Split laufen und berechnen Sie den Recall je Klasse mit Intervall. Vergleichen Sie Ihren Prompt auf denselben Daten mit der eingebauten Triage des Herstellers. Unser Leitfaden zu Evaluations-Harnesses für KI-Agenten vertieft die Auswertungstechnik.
- Monat 2: „Priorisieren“, dann „Im PR ausblenden“ für zwei verrauschte Klassen. Wählen Sie die beiden Regelfamilien mit den meisten False Positives und der geringsten Tragweite und blenden Sie sie nur in PR-Kommentaren aus. Im Backlog bleiben sie. Schreiben Sie die Nie-unterdrücken-Liste und übergeben Sie sie AppSec.
- Monat 3: Audit-Schleife und Änderungssteuerung. Starten Sie die monatliche Audit-Stichprobe. Behandeln Sie jeden Wechsel von Modell, Prompt oder Evidenzpaket als Release, das das Harness erneut bestehen muss, so wie Sie eine geänderte Scanner-Regel in Ihrer DevSecOps-Pipeline absichern würden.
- Quartalsweise: ausweiten oder zurücknehmen. Nehmen Sie Klassen nur in die Unterdrückung auf, wenn ihre untere Recall-Grenze Ihr Ziel erreicht, und nehmen Sie sie heraus, wenn Audits Drift zeigen. Berichten Sie die Zahlen neben Ihren SBOM- und VEX-Kennzahlen; unser Leitfaden zum SBOM- und VEX-Betrieb wendet dieselbe Trichterlogik auf CVEs in Abhängigkeiten an. Wenn KI-Agenten den gescannten Code schreiben, kombinieren Sie das mit KI-Coding-Agenten im SDLC absichern.
Das Fazit
Können LLMs SAST-Findings triagieren? Ja, besser als die Skeptiker erwartet haben, und weniger sicher, als die Hersteller nahelegen. Die Evidenz aus 2026 zeigt: Ein Modell mit präzisem Code-Kontext entfernt die meisten False Positives für Sekunden und Cent-Beträge pro Finding, und seine Erklärungen verkürzen die menschliche Prüfung deutlich. Das ist ein echter Produktivitätsgewinn. Wer ihn ablehnt, bezahlt Engineers dafür, Rauschen zu lesen.
Dieselbe Evidenz zeigt aber auch: Jede Konfiguration verliert echte Bugs, und dieser Verlust bleibt unsichtbar, solange Sie nur messen, was entfernt wurde. Unsere Position ist einfach. Lassen Sie LLMs ab sofort jedes Finding erklären und priorisieren. Unterdrücken dürfen sie nur dort, wo Sie den Recall auf eigenem gelabeltem Code gemessen haben, je Schwachstellenklasse, mit Konfidenzintervall und Audit-Stichprobe. Und niemals in den Klassen, die später in einem Vorfallbericht stehen würden. Das Modell ist nicht der schwierige Teil. Die gelabelten Daten und die Routing-Regel sind es, und genau danach wird ein Prüfer fragen.
Wenn Sie Unterstützung beim Aufbau des Harness oder bei der Bewertung eines Triage-Piloten möchten, bietet unser DevSecOps-Team das als kurzes Projekt mit festem Umfang an. Sie erhalten gelabelte Daten, Recall je Klasse und eine Routing-Regel, die Sie verteidigen können.
FAQ
Kann ein LLM zuverlässig entscheiden, ob ein SAST-Finding ein False Positive ist?
Allein nicht, und nicht ohne Messung. In einer Industriestudie bei Tencent aus dem Jahr 2026 entfernte einfaches Prompting nur 26–52 % der False Positives und verlor dabei 16–38 % der echten Bugs. Das beste hybride Verfahren, das dem Modell präzisen Code-Kontext und Pfadbedingungen liefert, entfernte 94–98 % der False Positives, behielt aber nur 75–88 % der echten Bugs, unter den 90 % Recall, die die Autoren als Erwartung des Unternehmens nennen. Nutzen Sie das LLM zum Erklären und Priorisieren, und lassen Sie es nur dort unterdrücken, wo Sie den Recall auf eigenen gelabelten Daten gemessen haben.
Wie stark reduzieren LLMs SAST-False-Positives in veröffentlichten Studien?
Die veröffentlichten Werte liegen zwischen etwa 26 % und 98 %, stark abhängig von Verfahren und Datensatz. Die Tencent-Studie meldet 94–98 % für ihr bestes hybrides Verfahren, QASecClaw 88,6 % auf dem OWASP Benchmark, SAST-Genius rund 91 % auf 25 Open-Source-Projekten und LLM4PFA 72–96 %. Das sind Eigenangaben auf unterschiedlichen Datensätzen mit unterschiedlichen Basisraten. Direkt vergleichbar sind sie nicht, und keiner der Werte ist eine Prognose für Ihre Codebasis.
Was ist das größte Risiko, wenn KI die Ergebnisse statischer Analyse triagiert?
Stille False Negatives. Stuft ein LLM eine echte Schwachstelle als False Positive ein und wird das Finding automatisch geschlossen, schaut niemand mehr hin. Schlagzeilen über reduzierte False Positives verschweigen diese Kosten. Jede Studie, die beide Seiten berichtet, zeigt einen Verlust echter Bugs, am größten bei einfachem Prompting. Messen Sie den Recall mit Konfidenzintervall, führen Sie eine Nie-unterdrücken-Liste für kritische Schwachstellenklassen und prüfen Sie Stichproben der unterdrückten Findings.
Wie viele gelabelte Findings brauchen wir, um ein LLM-Triage-Werkzeug zu bewerten?
Zählen Sie echte Bugs, nicht Findings. Der Recall wird nur aus Findings geschätzt, die Menschen als echt bestätigen; davon hängt die Unsicherheit ab. Bei 45 echten Bugs und beobachteten 85 % Recall reicht das 95-%-Wilson-Intervall von etwa 72 % bis 93 %. Bei 105 echten Bugs sind es etwa 77–91 %, und für ±4 Prozentpunkte brauchen Sie rund 300. Starten Sie mit mindestens 100 bestätigten echten Findings über die Schwachstellenklassen, die Ihnen wichtig sind.
Ersetzen KI-Triage-Funktionen von Anbietern wie Semgrep oder Datadog diese Bewertung?
Nein. Semgrep dokumentiert seine KI-Rauschfilterung als zu über 95 % genau bei der Einstufung von Findings als False Positive, und Datadog hat seinen Bits-AI-Filter auf dem OWASP Benchmark evaluiert. Keine der Seiten beschreibt die Methode so genau, dass sich das Ergebnis auf Ihren Code übertragen ließe. Behandeln Sie Herstellerangaben als Richtwert. Lassen Sie dasselbe Harness gegen die Herstellerfunktion und Ihren eigenen Prompt laufen, auf Ihren eigenen gelabelten Findings, und vergleichen Sie zuerst den Recall.
Entstehen durch LLM-Triage von Schwachstellen Pflichten nach EU-Recht?
Das Triage-Werkzeug selbst ist kein Hochrisiko-KI-System nach der KI-Verordnung; es fällt unter keinen Anwendungsfall in Anhang III. Die relevanten Pflichten ergeben sich aus dem, was Sie bauen. Der Cyber Resilience Act verlangt, dass Produkte mit digitalen Elementen ohne bekannte ausnutzbare Schwachstellen bereitgestellt werden und Schwachstellen dokumentiert behandelt werden; die Meldepflichten nach Artikel 14 gelten seit dem 11. September 2026. NIS-2 Artikel 21 Absatz 2 Buchstabe e umfasst die Schwachstellenbehandlung in der Entwicklung. Unterdrückt ein LLM ein echtes Finding, müssen Sie zeigen können, wie diese Entscheidung zustande kam und geprüft wurde.
Quellen
Alle Quellen geprüft am 15. November 2026. Als „unsere Rechnung“ oder „unsere Analyse“ gekennzeichnete Werte in den Diagrammen sind aus den zitierten Zahlen oder mit Standardstatistik abgeleitet; für diesen Beitrag haben wir kein Modell ausgeführt.
Stufe A: Primärdaten, Standards und Regulierung
- Du et al., „Reducing False Positives in Static Bug Detection with LLMs: An Empirical Study in Industry“ (arXiv:2601.18844, 26. Jan. 2026): https://arxiv.org/abs/2601.18844
- Verordnung (EU) 2024/2847 (Cyber Resilience Act), Anhang I und Artikel 14: https://eur-lex.europa.eu/eli/reg/2024/2847/oj/deu
- Richtlinie (EU) 2022/2555 (NIS-2), Artikel 21: https://eur-lex.europa.eu/eli/dir/2022/2555/oj/deu
- Verordnung (EU) 2024/1689 (KI-Verordnung), Artikel 4 und Anhang III: https://eur-lex.europa.eu/eli/reg/2024/1689/oj/deu
- OWASP Benchmark Project: https://owasp.org/www-project-benchmark/
Stufe B: Forschung
- Iranmanesh et al., „ZeroFalse: Improving Precision in Static Analysis with LLMs“ (arXiv:2510.02534): https://arxiv.org/abs/2510.02534
- Ameen, Alam und Islam, „QASecClaw: A Multi-Agent LLM Approach for False Positive Reduction in SAST“ (arXiv:2605.01885): https://arxiv.org/abs/2605.01885
- Du et al., „Minimizing False Positives in Static Bug Detection via LLM-Enhanced Path Feasibility Analysis“ (arXiv:2506.10322): https://arxiv.org/abs/2506.10322
- Agrawal und Ahi, „LLM-Driven SAST-Genius“ (arXiv:2509.15433): https://arxiv.org/abs/2509.15433
- Chen et al., „Utilizing Precise and Complete Code Context to Guide LLM in Automatic False Positive Mitigation“ (arXiv:2411.03079): https://arxiv.org/abs/2411.03079
- Lin, „LLM-Driven Adaptive Source-Sink Identification and False Positive Mitigation for Static Analysis“ (arXiv:2511.04023): https://arxiv.org/abs/2511.04023
- Ullah et al., „LLMs Cannot Reliably Identify and Reason About Security Vulnerabilities (Yet?)“, IEEE S&P 2024 (arXiv:2312.12575): https://arxiv.org/abs/2312.12575
- Ding et al., „Vulnerability Detection with Code Language Models: How Far Are We?“, ICSE 2025 (arXiv:2403.18624): https://arxiv.org/abs/2403.18624
- GitHub Security Lab, „AI-supported vulnerability triage with the GitHub Security Lab Taskflow Agent“ (20. Jan. 2026): https://github.blog/security/ai-supported-vulnerability-triage-with-the-github-security-lab-taskflow-agent/
Stufe C: Hersteller und Kommentare, Richtwerte
- Semgrep-Dokumentation, KI-gestützte Triage und Rauschfilterung: https://docs.semgrep.dev/semgrep-assistant/overview
- Datadog, „Using LLMs to filter out false positives from static code analysis“ (28. Okt. 2025): https://www.datadoghq.com/blog/using-llms-to-filter-out-false-positives/
- InfoWorld, „How pairing SAST with AI dramatically reduces false positives in code security“ (20. Nov. 2025): https://www.infoworld.com/article/4093079/how-pairing-sast-with-ai-dramatically-reduces-false-positives-in-code-security.html
Themen